EvoArena:评估AI智能体在动态环境中的持续适应能力
EvoArena提出动态环境评测框架,揭示顶级AI智能体在追踪环境变化时的严重短板,并以类Git补丁记忆方法EvoMem加以改善。
新加坡国立大学团队提出EvoArena,填补了现有AI智能体评测长期假设静态环境的盲区。研究构建了三大动态场景——终端工作流、软件代码库演变与用户偏好追踪,系统考察智能体在环境持续变化下的感知与适应能力。测试结果显示,即使GPT-5.5等顶级模型,单步准确率也仅50%出头,完整演变链条的通过率不足30%,Token用量增加亦无法带来准确率提升。针对这一缺陷,团队提出EvoMem方法,借鉴Git差异机制以补丁方式存储记忆状态变化而非覆盖旧信息,在Chain Level和降低代码回归率上均取得显著提升,为动态环境下的智能体记忆管理提供了新思路。
当软件版本迭代、终端工作流调整或用户偏好持续变化时,AI智能体能否及时更新自己的知识与策略,而不是继续沿用已经过时的经验?这是新加坡国立大学博士生徐迅东团队提出的EvoArena所要回答的核心问题。在NICE论文分享会上,这项工作揭示了一个被现有智能体评测长期忽视的盲区——环境本身的演变。
静态评测的盲区:环境一直在变
传统大模型评估关注的是「一次函数调用」:输入一个query,输出一个答案,评估模型能否理解prompt并生成正确结果。但当大模型作为智能体(Agent)与外部环境交互时,情况变得复杂得多。
研究者指出,智能体的行为是「模型、工具、记忆与环境状态共同作用的结果」。这意味着即便模型本身没有变、工具和记忆没有变、甚至任务指令都没变,只要环境发生了改变,智能体的最终行为也会随之变化。
问题在于,现有主流评测大多假设一个静态环境。无论是Web Arena的固定网页Docker环境、SWE-Bench的固定代码仓库,还是Gaia、TerminalBench,它们的环境在评测过程中都是不变的。而真实世界里,文件、API、用户偏好都在持续演变。EvoArena正是为了填补这一评测缺口而生。
Web Arena、SWE-Bench等主流智能体评测基准的设计逻辑值得进一步了解。Web Arena将目标网站(如购物、论坛、代码托管)打包成固定的Docker镜像,确保每次评测时网页内容完全一致;SWE-Bench则从真实GitHub仓库中抽取Issue-PR对,以固定代码快照作为测试环境。这种「冻结环境」的设计初衷是保证评测的可复现性与公平对比——所有模型面对完全相同的环境状态,结果才具可比性。然而这一设计隐含了一个关键假设:模型在部署时所面对的环境与评测环境一致。现实中这一假设往往不成立:网站会改版、依赖库会升级、用户习惯会迁移。正是这个假设的裂缝,催生了EvoArena的研究动机。
三个概念的辨析:为什么是「环境演变」
徐迅东特别澄清了社区中容易混淆的三个概念。第一类是「Dynamic Task」,如SWE-Bench的部分变体,其「动态」指的是每次评测时动态生成新问题以防止数据污染;第二类是「Agent Evolution」,即智能体自进化,关注智能体能否通过交互或反思不断改进自身能力。
而EvoArena关注的既不是动态生成任务,也不是智能体自进化,而是「环境演变」(Environment Evolution)——在环境持续变化的前提下,考察现有智能体的表现。
一个优秀的动态环境benchmark应当测试三种能力:环境的持续演变(同一setting下有多个细微变化的版本)、版本适应能力(智能体感知变化后能否调整行为)、以及链式可靠性(能否追踪一系列环境变化并连续完成任务,而非孤立地完成一个个独立任务)。用一句话概括:EvoArena测的是智能体能否发现环境变化,并调整自身行为去适应它。
「智能体自进化(Agent Evolution)」是近年来强化学习与大模型交叉领域的热点研究方向,代表性工作包括让智能体通过自我对弈、反思失败轨迹或合成训练数据来迭代提升自身能力(如Voyager、SELF-REFINE等)。这类研究的核心问题是「智能体如何变得更强」,优化目标是智能体的策略或参数本身。EvoArena的出发点则完全不同:它不改变智能体,而是改变环境,观察现有智能体在面对陌生的新环境状态时是否能感知到变化并相应调整行为。这一区分在实验设计上非常重要——EvoArena的评测对象是智能体的「环境感知与适应能力」,而非「自我改进能力」,因此可以用于公平评估任何现有智能体框架,无需对其内部机制做任何修改。
三大场景:从终端到代码库再到个性化对话
EvoArena选取了社区关注度较高的三类场景构建动态环境。
Terminal-Bench Evolve:工作流场景
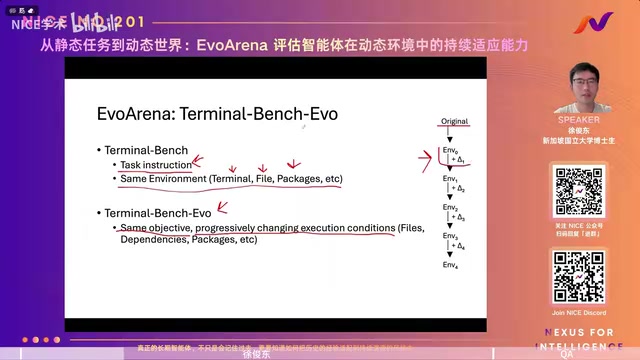
基于Terminal-Bench改造,做法是保持每个任务的目标不变,但不断修改执行条件。例如原任务是把hello.html部署到8080端口,随后每一次演变都改变执行条件:加入hook和retry机制、写死部署路径、修改用户或用户组权限、变更路径等。每个任务因此衍生出environment 0到4共五个环境状态,考察智能体在一系列执行条件变化下能否稳健地完成部署目标。
SWE-Chain Evolve:软件工程场景
环境即代码仓库本身。研究者从丰富的GitHub仓库中收集数据,将相近的commit分组为「milestone」,以milestone而非单个commit作为演变单位——因为真实仓库中一个完整feature往往被拆成多个连续commit,milestone能更好地代表一次完整的功能演变。
评估采用fail-to-pass和pass-to-pass两个指标:前者衡量智能体能否实现新milestone提出的新功能(旧版本fail、新版本pass),后者衡量在实现新需求时能否不破坏旧版本已实现的功能。这直接考验智能体追踪代码库演变的能力。
Persona-Mem Evolve:社会智能场景
这是一个长文本多轮对话场景,环境即用户在对话中不断演变的偏好。研究者从Persona Hub收集seed persona,扩充为结构化profile,再让大模型隐式地把偏好展现在对话中——而非直接告知。例如用户一开始喜欢喝咖啡,随后变为只在周一早上喝咖啡,再演变为周中早上喝茶,周末喝卡布奇诺。
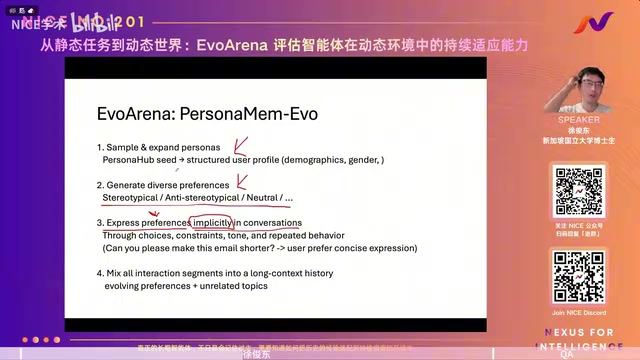
研究者将语义相似度70%以上的偏好定义为连续演变,并拼接成长上下文对话历史,同时加入无关话题作为干扰项。要给出准确推荐,智能体必须追踪偏好的完整变化链条,理解每个偏好适用的条件、时间与对象。
惨淡的成绩单:最强模型也力不从心
研究者用各场景下当时最强的智能体框架(Terminus 2、OpenHands、Agentic Memory)搭配GPT-5.5、GLM-5.1、Gemini-3.1 Pro等顶级模型进行测试,评估Step Level(单个milestone独立评估)和Chain Level(完整演变链条全部做对才算通过)两个维度。
结果并不乐观。Step Level最高的GPT-5.5也只有50%出头的准确率;Chain Level则更低,表现最好的Gemini-3.1 Pro和GLM-5.1也只有约28%-29%。Chain Level显著低于Step Level,因为前者需要在完成新需求的同时不破坏历史演变,任务设定本身更难。这清晰地表明,当前最强的智能体在动态环境追踪上做得并不好。
EvoMem:用类Git的补丁记忆追踪环境变化
针对这一缺陷,团队提出了EvoMem方法。一个直观的疑问是:为什么不直接更新智能体的记忆?答案在于动态环境下知识是「环境依赖」的——旧信息在旧环境有用,新信息在新环境有用。现有记忆系统总是用最新状态覆盖旧记忆,一旦切换回旧环境,当时有效的记忆已被覆盖,效果自然下降。
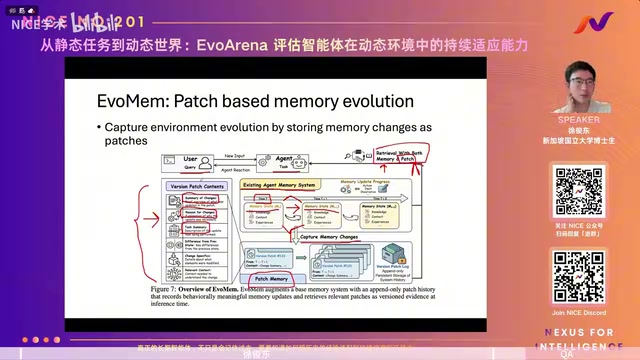
EvoMem采用类似Git diff的思路,捕捉记忆不同状态之间的变化。它会存储前后状态、变更摘要(summary of changes)、变更原因(智能体基于交互上下文的推断)以及触发变更的任务等字段。
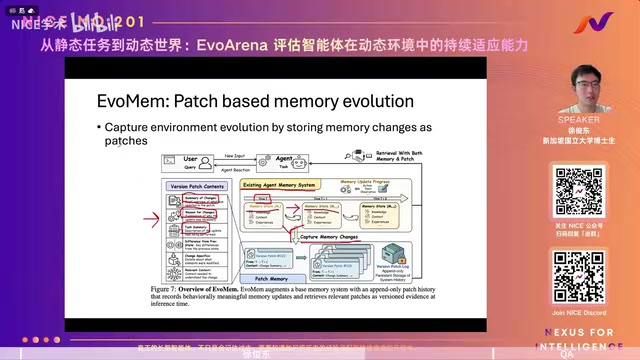
当新任务到来时,智能体既从原始base memory检索,也从patch memory检索历史变化信息,从而在动态环境中保留更多环境演变的线索。
主实验显示,各基线智能体加入EvoMem后普遍提升,且Chain Level提升明显大于Step Level:Terminal场景Chain Level提升约6个百分点(Step Level仅2.4%),SWE场景提升2个百分点,Persona-Mem场景提升3.2个百分点。这说明EvoMem对追踪环境变化、连续完成演变任务尤为有效。
有趣的是,EvoMem在Gaia、Locomo等传统「静态」benchmark上同样有效。研究者分析认为,这些长程任务中智能体多轮交互本身也会改变环境状态(如调用搜索引擎带来新信息),因此仍可被视为一种环境演变。
Git的差异(diff)机制是理解EvoMem设计思路的关键类比。在Git版本控制中,每次提交并不保存文件的完整副本,而是记录相对于上一版本的「补丁(patch)」——即哪些行被增加、哪些行被删除。这样既节省存储,又能精确还原任意历史版本或在版本间来回切换。EvoMem将同样的思路引入智能体记忆管理:与其在每次环境变化时用新状态覆盖旧记忆(相当于只保留最新文件副本),不如显式记录「从状态A变化到状态B发生了什么」。这种增量式记忆结构使智能体既能访问当前环境知识,也能回溯历史变化,在需要处理旧版本环境或理解变化脉络时不会因为旧信息被覆盖而失去依据。这也是EvoMem在「环境回滚」场景下天然有效的根本原因。
深入分析与未来方向
研究者对EvoMem在三个场景的有效性做了细致拆解:Terminal场景中,patch被真正检索到、被用在智能体轨迹中、被用在实际命令行时,准确率均更高;软件工程场景中,EvoMem将Regression(破坏旧功能)比例从约9%显著降低;Persona-Mem场景中,EvoMem在粗粒度(cross level)和细粒度(row level)偏好证据保存上都优于基线记忆。
一个引人深思的发现是Token使用量与准确率的关系:GPT-5.5生成大量Token,但准确率未必优于生成更少Token的GLM-5.1或Gemini-3.1 Pro。这暗示当前的Scaling方式并未真正解决动态环境追踪问题。
在问答环节,徐迅东也坦承了方法的局限。随着交互轮次增加、补丁越来越多,如何高效检索将成为瓶颈——他认为纯语义相似度检索可能不够,未来需要建模环境结构或借鉴因果图检索等思路。对于环境回滚,EvoMem因存储了状态间变化而天然有效;但新旧规则冲突时,则需要智能体基于条件和更强的推理能力去判断该调用哪个版本的记忆。
EvoMem目前仍是一个相对通用、简单的方法,它为提升智能体在动态环境中的表现迈出了第一步。研究者认为,记忆是追踪动态环境的绝佳接口,而如何更好地捕捉变化、如何超越语义相似度做检索,将是值得投入的重要方向。
相关推荐
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。