Fable 5.2 与 Opus 5.5 成本对决:单位任务成本更低
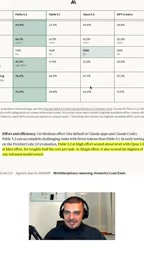
Fable 5.2单价虽为Opus 5.5两倍,但每任务成本仅约一半,选型应看综合成本。
文章围绕Fable 5.2与Opus 5.5的定价争议展开,指出单位token单价高并不等于实际使用更贵。官方数据显示,Fable 5.2在高努力等级下的得分与Opus 5.5最高努力等级相当,而每任务成本仅约后者一半。每任务成本受模型效率和成功率影响,比单价更能反映真实开销。文章建议开发者在选型时结合具体任务进行小规模对比测试,关注完成质量、所需轮次和总token消耗,而非仅比较价目表数字。同时提醒官方评测条件和任务分布尚未明确,结论需结合实测验证。
当性能提升遇上成本翻倍:表面的矛盾
最近,AI 模型社区围绕 Fable 5.2 与 Opus 5.5 的定价展开了讨论。根据 YouTube 频道在视频中展示的官方对比数据,Fable 5.2 在单位 token 定价上是 Opus 5.5 的两倍。如果只看这个数字,很容易得出“性能更好但更贵”的结论,这在一定程度上是正确的。
然而,单位 token 成本只是衡量模型经济性的一个维度。对于实际使用者而言,更关键的指标往往是完成一项具体任务需要花多少钱。官方数据在这一点上给出了截然不同的故事。
每任务成本:被忽视的效率指标
视频中明确指出,上述对比并非基于每 token 成本,而是每任务成本。这是一个重要的区分。一个模型即使单 token 价格更高,只要它能用更少的 token 或更快的速度完成任务,最终的单任务开销就可能更低。
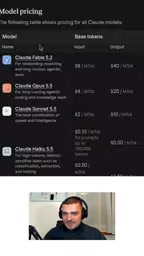
Fable 5.2 恰好展示了这种可能性。官方宣称,在“高”努力等级下,Fable 5.2 的得分与“最高”努力等级的 Opus 5.5 相当,而每任务成本仅为后者的大约一半。这意味着,对于需要高质量输出的任务,选择 Fable 5.2 可能同时获得更好的性能和更低的费用。
努力等级(Effort Level) 是部分大模型服务商引入的推理控制参数,通常分为低、中、高、最高等档位。其机制是通过调整模型在生成回答前的“思考”预算——例如允许的内部推理步数、采样宽度或工具调用次数——来在质量与开销之间取舍。努力等级越高,模型越倾向于多轮自我检查与探索,输出质量可能提升,但消耗的 token 和延迟也随之增加。因此,比较不同模型时,必须对齐努力等级:一个模型在“高”档位的表现,可能对应另一模型“最高”档位的水平,这正是 Fable 5.2 与 Opus 5.5 对比中的关键前提。
每任务成本(Cost per Task) 指完成一个端到端任务所需的全部费用,计算方式为任务消耗的总 token 数(含输入、输出及中间推理 token)乘以单价。与每 token 单价不同,它把模型的效率纳入了考量:若模型能用更少的轮次、更简洁的中间步骤或更高的首次成功率完成任务,即使单价较高,总开销也可能更低。该指标更贴近开发者的实际账单,但依赖具体任务分布,不同任务类型下波动较大。
官方声明:高努力等级即可匹敌最高努力
这一结论的核心依据来自官方对比页面。据视频引述,Fable 5.2 在高努力设置下的表现已经达到 Opus 5.5 在最大努力设置下的水平,而成本却显著更低。
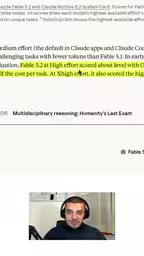
需要说明的是,这里的“得分”具体指向哪种评测基准、任务类型如何界定,原始素材并未展开。因此,这一结论应理解为官方在特定测试条件下的宣称,而非在所有场景下都必然成立的绝对规律。
评测基准(Benchmark) 是衡量模型能力的标准化测试集,如 MMLU、HumanEval、GSM8K 等,通常由固定题目和评分规则构成。官方对比中“得分相当”的说法,必须结合具体基准来理解:不同基准考察的能力维度不同(知识问答、代码生成、数学推理等),模型在不同基准上的相对优势也可能反转。此外,基准题目可能被模型训练数据覆盖,导致得分虚高。因此,看到“得分相当”时,应追问是哪个基准、是否公开、是否与真实任务分布匹配,才能判断结论的可迁移性。
如何理解每任务成本的优势
每任务成本的优势可以从两个角度理解。其一是效率:模型可能通过更少的交互轮次或更简洁的中间步骤完成任务。其二是成功率:如果模型一次就能正确完成任务,避免了重试带来的额外开销,整体成本自然下降。视频中的分析正是强调,Fable 5.2 在效率层面的表现使其即便单价更高,仍然在任务层面更便宜。
对于开发者和团队来说,这意味着选型时不能只比较 API 价目表上的数字。更合理的做法是结合自身任务类型,评估模型的实际完成效率和成功率,再计算综合成本。
首次成功率(First-pass Success Rate) 指模型在无需人工纠正或重试的情况下一次完成任务的比例。在多轮交互场景中,失败重试会成倍增加 token 消耗和延迟,因此首次成功率对每任务成本的影响可能超过单价差异。一个单价稍高但一次做对的模型,其综合成本往往低于单价低但频繁出错的模型。评估时可通过小规模测试统计首次通过率,并结合重试成本折算为期望开销,从而更准确地比较不同模型的真实经济性。
选型建议与待解问题
基于现有信息,Fable 5.2 在成本效益上展现出了有吸引力的定位:用高努力等级换取与竞品最高努力等级相当的性能,同时降低单任务支出。但仍有几个问题值得进一步观察:官方数据所依据的具体评测集和任务分布并未在素材中说明;每任务成本在不同任务复杂度下的波动范围也未知。
在实际决策时,建议先用代表性任务进行小规模对比测试,重点关注完成质量、所需轮次和总 token 消耗,而不仅仅盯着单价。只有这样,才能判断 Fable 5.2 的每任务成本优势是否适用于你的具体场景。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。