Fable 5引发热议:AI推理能力真的在下降吗?

Hacker News热议AI模型推理能力在八月出现下滑,折射出用户对闭源模型透明监测的迫切需求。
一条关于「Fable 5」项目的推文在Hacker News引发热议,核心议题是大语言模型的推理中位数水平在八月出现可观测的下滑。文章梳理了模型表现波动的三类主要成因:服务商为控制算力成本而压缩思维链推理或路由至轻量模型;评测方法本身的噪声导致指标非本质性波动;以及安全对齐微调带来的「对齐税」副作用。讨论的深层意义在于揭示了一个结构性缺口——当关键工作流日益依赖闭源模型,用户对黑盒表现波动的容忍度正在降低,而可持续的第三方监测机制却严重不足。文章建议普通用户理性看待单月单指标数据,并通过建立个人小规模基准测试来主动检验所依赖模型的稳定性。
一条推文引发的社区讨论
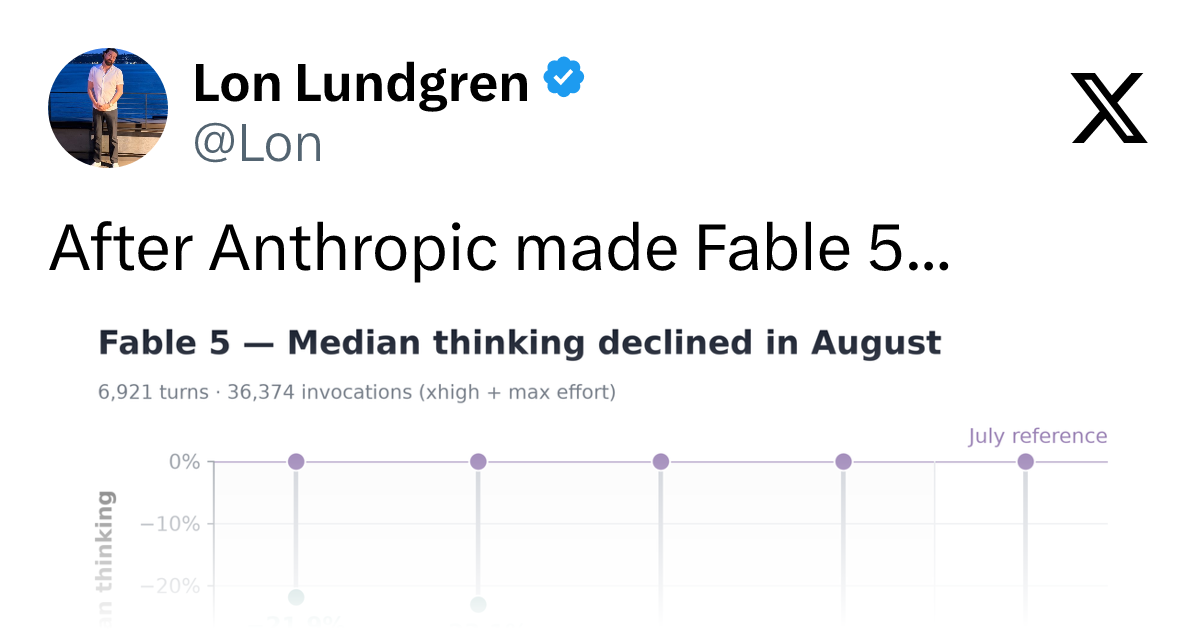
近日,一则关于「Fable 5」的话题在 Hacker News 上迅速升温,累计获得 234 个点赞和超过 150 条评论。该讨论源自一条推文,核心观点直指一个耐人寻味的现象——「Median thinking declined in August」(推理能力的中位数水平在八月出现下滑)。
这一话题之所以能引发广泛关注,在于它触及了当前 AI 领域一个敏感而关键的议题:大语言模型的实际表现是否会随时间波动,甚至出现「退化」。
「推理能力下降」意味着什么
所谓 median thinking(中位数推理水平)下降,通常指的是在某一评测体系或使用场景下,模型完成复杂推理任务的平均质量出现了可观测的回落。对于依赖 AI 完成编程、分析、问答等任务的用户而言,这类波动并非纯粹的学术议题,而是直接影响生产效率的现实问题。
社区中长期存在一种感受性判断:某些主流模型在经过版本更新或后台调整后,会出现「变笨了」的主观体验。Fable 5 相关讨论正是把这种零散的用户感受,尝试量化为可追踪的指标趋势。
需要说明的是,由于原始素材仅提供了标题与讨论链接,尚无法确认「Fable 5」具体指代某个评测基准、某款产品还是某个追踪项目。但从命名和语境推断,它很可能是一套用于持续监测模型推理表现的评估框架。
为什么模型表现会出现波动
围绕这一现象,业界通常有几种解释路径值得关注。
后台优化与成本权衡
模型提供方在服务大规模用户时,往往需要在响应速度、算力成本和输出质量之间做平衡。当推理链条(chain-of-thought)被压缩、采样参数被调整,或路由策略倾向于更轻量的模型变体时,都可能导致复杂任务的表现出现回落。
Chain-of-thought(思维链)是一种让模型在给出最终答案前显式列出中间推理步骤的技术,由 Google 研究人员于 2022 年提出。它显著提升了模型在数学、逻辑和多步推理任务上的表现。然而,完整的思维链推理需要生成大量 token,对算力消耗极高。服务商在高并发场景下,可能通过缩短允许的推理步数、提高温度参数(temperature)或将请求路由至参数量更小的「蒸馏」模型来降低成本。这些调整通常不对外公告,用户只能通过输出质量变化间接感知。这也是为什么「模型变笨」的讨论往往在用量高峰期(如新用户大量涌入后)集中出现。
评测方法的局限
另一种可能是,观测到的「下降」部分来自评测本身的噪声。样本量、题目分布、评分标准的细微变化,都可能让中位数指标产生非本质性的波动。因此单月数据下滑并不必然等同于模型能力的真实退化。
数据与对齐的副作用
持续的安全对齐、内容过滤和微调,有时会以牺牲部分推理灵活性为代价。这种「对齐税」在特定任务上可能表现为推理质量的下降。
「对齐税」(Alignment Tax)指模型经过强化学习人类反馈(RLHF)、安全微调等对齐训练后,在部分能力维度上出现的性能损耗。对齐训练的目标是让模型输出更安全、更符合人类偏好,但这一过程本质上是在原有能力分布上施加约束。研究表明,过度对齐可能导致模型在需要创造性推理、反事实假设或边界条件分析的任务上变得保守。OpenAI、Anthropic 等公司已在技术报告中承认这一权衡的存在,但具体的损耗程度和影响范围通常不予披露,这也加剧了外部评估的难度。
社区讨论的价值
这场讨论的意义,或许不在于「八月是否真的下降」这一具体结论,而在于它反映了一个日益重要的诉求:AI 模型需要可持续、可复现的第三方监测。
当越来越多的关键工作流依赖闭源模型时,用户对「黑盒」表现波动的敏感度也在上升。像 Fable 5 这类持续追踪项目,无论最终结论如何,都在推动一种更透明的问责机制——让模型能力的变化有据可查,而非停留在众说纷纭的主观感受层面。
第三方模型监测的缺失是当前 AI 生态的一个结构性问题。与传统软件不同,大语言模型的「版本」边界模糊——服务商可以在不更改版本号的情况下替换底层权重、调整推理参数或更换路由策略。目前已有一些独立评估项目尝试填补这一空白,例如持续运行标准化题库的 LMSYS Chatbot Arena、专注代码能力追踪的 HumanEval 系列,以及学术界的 BIG-Bench 等。但这些项目普遍面临维护成本高、覆盖场景有限、以及模型方有意规避「榜单过拟合」等挑战。Fable 5 若确为此类追踪框架,其价值在于提供时序维度的连续监测,而非单次横向比较。
理性看待「变笨」争议
对普通用户而言,面对此类讨论应保持审慎。单一指标、单一月份的数据不足以下定论;模型表现的主观感受也容易受到任务复杂度、提示词质量等多重因素干扰。
更务实的做法是:在关键任务中建立自己的小规模基准测试,定期用固定题目检验所依赖模型的稳定性,而非完全依赖社区传闻或单一榜单。
随着 AI 深度嵌入生产环境,模型的「可靠性追踪」将成为一个长期课题。Fable 5 引发的这轮讨论,正是这一趋势的缩影。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
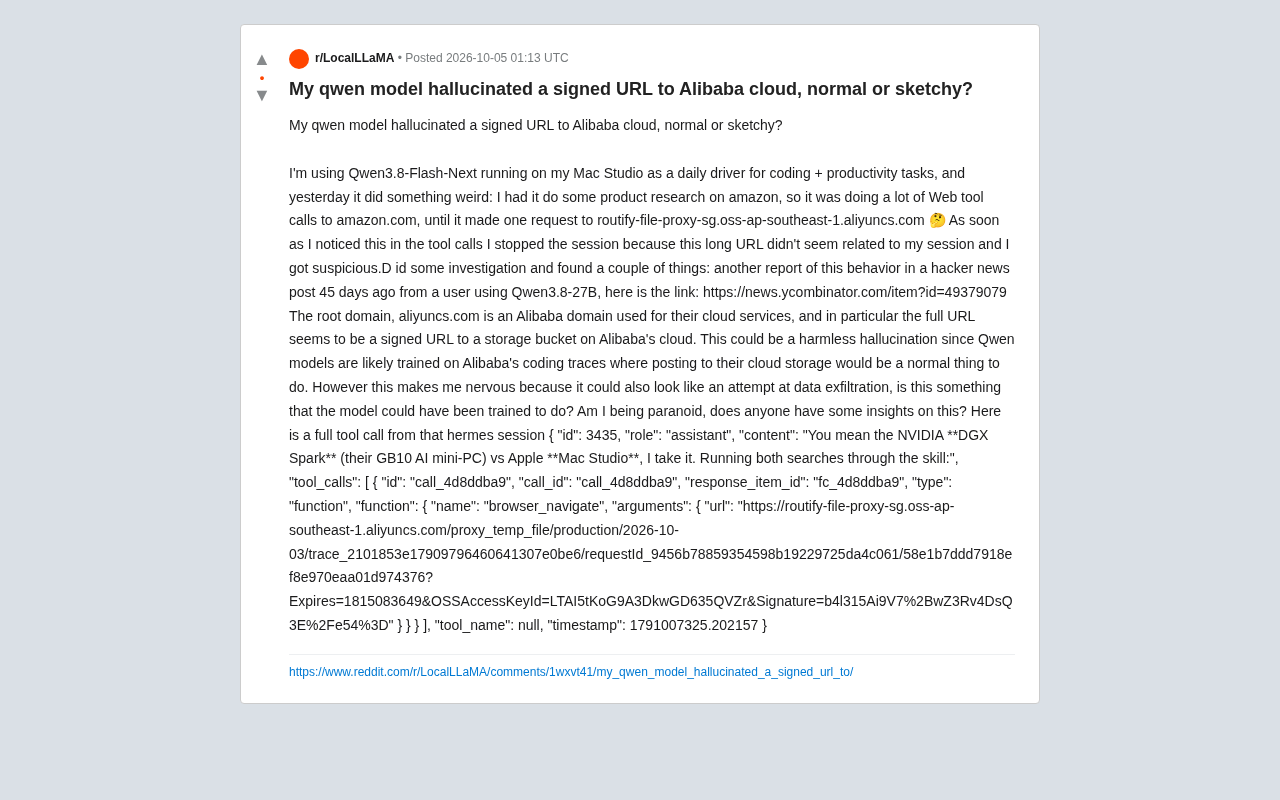
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。