FAITH:高维系统安全强化学习新框架

FAITH 用无模型安全价值近似器桥接安全过滤与任务策略,实现高维系统的安全与性能兼顾。
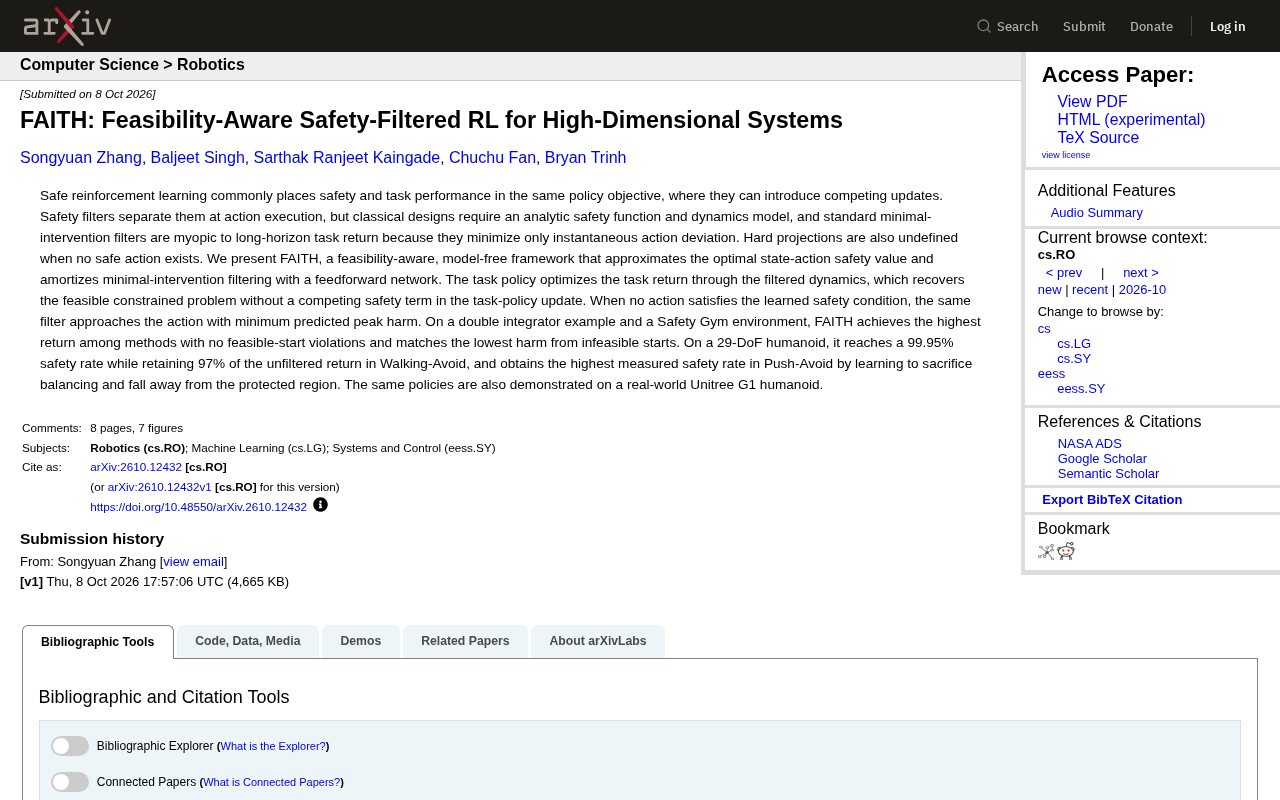
FAITH 是一个针对安全强化学习中「安全与性能梯度冲突」问题提出的无模型框架。它的核心思路是把安全过滤与任务策略解耦:用前馈网络近似状态-动作安全价值,据此对动作做最小干预修正,任务策略则在过滤后的动力学上继续优化回报,从而避免在同一损失函数中引入竞争性安全项。相比依赖解析安全函数与动力学模型的经典过滤器,FAITH 无需建模,可扩展到高维系统;相比只看瞬时偏差的最小干预过滤器,它把长时程信息纳入决策。当没有安全动作可用时,它选择预测峰值伤害最小的动作作为降级策略,而非让硬投影失效。实验显示其在双积分器与 Safety Gym 中取得高回报与低违规,在 29 自由度人形上达到 99.95% 安全率并保留 97% 未过滤回报,并已在真实 Unitree G1 机器人上验证。
安全强化学习长期面临一个两难:任务性能与安全约束写在同一个策略目标里,梯度更新方向可能互相冲突。安全过滤器(safety filter)把二者在动作执行层面拆开,思路更干净,但经典设计依赖解析形式的安全函数与动力学模型,最小干预过滤器又只盯瞬时动作偏差,对长期回报缺乏感知。更棘手的是,当不存在安全动作时,硬投影直接失效。
FAITH 正是针对这些缺口提出的无模型框架。据该论文描述,它近似最优状态-动作安全价值,并用前馈网络摊销最小干预过滤过程。任务策略在过滤后的动力学上优化任务回报,从而恢复出可行的约束问题,而无需在策略更新中引入竞争性的安全项。
FAITH 的核心机制
把安全价值与控制策略解耦
FAITH 的关键设计在于不把安全塞进任务策略的损失函数,而是学习一个状态-动作安全价值近似器。这个近似器回答的问题是:在当前状态执行某个动作,长期来看有多安全。过滤网络据此对动作做最小干预修正。
这与传统安全过滤器有本质区别。经典方法需要显式的动力学模型和解析安全函数,在复杂高维系统中几乎无法手工构造。FAITH 走无模型路线,把过滤过程交给前馈网络摊销,绕开了建模瓶颈。
状态-动作安全价值(state-action safety value) 是安全强化学习中的核心概念,通常记作 (Q^s(s,a)),回答的是「在状态 s 执行动作 a 后,未来整条轨迹上累积的安全代价期望是多少」。它与任务价值 (Q^r(s,a)) 结构对称,但优化目标是最小化违规代价而非最大化回报。经典约束马尔可夫决策过程(CMDP)框架要求在最大化回报的同时令累积代价满足阈值约束,而安全价值正是约束的对偶形式所需的关键量。FAITH 用前馈网络近似 (Q^s),本质是学出来的「刹车判断器」:动作进入过滤器前先被它评估长时程风险。相比依赖解析安全函数的做法,这种近似方式可随数据扩展,也对未知动力学更鲁棒,但其精度受离线数据覆盖与泛化能力限制。
干预最小化但不短视
标准最小干预过滤器只最小化动作的瞬时偏差,容易忽略长期任务回报。FAITH 通过安全价值近似器把长时程信息纳入过滤决策,同时保持干预幅度尽量小。换句话说,它既不过度干预任务策略,也不只顾眼前那一步。
这种折中让任务策略能在过滤后的动力学上继续优化任务回报。按论文说法,这恢复了可行的约束问题,且任务策略更新中不含竞争性安全项——安全与性能不再在同一梯度里打架。
最小干预过滤器(minimal intervention filter) 是一类在动作进入执行器前做微调的安全机制:当任务策略给出的动作已经安全时不做任何修改,只有将要越界时才施加刚好足够把动作拉回安全集内的修正量。它的优点是对任务性能的破坏理论上最小,因此常被用作「安全层」叠加在已有策略上。经典实现如基于控制障碍函数(CBF)的二次规划过滤器,依赖解析形式的障碍函数与系统动力学。而仅最小化瞬时偏差的版本只看当前动作是否越界,不评估该动作对未来的影响,因此在需要提前减速、绕行等长时程规避的场景中往往失灵。FAITH 用安全价值把长时程因素引入这一最小化目标,实质是给瞬时过滤器补齐了「前瞻」维度。
无安全动作时的降级策略
硬投影在无安全动作可用时没有定义,这是很多安全滤波器的致命弱点。FAITH 的处理方式是:当学到的安全条件没有任何动作满足时,过滤器转而选择预测峰值伤害最小的动作。这相当于一种有原则的降级,而非直接崩溃或随机动作。
硬投影(hard projection) 指把任务动作强制投影到安全动作集合上的做法,典型实现是解一个带硬约束的优化问题。它在数学上要求安全集非空,一旦可行域为空——即当前状态下无论执行什么动作都会产生违规——问题就无解,程序要么报错要么退化为不可解释的行为。这在接近物理极限的场景(如人形即将跌倒、机械臂进入奇异位形)中很常见。软约束方法通过放宽约束换取可行性,但代价是允许一定违规。FAITH 采用的「峰值伤害最小化」介于两者之间:不假装存在安全动作,而是承认无解并选伤害上界最低的动作,属于可行性感知(feasibility-aware)的降级思路,能在最坏情形下仍给出可执行且可解释的决策。
实验表现:从双积分器到真实人形
基准环境中的回报与违规
在双积分器示例和 Safety Gym 环境中,FAITH 在无可行起点违规的方法里取得最高回报,同时在不可行起点下匹配了最低伤害水平。这两个指标同时达成本身说明,安全与性能的权衡被明显缓解。
Safety Gym 是 OpenAI 提出的安全强化学习基准套件,包含 Point、Car、Ant 等不同复杂度的智能体,任务中散布着需要避开的危险区域(hazards)和需要达成的目标,同时用「起点可行/不可行」来区分策略是否从一开始就处于安全边界内。它之所以成为常用基准,是因为它同时暴露了回报与违规代价两条曲线,能直接检验方法在性能与安全之间的权衡。可行起点(feasible start) 指初始状态满足所有安全约束,不可行起点 则意味着智能体开局即违规,迫使方法展示恢复能力而非仅仅避免违规。FAITH 在这两类起点上分别取得高回报与低伤害,说明其过滤机制在边界条件下也保持稳定。
29 自由度人形的安全率
在 29 自由度人形系统上,FAITH 在 Walking-Avoid 任务中达到 99.95% 安全率,同时保留未过滤回报的 97%。这个数字值得拆开看:安全率极高,但回报损失很小,说明过滤器没有把任务策略压制成保守的原地不动。
Push-Avoid 任务中,FAITH 取得最高实测安全率。论文提到,它学会了牺牲平衡、朝远离受保护区域的方向摔倒。这种策略在传统安全视角下可能显得激进,但它换来了更高的安全率——摔倒方向是经过权衡的。
真实机器人验证
同样的策略还被部署到真实世界的 Unitree G1 人形机器人上演示。从仿真到真机的迁移是安全强化学习方法落地的关键门槛,这一验证增加了框架的实用分量。
一点分析
FAITH 的思路是「让安全的归安全,任务的归任务」,再用学习到的安全价值把两者桥接起来。这比在单一目标里加权求和更合理,也比纯解析安全过滤器更可扩展。
它仍有值得追问的地方。安全价值近似器的精度直接决定过滤质量,而近似误差在高维状态下的分布并不清楚。无安全动作时的峰值伤害最小化是一种启发式补救,其理论保证有多强,论文摘要未展开。真实机器人演示的具体任务范围与安全边界,也需要看正文细节才能判断。
对做具身智能与安全控制的研究者来说,FAITH 提供了一个值得复现和对比的新基线:无模型、可行性感知、支持高维系统,且不依赖解析安全函数。
相关推荐

Claude Code+Codex多智能体系统实测:缓存率98%背后的真问题
开发者公布Claude Code+Codex多智能体系统7天实测:缓存率98%、输入输出比354:1,作者却卡在组织调度与输出比例,并追问行业基准与成本度量方法。

Cursor SDK 新功能:实时操控运行中的 AI 代理
Cursor SDK 新增 run.steer() 功能,允许开发者在 AI 代理运行中实时注入消息,调整执行方向。子代理遇 steer 时自动转入后台继续任务,为 AI 编程工作流带来更灵活的运行时干预能力。

如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。