FakeSpotter:不判真假也能识别病毒式虚假信息的AI工具
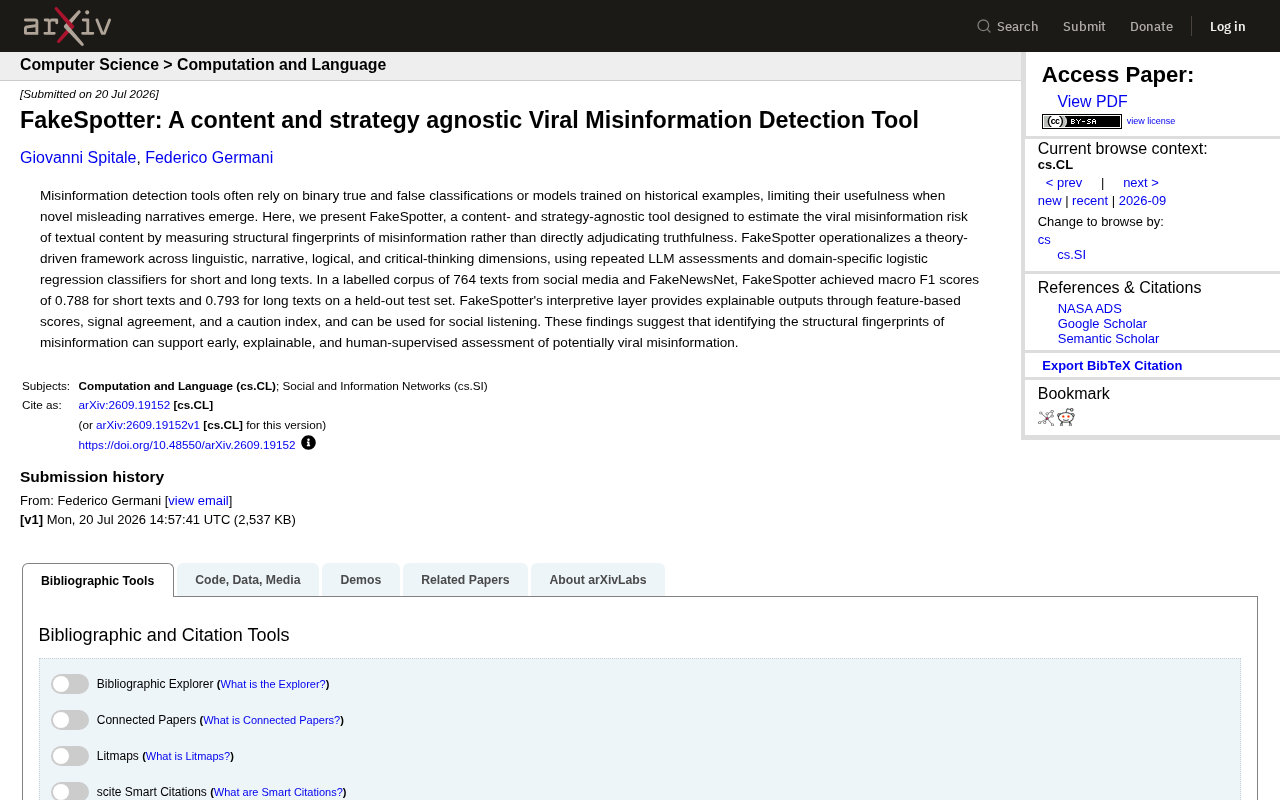
FakeSpotter通过识别虚假信息的结构指纹而非裁定真假,实现对病毒式谣言的早期可解释风险预警。
FakeSpotter是一个针对病毒式虚假信息的早期风险检测框架,核心创新在于放弃真假二元判定,转而从语言、叙事、逻辑、批判性思维四个维度提取"结构指纹"。这种内容与策略无关的设计使其能应对全新谣言,而无需依赖历史样本。技术上,它结合LLM多次评估进行特征提取,再以分别针对短文本和长文本训练的逻辑回归分类器给出风险判断,在764条标注文本上两类文本的宏观F1均约达0.79。此外,系统通过特征分数、信号一致性与"谨慎指数"提供可解释输出,定位为辅助人工审核的社交聆听工具,而非替代人工的最终裁决手段。
传统虚假信息检测的困境
主流的虚假信息检测工具通常依赖两种思路:要么把内容做二元的"真"与"假"分类,要么依靠历史样本训练模型。这两种方法在面对全新的误导性叙事时都会失灵——当一种此前从未出现过的谣言开始传播,缺乏历史参照的模型往往束手无策,而简单的真假判定又极易陷入争议。
arXiv上的一篇新论文提出的FakeSpotter,试图绕开这个难题。它的核心思路不是直接去裁定一段文本是真是假,而是测量虚假信息的"结构指纹"(structural fingerprints),据此估算内容成为病毒式虚假信息的风险。这种"内容无关、策略无关"(content- and strategy-agnostic)的设计,让它在应对新型谣言时具备更强的适应能力。
从判断真假到识别结构指纹
FakeSpotter最值得关注的转变,在于它把问题重新定义了。它不问"这条信息是不是假的",而问"这条信息是否具备虚假信息常见的结构特征"。
为此,研究者构建了一个理论驱动的框架,覆盖四个维度:语言(linguistic)、叙事(narrative)、逻辑(logical)以及批判性思维(critical-thinking)。这些维度描述的是虚假信息在表达方式、故事结构、论证逻辑上往往共享的模式,而非具体的事实内容。这样一来,即便某个谣言的主题、话题、传播策略是全新的,只要它在结构上带有典型的"误导指纹",工具依然能够捕捉到风险信号。
这种设计的价值在于早期预警。传统方法需要等到事实核查完成才能给出结论,而结构分析可以在信息刚开始传播、真相尚未明朗时就发出警示。
技术实现:LLM评估加逻辑回归
在具体实现上,FakeSpotter采用了大语言模型(LLM)重复评估与领域特定逻辑回归分类器相结合的方式。
工具通过多次LLM评估来获取上述四个维度上的特征打分,再用针对短文本和长文本分别训练的逻辑回归分类器给出风险判断。之所以区分短文本和长文本,是因为社交媒体上的短消息与长篇文章在语言密度、叙事完整度上差异明显,用统一模型难以兼顾。
这种"LLM做特征提取、传统机器学习做分类"的混合架构,兼顾了大模型的语义理解能力和逻辑回归模型的可解释性与稳定性,是当前不少可解释AI系统的常见范式。
逻辑回归(Logistic Regression)是一种经典的线性分类算法,尽管名字含"回归",实际上用于输出离散类别的概率。它的核心优势在于可解释性强——每个输入特征都有一个对应的权重系数,可以直接量化该特征对最终判断的贡献方向和大小。与深度神经网络的"黑箱"决策不同,逻辑回归的预测过程对人类审核者而言是可追溯的。在FakeSpotter的架构中,LLM负责将非结构化文本转化为四个维度上的量化评分(即"特征提取"),逻辑回归则基于这些评分给出风险概率——这种分工使得整个流程既具备大模型的语义理解深度,又保留了传统算法的透明度,符合监管合规或高风险决策场景对可解释AI的基本要求。
实测表现与可解释性
研究团队在一个包含764条文本的标注语料库上进行了验证,数据来自社交媒体和FakeNewsNet数据集。在留出测试集上,FakeSpotter对短文本取得了0.788的宏观F1分数,对长文本取得了0.793的宏观F1分数。
这一成绩在虚假信息检测任务中属于可用水平,尤其考虑到它并不依赖对具体事实的核查。不过需要理性看待的是,0.79左右的F1意味着仍有相当比例的误判空间,工具定位更适合作为辅助筛查而非最终裁决。
值得强调的是它的可解释性设计。FakeSpotter提供了一个"解释层"(interpretive layer),通过基于特征的分数、信号一致性(signal agreement)以及一个"谨慎指数"(caution index)来输出结果。用户不仅能知道某条内容风险高低,还能看到判断依据来自哪些维度、各信号是否相互印证。这种透明度对于需要人工复核的应用场景尤为重要。
宏观F1分数(Macro F1)是一种在类别不平衡数据集上常用的综合评估指标。它对每个类别分别计算F1分数(精确率与召回率的调和平均值),再对所有类别取简单平均,因此不会因多数类样本数量庞大而掩盖少数类上的表现。在虚假信息检测任务中,"真"与"假"的样本往往不均衡,使用宏观F1能更公平地反映模型在两种类别上的整体能力。FakeNewsNet是学术界常用的虚假信息基准数据集,收录了来自PolitiFact和GossipCop两个事实核查平台的带标注新闻,覆盖政治与娱乐两个领域,是评估虚假信息检测系统的标准测试床之一。
应用价值与定位
论文明确指出,FakeSpotter可以用于社交聆听(social listening),即在海量社交媒体内容中持续监测潜在的高风险信息。
它的整体定位是"早期、可解释、人类监督"的评估工具。这三个关键词共同勾勒出它的边界:它不追求替代人工判断,而是在信息可能引爆传播之前,为人类审核者提供一个带解释的风险信号。
对于平台运营方、事实核查机构乃至研究者而言,这类工具的意义在于把有限的人力聚焦到真正需要关注的内容上。识别虚假信息的结构指纹,或许无法给出"这就是假新闻"的斩钉截铁结论,但能够更早、更透明地标记出值得警惕的对象——这在虚假信息传播速度远超核查速度的当下,本身就是一种务实的价值。
社交聆听(Social Listening)是指对社交媒体平台上的公开内容进行系统性的持续监测与分析,通常用于品牌舆情管理、公众情绪追踪或危机预警。在虚假信息治理的语境下,社交聆听意味着以自动化方式扫描高流量内容流,识别出值得人工介入的高风险信号,而非对每一条内容逐一核查。这一应用场景的核心约束是吞吐量与时效性——内容每天以亿计产生,人工审核资源极其有限,因此自动化工具的价值不在于"判决",而在于将有限的人力精准分配到风险最高的内容上。FakeSpotter的早期预警定位与这一需求高度契合。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。