反向自蒸馏:弱化模型竟能提升推理能力
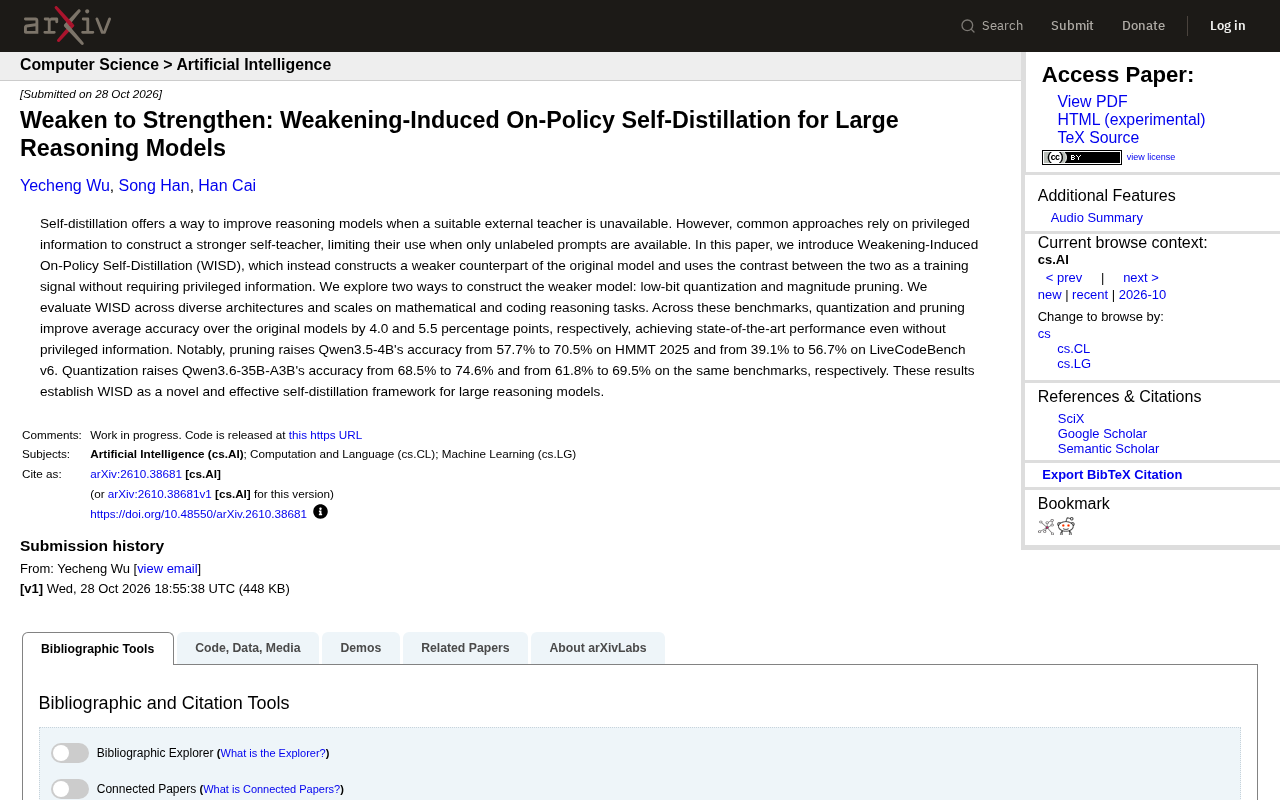
WISD通过弱化模型副本与原始模型对比实现无特权信息的自蒸馏,推理任务显著提升。
WISD(Weakening-Induced On-Policy Self-Distillation)提出了一种反直觉的自蒸馏思路:不构建更强教师,而是主动弱化原始模型(通过低比特量化或幅度剪枝),利用弱化前后在相同无标签提示上的行为差异作为训练信号。该方法在数学与代码推理基准上取得稳定提升,量化平均提升4.0个百分点,剪枝提升5.5个百分点。具体案例中,剪枝将Qwen3.5-4B在HMMT 2025上从57.7%提升至70.5%,LiveCodeBench v6从39.1%提升至56.7%。由于弱化副本与原始模型同源,WISD避免了教师-学生分布不匹配问题,且无需任何外部监督信号。目前方法仅在推理任务上验证,弱化强度选择缺乏理论指导,机制解释仍偏直觉。
自蒸馏为推理模型提供了一条不依赖外部教师的改进路径,但常规做法通常需要特权信息来构建更强的自教师,这限制了它在仅有无标签提示时的应用。最新论文《Weaken to Strengthen: Weakening-Induced On-Policy Self-Distillation for Large Reasoning Models》提出了一个反直觉的思路:与其构建更强的教师,不如主动弱化模型,利用弱化前后的对比作为训练信号。该方法被称为 WISD(Weakening-Induced On-Policy Self-Distillation),在数学与代码推理任务上取得了显著提升。
核心思路:从“更强教师”转向“更弱副本”
自蒸馏的经典范式是让一个能力更强的教师模型指导原始模型,但强教师往往依赖额外的标注或特权信息。WISD 则反其道而行:它不追求更强的教师,而是构造原始模型的一个弱化版本,通过对比原始模型与弱化模型在相同输入上的行为差异,获得训练信号。
这一设计的关键在于,弱化模型仍然保留了原始模型的部分能力,但其输出质量有所下降。原始模型在对比中“看到”弱化版本犯的错误,从而调整自身的推理策略。整个过程无需任何外部教师或特权信息,仅依赖无标签提示即可运行。
论文探索了两种构造弱化模型的方式:低比特量化和幅度剪枝。两者都是常见的模型压缩手段,但在这里被用作生成“较弱自我”的工具,而非部署优化。
低比特量化与幅度剪枝是两种常见的模型压缩技术。低比特量化将模型权重从高精度(如 FP16)转换为低精度(如 INT8、INT4),在减少存储和计算开销的同时会引入量化误差,导致模型输出质量下降。幅度剪枝则根据权重绝对值大小移除不重要的连接或参数,剪枝率越高,模型容量损失越大。在 WISD 中,这两种操作并非用于部署加速,而是作为“可控弱化器”:通过调节量化位宽或剪枝比例,可以精确控制弱化副本的能力衰减程度,从而为原始模型提供不同难度的对比信号。这种将压缩技术反向用于训练信号生成的做法,是该方法区别于传统自蒸馏的关键设计。
On-Policy 自蒸馏强调训练信号来自模型自身在给定输入上实时生成的轨迹,而非离线的固定数据集。在 WISD 中,原始模型与弱化模型对同一无标签提示分别进行推理,产生两条并行的输出轨迹。对比发生在策略空间而非答案空间:原始模型通过识别弱化副本在推理步骤上的偏差来调整自身策略,因此训练分布与模型当前行为保持一致,避免了离线蒸馏中常见的分布偏移问题。这也是 WISD 仅需无标签提示即可运行的原因——它利用的是模型自身的行为差异,而非外部标注的正确答案。
实验设置与主要结果
WISD 在多种架构和规模上进行了评估,覆盖数学与代码推理基准。实验结果显示,量化和剪枝两种弱化方式均能带来稳定的平均准确率提升:量化提升 4.0 个百分点,剪枝提升 5.5 个百分点。即使在没有任何特权信息的条件下,WISD 也达到了当前最优水平。
具体案例更能说明问题。剪枝将 Qwen3.5-4B 在 HMMT 2025 上的准确率从 57.7% 提升至 70.5%,在 LiveCodeBench v6 上从 39.1% 提升至 56.7%。量化则将 Qwen3.6-35B-A3B 在同一组基准上的准确率分别从 68.5% 提升至 74.6%,以及从 61.8% 提升至 69.5%。这些提升幅度在推理任务上相当可观,尤其考虑到方法本身不引入任何额外监督信号。
有意思的是,剪枝带来的平均提升高于量化,且在小模型上表现尤为突出。这可能因为剪枝对模型能力的削弱更为结构化,产生的对比信号更清晰。
为什么“弱化”反而有效?
从直觉上理解,弱化模型相当于一个“知道得少一点”的版本。原始模型在对比中能够识别出弱化版本在哪些推理步骤上出现了偏差,这种偏差信息比单纯的正确答案更具指导性。与需要强教师的方案相比,WISD 的优势在于弱化模型始终与原始模型同源,避免了教师模型与学生模型之间的分布不匹配问题。
此外,弱化操作本身具有随机性和可控性。量化和剪枝都可以调节强度,这为训练过程提供了灵活的调节维度。论文没有深入讨论强度选择的理论指导,但实验表明两种弱化方式在多个模型规模上均有效,说明方法具有一定的鲁棒性。
教师-学生分布不匹配是传统知识蒸馏中的固有难题:强教师模型通常在更大规模数据或更强监督下训练,其输出分布与学生模型存在系统性差异,学生模仿教师时可能学到不适配自身能力边界的推理模式。WISD 通过让弱化副本与原始模型同源,从根本上消除了这一不匹配——两者共享相同的预训练知识、分词方式和推理风格,差异仅来自压缩操作引入的能力衰减。这种同源性使得对比信号更聚焦于“能力削弱导致的错误模式”,而非教师与学生之间的架构或数据偏差,从而提高了训练信号的纯净度和可迁移性。
局限与展望
WISD 目前仅在数学和代码推理任务上验证,是否适用于更广泛的自然语言推理任务尚不明确。弱化强度的选择也缺乏理论依据,可能需要针对不同模型和任务进行调参。另外,弱化模型与原始模型的对比信号如何具体转化为训练梯度,论文的机制解释仍偏直觉,后续工作可以进一步分析其内在机理。
尽管如此,WISD 提供了一种新的自蒸馏视角:不一定要有更强的教师,一个可控的弱化副本同样能驱动模型进步。这对于缺乏外部监督资源的场景尤其有价值,也为模型自改进开辟了一条低成本路径。
相关推荐

FDE前沿部署工程师:从概念到实战,AI落地的关键角色
深入解析FDE(前沿部署工程师)的概念、交付内容与入行路径。国内大厂月薪10万争抢,OpenAI、Anthropic、阿里、DeepSeek都在布局。从RAG到Agent开发,再到私有化部署,一文讲透AI落地的关键角色。

Harness已死?T3 Code作者为何说别再纠结AI编程工具
T3 Code创作者深度解析:Harness究竟是什么?为什么说模型与Harness正在融合、性能差距只剩几个百分点?工程师为何总在纠结不该纠结的技术细节?一文读懂AI编程工具的未来走向。
Surface RTX Spark Dev Box 离线跑通 120B 模型:Intelligent Terminal 实战
微软 Surface RTX Spark Dev Box 实机演示:通过开源 Intelligent Terminal 离线运行 120B 参数本地模型,一句话自动构建可启动 Hyper-V 虚拟机,展示 Project Zemuth 设备的本地 AI 能力。