FDE前沿部署工程师入门指南:从Palantir流派到企业级落地实战

FDE是AI时代懂技术又懂业务的复合型工程师,需从智能体开发进阶到微调蒸馏。
文章介绍了FDE(前沿部署工程师)这一AI时代新岗位,其核心是既懂AI技术又能深入企业业务场景落地。FDE实践分为Palantir本体论驱动和场景驱动两大流派,选择取决于企业规模与数据基础。技术进阶路径建议从智能体开发起步,再深入微调、蒸馏和预训练,难度依次递增。企业不愿做微调的核心原因是效果验证困难且成本高,FDE需算经济账。企业级部署建议至少8B以上模型,硬件预算因行业差异巨大。文章还给出入门建议:从智能体开发和私有化部署起步,逐步进阶。
什么是FDE?AI时代的新物种
FDE,全称Forward Deployment Engineer(前沿部署工程师),被一些从业者称为"AI时代的新物种"。据B站UP主李锦老师在直播课中的介绍,这个概念在2026年正变得火热。它的核心定位是:既懂AI技术(智能体开发、模型微调、检索增强等),又能深入企业业务场景,把技术真正落地到客户现场。
与传统的算法工程师不同,FDE不是坐在办公室里调参,而是直接面对客户的实际问题。李锦老师本人就在从事FDE相关工作,他提到,如果想招有FDE经验的人,过去可能要去美国的Palantir公司挖人,但现在中国很多企业也在进行FDE方向的改造。
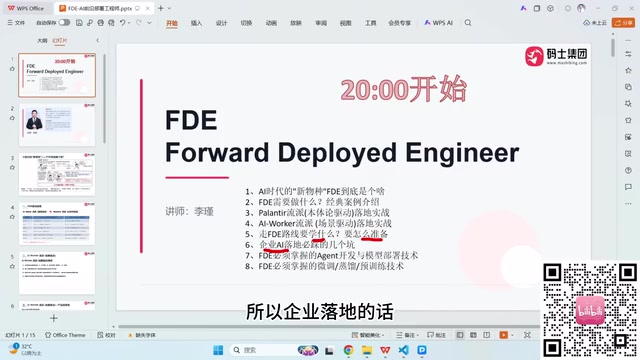
FDE的两大流派:本体论驱动 vs 场景驱动
李锦老师将FDE的落地实践分为两个主要流派:
Palantir流派(本体论驱动):起源于Palantir公司的实践,强调以"本体论"为核心来组织数据和业务逻辑,构建企业级的知识图谱和决策系统。这种流派适合数据复杂、业务链条长的大型企业。
场景驱动流派:更偏向从具体业务场景出发,快速用AI智能体解决实际问题。这种路径灵活、见效快,适合中小型项目或垂直场景。
两个流派没有绝对优劣,选择取决于企业规模、数据基础和预算。
本体论(Ontology) 在这里并非哲学意义上的本体论,而是Palantir等公司用来描述企业业务对象、属性及其关系的结构化数据模型。它把客户、订单、设备、事件等实体抽象为节点,把交易、归属、依赖等关系抽象为边,从而构建可计算的知识图谱。基于本体论,AI系统可以在统一语义层上做推理、查询和决策,避免各部门数据口径不一致的问题。这种方式的代价是前期建模成本高,需要深入梳理业务流程,因此更适合数据量大、业务链条长且已有一定数据治理基础的大型企业。
走FDE路线需要学什么?
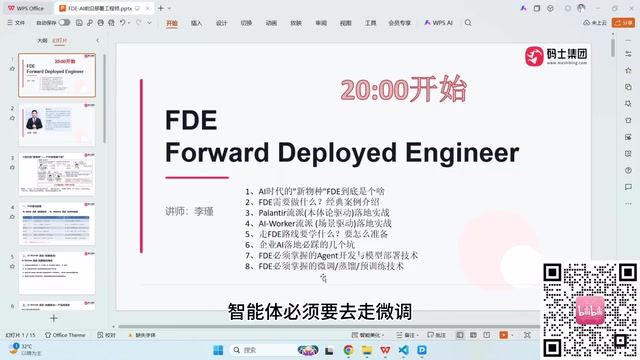
李锦老师给出了一个清晰的技术进阶路径:先做AI智能体开发,再深入模型微调、蒸馏和预训练。
他特别强调,很多企业级项目的验收标准会要求智能体必须走微调、蒸馏甚至预训练。如果只停留在智能体层面,效果可能卡在90分上不去,而业务验收可能需要95分。
从难度上看,微调的技术门槛低于蒸馏,蒸馏又低于预训练。因此他建议从微调入手,逐步深入。此外,FDE还需要掌握模型私有化部署、本地化部署、检索增强生成(RAG)等技术。李锦老师提到,自己最近两年的研究方向就是将传统微服务与多智能体、RAG检索深度结合,具备从底层算法到AI应用的端到端落地能力。
模型微调、蒸馏与预训练是三个不同层次的技术。微调指在已有预训练模型基础上,用特定领域数据继续训练,使模型适应具体任务,通常只需少量数据和算力;蒸馏指用大模型(教师模型)的输出指导小模型(学生模型)训练,让小模型在保持较高效果的同时降低部署成本;预训练则是从零开始用海量通用数据训练基础模型,需要巨大的算力和数据投入。三者难度递增,FDE应根据项目预算和验收标准选择合适的技术层级,而非盲目追求最复杂的方案。
检索增强生成(RAG) 是一种将外部知识库与大型语言模型结合的技术:系统先根据用户问题从企业文档、数据库或知识图谱中检索相关片段,再把这些片段作为上下文交给模型生成答案。RAG能缓解模型幻觉、支持私有数据问答,且无需重新训练模型,因此成为FDE落地企业场景的常用手段。它通常与智能体结合,由智能体决定何时检索、检索什么,从而完成多步业务任务。
企业落地必踩的坑:微调不是人人愿意做
直播中有观众问"很多公司没有条件微调",李锦老师纠正说,不是没有条件,而是很多公司不愿意做。核心原因是:微调前和微调后的效果差异难以验证。他身边开公司的朋友反馈,有时微调后效果反而变差,而专门招一个人做微调,一年成本可能达到大几十万;找外部团队调也要花钱。因此,除非企业确信微调能带来显著收益,否则不会主动投入。
这揭示了FDE落地的一个现实:技术方案要算经济账。李锦老师还提到硬件成本问题——企业级部署一般建议至少8B以上的模型,8B以下在2026年部署意义不大。硬件成本因客户而异:金融、医院等客户采购硬件可能达200万级以上,而传统公司可能只愿意出2万块。"2万块能干啥?"他反问。这提醒FDE从业者,必须理解客户的预算约束和业务回报。
模型参数规模(如8B) 指模型的可训练参数数量,通常以B(Billion,十亿)为单位。参数越多,模型容量和泛化能力一般越强,但对显存、算力和部署成本的要求也越高。8B模型在消费级或单卡服务器上尚可部署,而更大规模的模型往往需要多卡或专用推理硬件。企业级场景中,模型规模选择需要平衡效果、延迟和硬件预算,因此文中建议至少8B以上,是因为更小的模型在复杂业务场景中效果衰减明显,难以满足验收标准。
给入门者的建议
李锦老师的课程覆盖了从概念来源、两个流派的企业级项目实战,到Agent开发、模型部署、微调、蒸馏、预训练等技术细节。对于想走FDE路线的人,他建议不要一上来就啃预训练,而是从智能体开发和模型私有化部署起步,逐步向微调和蒸馏进阶。
直播中他也提到,讲课风格是从零讲起,哪怕是非技术背景也能跟上。对于初学者,这种循序渐进的路径比直接扎进算法细节更务实。
总结
FDE不是单一技术岗位,而是技术能力与业务落地能力的复合体。Palantir流派和场景驱动流派提供了两种落地思路;微调、蒸馏、预训练构成技术深度阶梯;而企业预算和效果验证难题,则是每个FDE必须面对的现实。李锦老师的分享来自一线实践,对想进入这个方向的人有直接参考价值。
相关推荐

自博弈AI为何总被廉价兵种打崩?RTS开发者亲述困境
独立开发者用纯自博弈训练RTS指挥官AI,却发现AI对历史版本胜率极高,却被人类玩家用廉价一级兵种击溃。本文分析自博弈策略坍塌的成因,探讨剥削者、多样性奖励与奖励设计等解决路径,并介绍其开放Bot Kit与AI联赛计划。

多智能体平台哪家强?小团队实战踩坑与选型思考
一位27人初创公司运营负责人四个月内试了两套多智能体平台均告失败,引发社区讨论。本文分析小团队多智能体方案为何容易散架,并从集成度、可观测性和渐进落地等角度给出选型思路。
76亿美元私有化:Thrive Holdings收购ADT
Thrive Holdings以76亿美元全现金收购ADT,交易预计2027年一季度完成,ADT将私有化退市。本文分析交易结构、ADT的资产价值及对智能家居安防行业的影响。