Fireworks Forge 闭幕炉边对话:聚焦专用开源模型的未来

Fireworks Forge 闭幕对话聚焦专用开源模型,汇集政策、资本与技术三方视角。
Fireworks 公司宣布,其主办的 Fireworks Forge 活动将于下周举行闭幕炉边对话,主题为“专用开源模型的未来”。嘉宾包括美国总统科技顾问委员会(PCAST)联合主席 David Sacks、Atreides Management 投资人 Gavin Baker,以及 Fireworks CEO Lin Qiao,分别代表政策、资本与技术三个维度。文章认为,专用开源模型是针对特定任务或场景优化的开放权重模型,正成为通用大模型之外被低估的路线,其发展不仅取决于技术,也受监管风向和商业落地可行性影响。对话将通过 livestream 向无法到场的观众开放。
Fireworks 公司近日通过 Twitter 宣布,其主办的 Fireworks Forge 活动将于下周迎来闭幕炉边对话,主题直指“专用开源模型的未来”。这场对话汇聚了政策、投资与技术三个关键领域的代表人物,阵容值得关注。
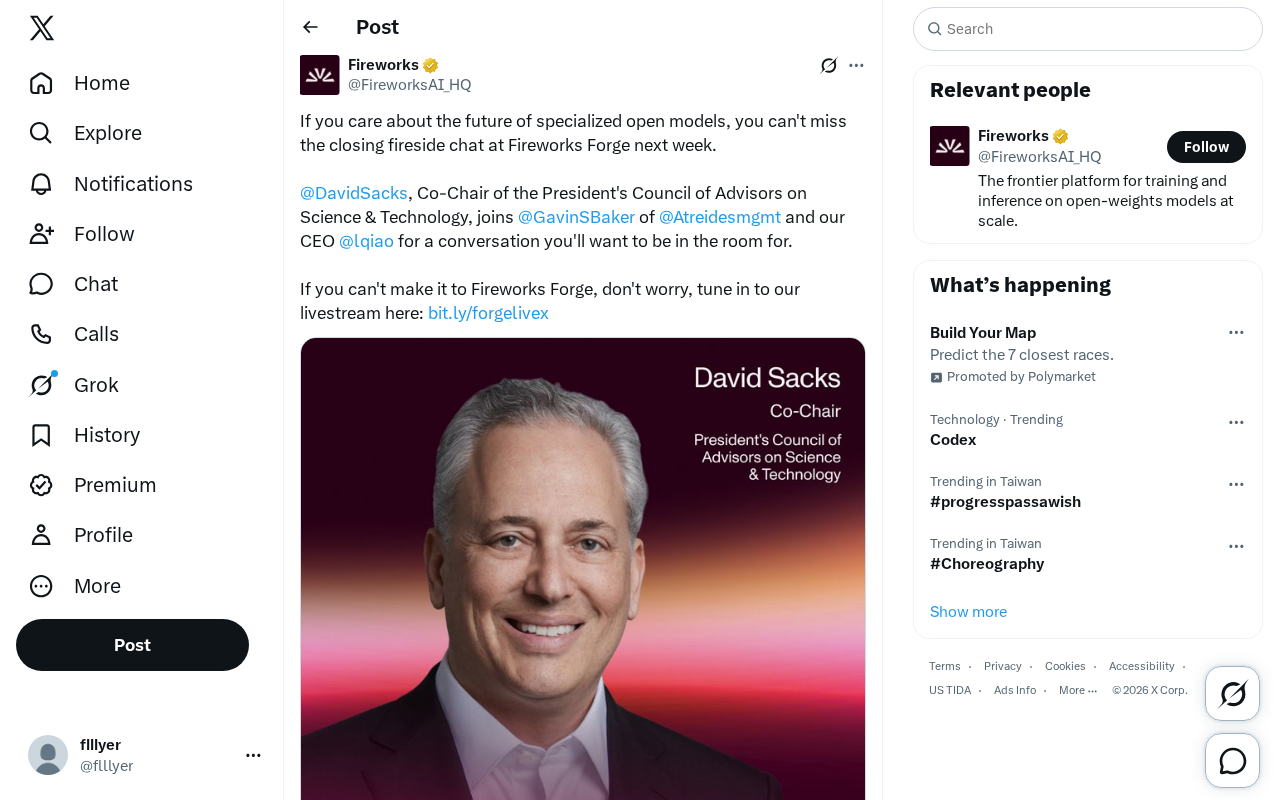
对话嘉宾:政策、资本与技术的三方交汇
根据官方推文,本次炉边对话的嘉宾包括:
- David Sacks:美国总统科技顾问委员会(PCAST)联合主席,在科技政策与产业战略层面拥有重要话语权;
- Gavin Baker:Atreides Management 的投资人,长期关注科技与 AI 领域的资本动向;
- Lin Qiao:Fireworks 公司 CEO,直接参与专用模型推理与部署的基础设施建设。
这三重身份的叠加,意味着讨论不会停留在技术演示层面,而会触及开源模型在政策环境、商业落地和工程可行性上的真实张力。对于关心开源生态走向的从业者来说,这是一个少见的交叉视角。
PCAST(总统科技顾问委员会) 是美国总统行政办公室下属的咨询机构,由来自产业界、学术界和非营利组织的专家组成,职责是就科技政策向总统提供独立建议。它与负责具体执行的 OSTP(白宫科技政策办公室)不同,更偏向战略层面的长期判断。历史上 PCAST 的报告曾影响美国在纳米技术、宽带普及和人工智能研发投入上的政策取向。因此,PCAST 联合主席公开谈论开源 AI,常被解读为联邦层面监管思路的风向标之一。
为什么“专用开源模型”值得一场压轴对话
通用大模型的竞争已经足够拥挤,而专用开源模型——针对特定任务、行业或部署场景优化的开放权重模型——正在成为另一条被低估的路线。它关乎企业能否在可控成本下获得可审计、可定制的模型能力,也关乎开源社区能否在闭源巨头的夹缝中保持创新节奏。
Fireworks 将这场对话安排在活动闭幕环节,本身就传递了信号:专用开源模型的未来不是单纯的技术问题,而是政策、资本与工程共同塑造的结果。David Sacks 的参与尤其值得留意,PCAST 的立场往往会影响美国在开源 AI 监管上的风向。
开放权重(open weights) 指模型训练完成后,权重参数可被公开下载和使用的发布方式,它与“开源”并不完全等同:完整的开源还要求公开训练数据、代码和训练流程。实践中,多数所谓开源大模型只开放权重,许可证也可能附带商用限制或用户规模门槛。对企业而言,开放权重的价值在于可本地部署、可微调、可审计,从而规避数据出境和供应商锁定风险;但能否真正“定制”,仍取决于许可证条款和模型架构的透明度。
推理(inference)与部署基础设施 是大模型从训练走向生产的关键环节。训练关注的是用大规模算力拟合参数,推理关注的则是如何在延迟、吞吐和成本约束下响应用户请求。专用模型通常参数量更小、任务更聚焦,因而可以通过量化、蒸馏、推测解码等技术进一步压缩推理成本。Fireworks 这类公司的核心业务正是提供推理优化与部署平台,这也解释了为何其 CEO 会出现在一场关于专用开源模型的对话中——模型能否落地,很大程度上取决于推理层的工程效率。
无法到场?直播同样开放
官方推文特别说明,无法亲临 Fireworks Forge 现场的人可以通过 livestream 观看这场对话,链接已在推文中给出。对于关注开源模型政策走向、投资逻辑或推理基础设施的读者,这场闭幕对话提供了一个集中获取三方观点的窗口。
活动的具体议程和更多细节尚未在推文中展开,但仅凭嘉宾阵容和主题设定,这场炉边对话已经具备足够的讨论价值。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。