Flux 3 Action 发布:7B参数动作世界模型解析
BFL 推出 7B 参数的 Flux 3 Action 动作世界模型,将 FLUX 视觉智能延伸至机器人与模拟器动作控制。
Black Forest Labs 发布了 Flux 3 Action,一个拥有 70 亿参数的动作世界模型,旨在将 FLUX 系列积累的视觉理解能力转化为机器人、模拟器和游戏中的可执行动作。与纯图像生成不同,动作世界模型需要对环境状态建模,并预测特定动作后的状态变化,本质上与"预测下一帧"的逻辑相通,因此社区讨论其延伸至视频生成的潜力。本次发布同步释放了基座模型,引发开源社区对完整 Flux 3 dev 版本的强烈期待——基座模型意味着更大的二次开发空间,有望在机器人学习与具身智能领域催生丰富的下游应用。官方主要将其定位于机器人动作决策场景,视频生成等延伸用途尚待实测验证。
Black Forest Labs(BFL)近日推出了 Flux 3 Action,一个拥有 70 亿参数的动作世界模型(Action World Model)。这一发布在 Reddit 社区引发了不少讨论,也让人重新审视图像生成模型向具身智能、机器人控制等方向延伸的可能性。
从视觉智能到动作控制
根据官方描述,Flux 3 Action 的核心定位是:"Turn FLUX's visual intelligence into action for your robot, simulator, or game."(把 FLUX 的视觉智能转化为你的机器人、模拟器或游戏中的动作)。
换句话说,这不再是一个单纯生成静态图像的模型,而是尝试把 FLUX 系列积累的视觉理解能力,映射到可执行的动作空间。这类模型通常被称为"世界模型"(World Model),因为它需要对环境状态进行建模,并预测在特定动作下环境会如何变化。
在社区讨论中,有用户直接把它类比为"vision action model",也就是 vision + action 的组合形态。这类架构在机器人学习(robot learning)领域并不陌生,但由 FLUX 这样以图像生成见长的团队推出,仍然是一个值得关注的方向转变。更多技术细节可以参考官方文档页面(docs.bfl.ai)以及模型主页(bfl.ai/models/flux-3-action)。
动作世界模型(Action World Model) 是近年来机器人学习与具身智能领域的核心概念之一。它的基本思路是:让模型学会在给定当前观测(通常是图像或视频帧)和动作指令后,预测环境的下一个状态。这与传统的图像分类或生成任务有本质区别——模型不仅要"看懂"世界,还要理解"如果我做某个动作,世界会变成什么样"。早期的代表性工作包括 DeepMind 的 Dreamer 系列,以及 OpenAI 在 Dota 2 中使用的环境模型。近年来,随着大规模视觉-语言模型的兴起,研究者开始探索用预训练视觉表征来初始化世界模型,以降低数据需求并提升泛化能力。Flux 3 Action 选择在 FLUX 的视觉基础上构建动作预测能力,正是沿用了这一思路:利用已经在海量图像数据上训练好的视觉表征,避免从零学习环境的视觉结构,而是将重心放在动作-状态转移的建模上。
世界模型与"预测下一帧"
讨论中一个颇有价值的观点来自社区用户的追问:这个模型是否"像预测下一帧那样工作",以及"能否用于视频生成"。
这个问题触及了动作世界模型的本质。一个理想的世界模型,本质上就是在给定当前状态和动作后,预测下一个状态(往往表现为下一帧画面)。这种"下一帧预测"的能力,与视频生成有着天然的相通之处——视频生成也可以看作是在连续时间上不断预测后续帧。
因此,如果 Flux 3 Action 确实具备逐帧预测能力,那么它在理论上具备被用于视频生成、仿真环境构建的潜力。不过需要强调的是,这一推测目前仍停留在社区讨论层面,官方并未明确将其定位为视频生成工具。它的主要应用场景仍聚焦于机器人、模拟器和游戏中的动作决策。
开源基座模型带来的期待
社区讨论中呼声较高的一点,是 BFL 这次同时释放了该模型的"base model"(基座模型)。
有用户表示:"希望这是完整 dev 模型即将到来的信号!同时有意思的是他们释放了这个模型的基座版本。如果我们能拿到完整的 Flux 3 dev 基座模型以及一个蒸馏版本,那将是巨大的利好。"
这一期待反映了开源社区一贯的诉求:基座模型意味着更大的二次开发空间。相比只提供推理接口或蒸馏后的轻量版本,开放基座模型能让研究者和开发者在其之上进行微调、迁移到特定任务,甚至构建全新的应用管线。对于 FLUX 生态而言,如果后续能开放完整的 Flux 3 dev 基座及配套蒸馏版本,无疑会显著扩大其影响力。
在大模型生态中,基座模型(Base Model)与蒸馏模型(Distilled Model) 的区别对开发者影响显著。基座模型是在大规模数据上完成预训练但未经特定任务微调的原始版本,保留了最完整的参数空间与泛化潜力,适合研究者在其基础上进行 Fine-tuning、LoRA 训练或任务适配。蒸馏模型则是通过知识蒸馏技术,将大模型的"知识"压缩到更小的学生模型中,以牺牲部分灵活性换取推理速度和部署成本的降低。对于 FLUX 这类图像/视觉生成模型,社区通常期待同时拥有两者:基座模型用于深度二次开发,蒸馏版本用于快速集成进产品。此前 Flux.1 系列正是凭借开放 dev 和 schnell 等版本,在 ComfyUI、Diffusers 等生态中迅速积累了大量社区应用。因此,Flux 3 Action 基座模型的释放,被社区视为完整 Flux 3 开源生态即将落地的前兆。
社区的轻松试水与真实需求
Reddit 帖子下的氛围既有玩梗也有实际探讨。有人调侃"我把模型装到扫地机器人上,它逃跑了",也有人接梗问"它有没有推翻你的政府、召唤外星人入侵、或者打开通往地狱的传送门"。
这些玩笑背后其实反映了一个真实的好奇心:一个动作世界模型接入真实硬件(如 Roomba 扫地机器人)后,究竟能展现出多强的实时决策与环境适应能力。将视觉模型的输出直接连接到物理执行器,是具身智能落地过程中绕不开的一环,而社区用户显然已经跃跃欲试。
小结
Flux 3 Action 作为一个 7B 规模的动作世界模型,代表了 FLUX 系列从纯图像生成向具身动作控制拓展的尝试。它的核心价值在于把视觉智能转化为可执行动作,潜在应用覆盖机器人、模拟器与游戏。
目前来看,模型基座版本的释放是最受关注的亮点,也让社区对完整 Flux 3 dev 版本充满期待。至于它能否胜任视频生成、以及在真实硬件上的表现如何,仍有待更多实测验证。感兴趣的开发者可以前往官方文档与模型主页获取详细信息。
相关推荐
修复波托贝洛警局大钟:一次硬核工程实践
Hacker News 热帖《修复波托贝洛警局大钟》引发284次点赞讨论。本文分析公共时钟修复的技术挑战、逆向工程难点及其对开发者的启示。
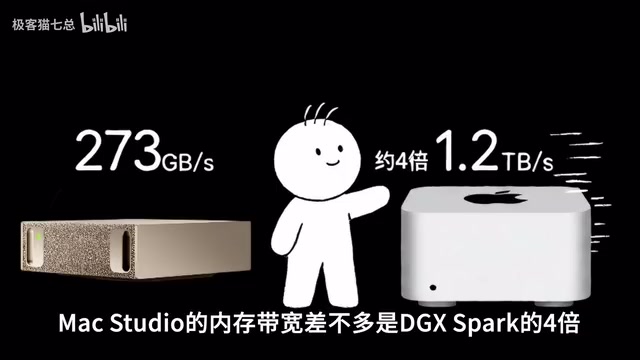
DGX Spark 对决 Mac Studio M5 Ultra:本地跑AI该选谁?
DGX Spark 与 Mac Studio M5 Ultra 谁更适合本地跑AI大模型?本文从内存带宽、Pre-Fill/Decode推理阶段、MoE模型、多机扩展与软硬件生态五个维度深度对比,帮你做出选择。

M5 Ultra AI性能实测:矩阵算力翻近5倍的最强AI Mac
M5 Ultra AI性能实测:本地视频生成、大模型Prefill与Decode全维度对比M3 Ultra,矩阵算力提升近5倍。深度解析Neural Accelerator与Ultra Fusion架构,为何它是最强AI Mac。