付费Muse能否取代ChatGPT?实测等待与工作流差异

Muse 擅长异步定时任务,ChatGPT 胜在即时对话,二者应按时间轴分工而非二选一。
Meta 的个人 AI 代理 Muse 在日本开放使用,其云端虚拟机可后台执行定时信息收集与摘要任务,但生成完整成果物时等待时间显著,根源在于每用户仅分到两核 CPU、7.7GB 内存且无 GPU 的隔离虚拟机。付费升级只放宽 token 配额与请求上限,不提升虚拟机规格,物理等待不会骤减。相比之下,ChatGPT 凭借流式输出和共享 GPU 集群实现秒级即时响应,支持对话中反复修正与多窗口并行。文章结论是:两者角色根本不同,应按任务的时间轴分工——即时对话与并行处理交给 ChatGPT,可提前交代的后台循环任务交给 Muse。
Meta 推出的个人 AI 代理 Muse 已在日本开放使用,它能按预定时间自动完成信息收集、内容摘要等任务,哪怕你关掉电脑,云端虚拟机也会继续工作。这种「异步自动化」体验让不少人产生一个直觉:既然付费升级 Muse 就能得到更强的 AI 助手,那 ChatGPT 是不是可以卸载了?然而在实际日复一日的使用中,等待时间这堵墙会让人重新思考两者的关系。
Muse 真正的强项:定时任务与异步交付
Muse 最让人省心的地方,是替人完成那些「每天固定发生、但不需要当场盯着」的例行公事。比如美股收盘后自动汇总主要指数走势,或者在你喜欢的 YouTube 频道、播客更新后抓取字幕、提炼要点,等你打开屏幕时结果已经摆在面前。据 YouTube 频道 CrossOver Mind 的分析,Muse 的关键价值在于它不仅执行任务,还接管了「什么时候该去收集信息」这个判断本身。找资料、打开页面、阅读、摘出重点,单看每一步都只花几分钟,但每天重复累积就是可观的时间开销。在这种非同步的循环任务里,Muse 的表现被评价为压倒性地可靠。
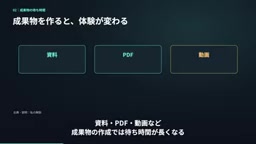
问题出在任务类型切换的那一刻。当需求从「巡逻与摘要」变成「产出一份完整成果物」,体验会急转直下。
即时生成遇上漫长等待
以制作一张旅行宣传单为例,Muse 的进度界面会依次列出观光地调查、图片收集、版式设计、字体确认等一长串步骤。最终成品也许只是简单一页,但背后是它在网页间检索、下载素材、调用专用工具渲染。全自动本身是突破,可当你此刻就要用这份资料、想边看边改时,几十分钟的等待就成了硬约束——这段时间你无法推进下一步。
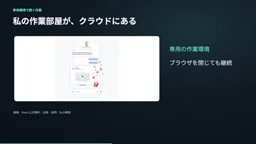
相比之下,ChatGPT 的节奏完全不同:提交提示词后文字与代码立刻流式输出,你可以在生成途中插话要求「这句再简洁些」「结构换一下」,以秒级 tempo 反复修正。多开几个对话窗口并行处理不同任务,对 ChatGPT 来说也是常规操作。这种即时性来自架构差异:ChatGPT 由超大规模服务器集群对输入即时计算并流式返回,而 Muse 走的是另一条路——Meta 为每位用户分配一台云端隔离的 Linux 虚拟机,即 MUSE Secure VM。
流式输出(Streaming Output) 是大语言模型对话体验的关键技术。传统 API 调用需要等待模型生成完整回答后才一次性返回,而流式输出通过 Server-Sent Events 或 WebSocket 将 token 逐个推送给前端,用户看到文字像打字一样逐字浮现。这带来两个好处:一是感知延迟大幅降低,用户不必干等几十秒;二是支持“中途干预”——在生成过程中追加指令,模型可基于已有上下文调整后续内容。ChatGPT 的即时感正源于此,而 Muse 的异步任务模式天然不适合流式交互,因为它的产出是完整的文件或报告,而非可逐字阅读的对话。
等待的物理根源:一台「手脚」不够强的虚拟机
根据使用者的验证与调查,这台虚拟机的配置相当克制:CPU 是从服务器级 AMD EPYC 芯片切出的两个虚拟核心,内存仅 7.7GB,完全没有 GPU,操作系统为 Ubuntu 24.04 LTS。这里必须区分「大脑」和「手脚」:Muse 的大模型推理本身跑在 Meta 的大规模 GPU 服务器上,但按推理指令去启动浏览器、加载页面、下载文件、渲染视频和 PDF 的体力活,全由这台小机器承担。7.7GB 内存扣掉系统占用后留给作业的约 6GB,开着重网页同时下载素材、并行渲染,资源显然吃紧。因此 Muse 自己也说明,语音合成、视频输出这类高负载处理不会同时运行,而是一个接一个排队。这就是等待时间的物理来源。
虚拟机隔离(VM Isolation) 是云服务中常见的多租户安全机制。Muse 为每位用户分配一台独立的 Linux 虚拟机,意味着你的任务运行在与其他用户完全隔离的操作系统实例中,文件、浏览器会话、进程互不干扰。这种设计在安全性和可复现性上有优势,但代价是资源固定且难以弹性伸缩——每个 VM 的 CPU 核心、内存和 GPU 在创建时即确定,无法像无服务器架构那样按需瞬时扩容。相比之下,ChatGPT 的推理服务运行在共享的 GPU 集群上,通过动态批处理将多个用户的请求合并计算,从而在保证吞吐的同时降低单次延迟。两种架构的取舍直接决定了“即时对话”与“后台作业”的体验差异。
付费升级能买到什么,买不到什么
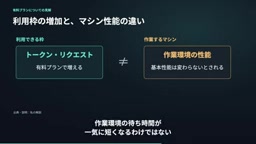
这是最容易被误解的一点。按目前官方信息与用户确认,付费并不会改变虚拟机的基本性能——两核 CPU 和 7.7GB 内存维持原样。付费主要放宽的是 token 配额和请求上限,而不是把「作业房间」扩建。物理等待时间因此不会因为付费而骤减。
更微妙的是 token 消耗与自主任务之间的权衡。免费版在资讯类任务上提供的 token 相对宽裕,但付费后交给它难度更高的工作,AI 试错推理的次数会激增:复杂调研、资料制作或带创意图像处理的任务,往往伴随数十次工具调用与自我检查,token 消耗像滚雪球一样上涨。结果是,想让它全天候常驻跑任务,反而可能被高难度作业吸干资源,原本计划的例行任务无法维持。
Token 配额与请求上限 是 AI 服务商控制成本和滥用风险的核心手段。Token 是模型处理文本的基本单位,一次复杂任务可能消耗数万甚至数十万 token,涵盖输入提示、工具调用描述、中间推理步骤和最终输出。免费版通常提供较宽松的 token 额度以吸引日常轻量使用,但付费版在开放高难度任务的同时,往往设置更严格的单次请求上限或速率限制,防止少数用户耗尽共享资源。对于自主代理而言,token 消耗与任务复杂度呈非线性关系:每次工具调用、每次自我检查都需要重新输入上下文,导致 token 用量滚雪球式增长。因此,付费升级看似“更强”,实则可能因高难度任务吸干配额,反而无法维持全天候的例行循环任务。
选择的关键不是「谁更强」,而是时间轴
把工具约束看清之后,分工边界也就浮现了。判断依据不只是任务种类,更是成果物什么时候需要。眼前就要用、必须盯着屏幕等完成,这种用法完全浪费了 Muse 的强项,机器性能带来的等待会直接变成人的拘束时间。反之,几小时后才要、明早才看的东西提前丢给 Muse,等待感会彻底改变:你开会、睡觉的时候,云端虚拟机在默默查资料、整理结果。
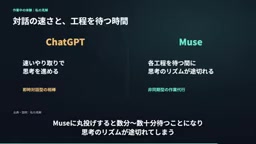
ChatGPT 擅长的则是人正在动手那一刻的即时性。写文章时推敲另一种表达,贴上报错信息当场拿修改方案,通过对话往返几分钟内敲定会议幻灯片结构——这类需要对话节奏的现场,ChatGPT 的即时响应和多窗口并行依旧有明显优势。若把这类工作扔给 Muse,光是启动浏览器、收集素材就要在屏幕前干等数分钟到数十分钟,思考的节奏会被打断。
结论:两种角色,而非二选一
回到最初的问题:付费订阅 Muse 后,ChatGPT 还需要吗?据 CrossOver Mind 的分析,答案是不能合并为其中一个。两者虽同属生成式 AI 技术,承担的角色却根本不同——ChatGPT 是配合人类思考速度、在眼前并跑的即时对话型伙伴;Muse 是你离开现场后仍在幕后推进手续的非同步作业代理。日常固定的信息收集、可以提前交代的循环任务交给 Muse;需要当场集中推进、或多个案子并行快速清理时用 ChatGPT。AI 代理自主行动的时代,真正的问题不是谁更优秀,而是看清一项工作到底需要即时对话,还是可以交给时间在背后完成。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。