高质量LoRA训练全流程指南

高质量LoRA取决于数据、训练、评估构成的闭环,而非单一超参数。
文章回应社区对端到端LoRA训练工作流的疑问,指出高质量LoRA的关键在于数据准备、训练配置、评估迭代构成的闭环。数据环节强调多样样本、独特触发词与准确标注,并留出有区分度的验证集观察过拟合;训练环节需匹配基座模型与推理环境,学习率、步数、网络秩应结合验证集动态调整,正则化图像的使用存在社区分歧;评估环节应基于固定提示词与随机种子的批量生成对比不同checkpoint,而非只看loss曲线。迭代时每次只改变一个变量并保存中间checkpoint。文章最后指出堆步数、堆样本、忽略验证集是三大常见误区。
为什么LoRA训练需要系统化流程
在开源模型生态中,LoRA(Low-Rank Adaptation)已经成为最主流的微调手段:它用极小的参数增量让基座模型掌握新风格、新角色或新任务。但社区里大量讨论集中在"用什么配置",却很少有人把数据准备、训练、评估、迭代串成一条完整链路。Reddit上有用户直接抛出"端到端训练高质量LoRA的工作流是什么"这一问题,恰恰说明碎片化经验难以复用。
高质量LoRA的关键不在于某一个超参数,而在于流程的闭环:数据质量决定上限,训练配置决定能否逼近上限,评估与迭代决定最终产出是否稳定可复现。把这三段拆开看,每一段都有明确的工程准则。
LoRA(Low-Rank Adaptation)的核心思想是冻结基座模型权重,在注意力层等关键模块旁注入可训练的低秩分解矩阵,从而把微调参数量降低到原模型的千分之一量级。其数学形式通常为对权重更新 ΔW = BA,其中 A、B 为低秩矩阵,秩 r 远小于原始维度。这一设计使 LoRA 可以在消费级显卡上完成训练,产出的适配器文件也只有几十到几百 MB,便于分发和组合。正因为可训练参数极少,模型对数据质量和训练配置的敏感度反而更高——少量样本即可显著改变输出分布,这也解释了为什么流程纪律比参数调优更关键。
数据准备:决定LoRA质量的上限
数据集构建原则
数据集是LoRA训练中最容易被低估的环节。风格类LoRA通常需要覆盖目标风格的多样样本,角色类LoRA则需要多角度、多表情、多场景的素材,避免模型只记住单一构图。样本数量并非越多越好,重复或高度相似的图片会加剧过拟合,让模型在推理时丧失泛化能力。
标注质量同样关键。触发词(trigger word)要足够独特,避免与基座模型的常见词汇冲突;标注描述应准确覆盖画面主体与风格特征,而不是堆砌无关标签。很多训练效果不佳的案例,问题根源都在标注与素材的匹配度上。
触发词(trigger word)是 LoRA 推理时激活目标概念的词元锚点。训练时它作为标注的一部分反复出现,模型将其与目标风格或角色绑定;推理时在提示词中加入该词,即可稳定唤起对应特征。触发词设计应避免使用基座模型已有强语义的常见词,否则会与原有概念纠缠,导致输出混入无关内容。常见做法是选用罕见拼接词或专有名词,并在训练前用基座模型测试该词是否已有明显先验响应,确保它是一块相对干净的语义画布。
数据清洗与划分
训练前应做两件事:一是剔除低分辨率、模糊、水印明显的样本;二是留出一小部分样本作为验证集,用于观察训练过程中的泛化表现。验证集不必很大,但必须与训练集在内容上有区分度,否则无法反映真实的过拟合程度。
训练配置与实操要点
基座模型与分辨率选择
基座模型的选择直接影响LoRA的适用场景。不同架构的模型对LoRA的兼容性和表现存在差异,训练前应确认目标推理环境所用的模型版本,避免训练与推理不一致导致效果衰减。分辨率方面,应与素材的实际尺寸和目标生成尺寸匹配,盲目拉高分辨率会增加显存压力,却不一定带来质量提升。
关键超参数的作用
学习率、训练步数、batch size、网络秩(rank)是影响结果的核心变量。学习率过高容易导致风格崩坏,过低则训练不足;步数需要结合样本量和验证集表现动态判断,而不是套用固定值。网络秩决定了LoRA的表达能力上限,风格类任务通常不需要过大的秩,角色类任务可能需要更高容量。
正则化图像(regularization images)的使用在社区中存在分歧:支持者认为它能缓解过拟合、保留基座模型的通用能力;反对者则认为它增加了流程复杂度,且效果因任务而异。实践中可以先不用,出现明显过拟合再引入对照实验。
网络秩(rank)指低秩分解矩阵的中间维度,决定 LoRA 可表达的特征容量。秩过小会限制模型学习复杂概念的能力,秩过大则增加过拟合风险与适配器体积。实践中风格、画风类任务常用 4–16 的秩,角色或复杂概念类任务可能用到 32 以上。与之配套的还有 alpha 参数,通常设为秩的 1–2 倍,用于缩放低秩更新的幅度。理解秩与 alpha 的配合关系,比单独调某一个值更能控制训练的动态范围。
评估、迭代与多源经验交叉
如何判断LoRA训练成功
评估不能只看训练loss曲线。更可靠的做法是在固定提示词和固定随机种子下,用验证集提示词批量生成图像,横向对比不同checkpoint的表现,重点关注:风格一致性、提示词遵循度、是否出现素材污染(如无关元素混入)、以及换用新提示词时的泛化能力。
checkpoint 是训练过程中按固定步数间隔保存的模型快照。由于 LoRA 训练常出现先学会目标特征、随后逐渐过拟合素材的曲线,最终步的产物未必最优。保留多个中间 checkpoint,并配合验证集批量生成横向对比,可以定位质量峰值所在的训练阶段。这一习惯将训练从一次性的黑盒投入,转变为可回溯、可比较的多次采样,是低成本试错的基础设施。
迭代策略
单次训练很少能直接得到最优结果。常见迭代路径包括:调整数据集配比、修正标注、更换checkpoint、微调学习率。每次只改变一个变量,才能定位问题来源。保存多个中间checkpoint,也是低成本试错的关键习惯。
Reddit上这一提问之所以引起共鸣,是因为社区经验往往分散在各自的成功案例里。把数据、训练、评估三段串成可复现的流程,比追逐某个"神奇参数"更有价值。不同来源的实践都指向同一结论:数据质量与评估纪律,比配置细节更能决定LoRA的最终质量。
常见误区与建议
把训练步数拉到极高、堆砌样本数量、忽略验证集,是新手最常踩的三个坑。高质量LoRA的本质是让模型学到可泛化的特征,而不是记住训练素材。建立"小步快跑、单一变量、验证先行"的习惯,比一次性投入大量算力更有效。
对于刚入门的开发者,建议从一个小而精的数据集开始,跑通完整流程后再逐步扩展;对于有经验的训练者,值得把评估环节标准化,形成可复用的检查清单。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
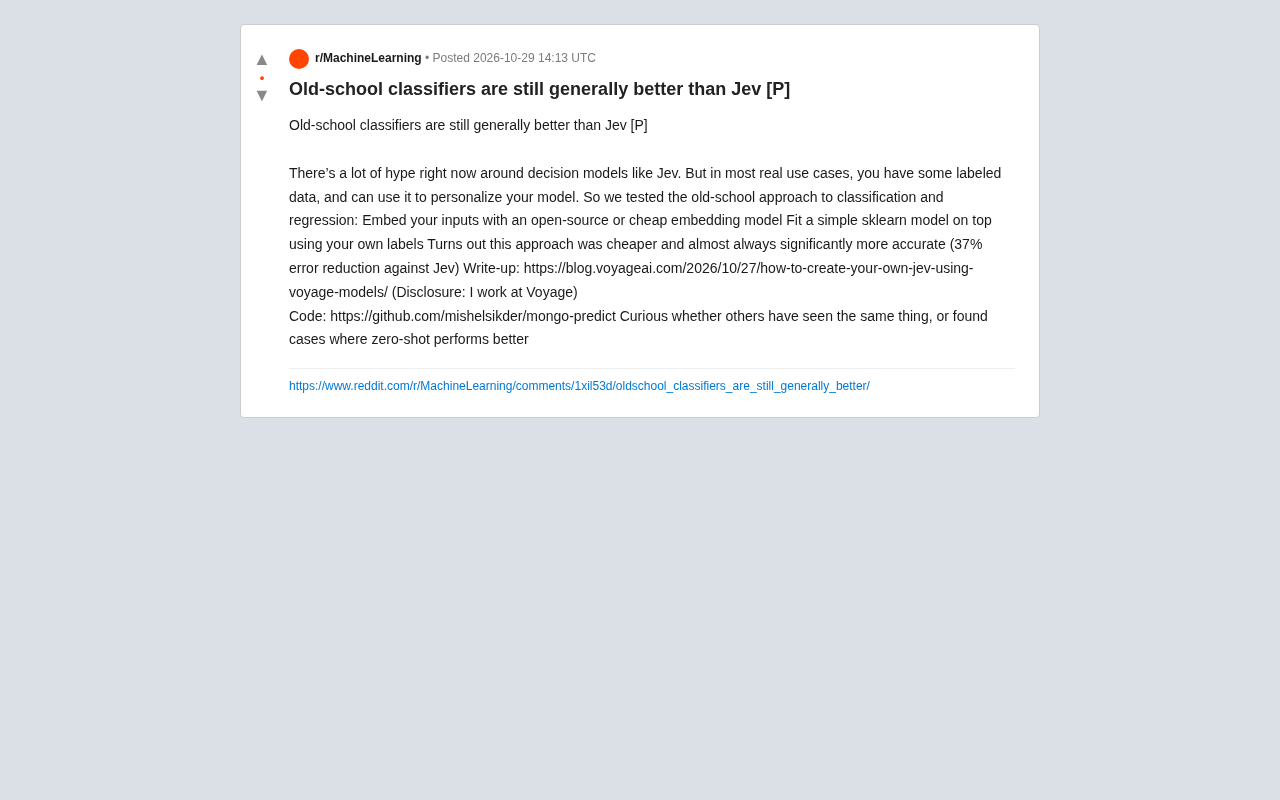
老派分类器仍胜Jev:嵌入+sklearn误差降37%
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。