Gemini 4 Argon 发布:谷歌AI重返竞争?早期性能解析
谷歌 Gemini 4 Argon 限量发布,以百万 Token 输出、低幻觉率和多模态能力冲击第一梯队。
谷歌最新推出的 Gemini 4 Argon 目前仍处于限量测试阶段,面向少数安全合作伙伴与可信测试者开放,公开发布预计在十月中旬前后。本文基于早期泄露测试梳理其核心亮点:最大输出提升至 100 万 Token,让 Agent 长周期任务不再轻易"断片";在 DeepSway 1.1、Automation Bench、LV Bench 等多个综合基准上刷新纪录;幻觉率优于 GPT-6.1 SoC 和 GPT-6 Astra;首发每任务成本仅为 Astra 的约 60%,性价比突出。多模态与 3D 生成被认为是其最强项,体素神社、3D 物理飞机等演示令人印象深刻。但编程与精细操作任务上 GPT 和 Opus 系列仍有优势,且上述数据多来自未经官方确认的渠道,正式结论有待公开评测验证。
谷歌在AI模型迭代上的节奏快到让人目不暇接。最新发布的 Gemini 4 Argon(部分爱好者因托尔金作品昵称其为 Eragon)目前仍处于限量发布阶段,仅向少数网络安全合作伙伴,以及通过 Google DeepMind 相关测试项目遴选出的可信测试者开放。据称后续将逐步向付费 API 客户和 Google AI Ultra 订阅用户开放,公开发布的时间点可能在十月中旬附近——不过这一时间仍属推测。
本文基于一位B站UP主转述的海外早期测试内容,对 Argon 的核心参数、基准成绩与实际演示做一次梳理。需要提醒的是,部分数据来自未经官方确认的泄露渠道,读者应保持审慎。
100万 Token 输出:Agent 任务的关键跃升
这次发布最直观的升级,是 Argon 把最大输出从此前的约 6.4 万 Token 提升到了 100 万 Token。对大规模、长周期的 Agent 和编程任务来说,这意味着模型可以在单次轨迹(trajectory)内处理成千上万的 Token,持续推理与生成而不轻易"断片"。
上下文窗口同样扩展到 100 万 Token。配合较低的幻觉率,Argon 被定位为一个适合日常高频使用的助手型模型,而非单纯的榜单冲分工具。
Token 是大语言模型处理文本的基本单位,大致对应英文中的半个单词或中文的一个字符。"最大输出 Token 数"决定了模型在单次响应中能生成多少内容,而"上下文窗口"则限定了模型在推理时能同时"看到"的总信息量(含输入与历史对话)。此前主流顶级模型的最大输出普遍在 4,000 至 64,000 Token 之间,100 万 Token 的输出上限意味着模型可以在不中断的情况下一次性生成相当于数本长篇小说的文字,或者在 Agent 任务中持续执行数千步操作而无需人工干预"续接"。对于需要生成完整代码库、长篇报告或端到端自动化流程的场景,这一参数的提升是质变而非量变。
基准测试:强在综合,而非单点
从公开的测试结果看,Argon 的特点是"全面但不极端"。
文本与智能表现
在 Text Arena 的智能工作维度上,Argon 的表现据称超过了 GPT-6 Astra、Fable 5.1 乃至 Opus 5.5 等对手。它在多个长周期真实任务基准上刷新纪录:
- DeepSway 1.1(真实世界长周期软件工程任务):77.9%,创下新 SOTA;
- Automation Bench(端到端业务流程):拿到第一,51.3%;
- LV Bench(视频/长内容理解):91%,刷新纪录;
- 在涵盖金融、编程、法律、税务等真实职场场景的 Boss Index 上同样领先。
多模态理解被认为是 Argon 目前最突出的强项,据称已超过任何现代同类模型。不过在纯粹的 Agent 编程和电脑操作任务上,GPT-6.1 SoC 在某些特定场景仍略胜一筹。
幻觉率的改善
另一个亮点是幻觉率。在"智商 45 分以上占比"这类指标上,Astra 为 51%、GPT-6.1 SoC 为 54%,而 Argon 的表现据称更低。对把模型当作日常工作工具的用户来说,这比刷高某个单项分数更有实际价值。
性价比:不是最便宜,但综合最划算
Argon 的定价策略值得单独讨论。根据 Intelligence Index 的数据:
| 模型 | 每任务成本(约) |
|---|---|
| GPT-6.1 SoC | 0.72 美元 |
| GPT-6 Astra | 3.26 美元 |
| Opus 5.5 | 5.98 美元 |
| Fable 5.1 | 7.63 美元 |
Argon 在 Artificial Analysis Index 上得分 53,与 GPT-6 Astra 完全持平,仅比 GPT-6.1 SoC 低 1 分。而在首发价格下,其每次任务成本仅为 Astra 的约 60%。
换句话说,Argon 既不是最便宜的顶级模型,也不是绝对最强的那个,但当你把智能、性能、低幻觉、超大输出、价格放在同一张表里权衡时,它的综合竞争力相当突出。能否保留这个首发价,将直接决定它能否把用户重新拉回 Gemini 生态。
规模猜测:可能是更大的模型
路透社提到的一个细节是,Argon 的规模据说比谷歌此前的 Gemini 模型更大。这意味着谷歌在大幅提升推理能力和整体性能的同时,也把模型本身做得更大。
有推测称这可能是一个 6 万亿参数量级的模型,甚至更多——但这一数字目前没有任何官方确认,纯属猜测,读者不宜当真。
模型参数量是衡量神经网络规模的核心指标,代表模型中可训练权重的总数量。参数量越大,模型理论上能编码的知识容量和表达复杂模式的能力也越强,但训练与推理的计算成本同样呈超线性增长。目前已公开的顶级模型中,GPT-4 据估计约为 1.8 万亿参数(混合专家架构),Meta 的 Llama 系列开源模型最大为 4050 亿参数。若 Argon 的参数量确实达到 6 万亿量级,将远超现有任何已知模型,在工程和算力层面都是极具挑战性的规模。值得注意的是,现代超大模型普遍采用混合专家(MoE)架构,即总参数量中每次推理只激活一部分"专家"子网络,因此"6 万亿总参数"并不等于每次推理都需要调动全部算力,实际运行成本可能远低于字面数字所暗示的程度。
实际演示:3D 与多模态是真正的看点
泄露的测试样本展示了 Argon(及相关 checkpoint)在生成任务上的能力:
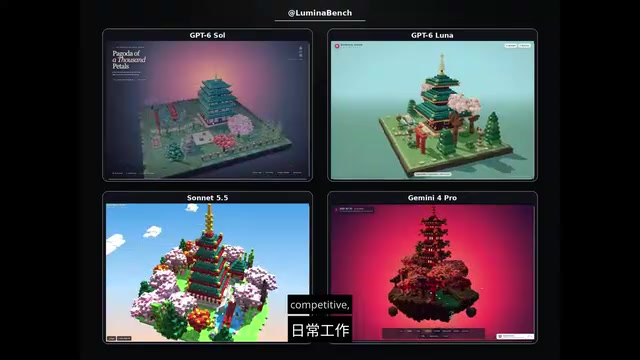
- 体素场景生成:完整生成了一座神社,使用超过 10.6 万个体素细节,且支持动态调整一天中的时间,从而改变场景光照与氛围;
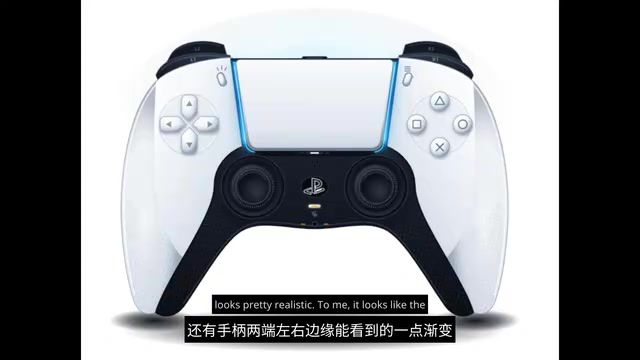
- SVG 生成:生成的 PS5 手柄 SVG 相当逼真,整体效果与 Opus 5 接近,仅在纹理和边缘渐变上略有瑕疵;
- 3D 物理模拟:在"带物理模拟的 3D 飞机"挑战中,Gemini 4 的画面、物理效果和性能明显领先 Opus 5;
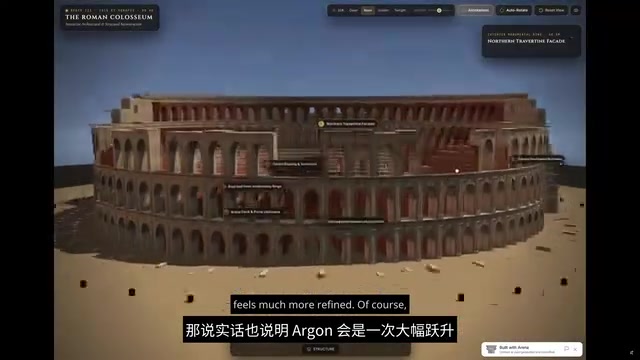
- 复杂场景:罗马斗兽场带昼夜循环模拟、机械蜜蜂、万圣节角色等生成结果,细节与深度相比上一代 Gemini Pro 有肉眼可见的提升。
在与 GPT-6 的并排对比中,Gemini 4 用 3DGS(3D Gaussian Splatting)类技术重建了包含动态铁轨、不同材质与颜色的 3D 世界,表现被评价为"惊人"。
3D Gaussian Splatting(3DGS)是近年来新兴的一种三维场景重建与渲染技术,由 2023 年的研究论文提出并迅速引发业界关注。与传统的 NeRF(神经辐射场)方法相比,3DGS 使用数百万个可微分的三维高斯椭球体来表示场景,渲染速度快数个数量级,能实现实时帧率的新视角合成。将其与大语言模型的生成能力结合,意味着模型不仅能"理解"三维场景的文字描述,还能直接输出可用于实时渲染的结构化三维表示,这是多模态能力从"看图说话"向"凭空建模"迈进的重要标志。体素(Voxel)则是三维空间中的像素等价物,代表固定网格上的一个立方体单元;10.6 万个体素构成的神社场景在细节密度上已接近专业游戏美术的手工建模水准。
定位判断:日常好手,而非编程首选
综合来看,Argon 并不是编程或网页开发的最佳现成模型——在这些领域,GPT 和 Opus 系列仍凭借持续的能力积累保持优势。Argon 真正的舒适区在于多模态理解和日常基础任务,这也正是 Gemini 一贯的长板。
值得留意的是模型迭代背后的"反馈循环"。谷歌表示 Argon 已经在帮助其研究人员和工程师处理算法相关工作及公司内部其他领域——当 AI 系统越来越多地被用来优化、评估甚至构建下一代 AI 时,研发节奏可能会进一步加速。但要据此断言"已接近某种临界点",目前并没有任何证据支撑。
小结
对谷歌而言,Argon 更像是一次在经历短暂低谷后的"漂亮翻盘"。它在文本、多模态、输出规模和性价比上的综合提升,让 Gemini 重新具备了参与第一梯队竞争的资格。最终体验如何,还要等它正式向公众开放后由完整评测来验证——在此之前,上述数据与演示都应被视为早期、部分未经证实的参考。
相关推荐

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。
用WhatsApp对话你的AI Agent:开源工具agent-bridge实测解读
开发者开源了AI Agent工具agent-bridge,可通过WhatsApp自我聊天直接与Agent框架对话。本文解读其TypeScript实现、npm包使用方式及这类IM交互工具的优势与风险。