Gemini 4 Argon:谷歌新前沿模型能否重返牌桌?

Gemini 4 Argon 基准与口碑两极化,关键问题已从“它有多好”变为“它适合放在模型栈的哪个位置”。
Gemini 4 Argon 正式开放测试,基准表现呈现明显分化:知识工作与法律 Agent 评测达到前沿最优,编程能力却落后于 Opus 5.5、Astra 等竞品,且高度依赖 harness——在 anti-gravity CLI 上接近 Opus 5.5 Max,在 Gemini CLI 上则明显不佳。多模态与 3D 代码生成是真正的差异化优势,写作能力被专业写作者视为隐藏强项,可充当“编辑伙伴”。定价在折扣期极具竞争力,补贴后仍约为 Anthropic 模型的三分之二。谷歌对 Pro 与 Ultra 用户区分 coding 权限引发开发者不满。整体判断是:Argon 不是全能冠军,而是一个需要重新理解、按场景定位的模型。
Gemini 4 Argon 来了,但问题变了
两周前宣布,如今谷歌的 Gemini 4 Argon 正式开放测试。基准测试亮眼,但社区反馈两极分化严重。AI Daily Brief 主播提出了一个关键判断:关于前沿模型的问题已经从"它有多好"转变为"它适合放在哪里"。
换句话说,用户不再问"我要不要切换到新模型",而是问"这个模型在我的模型栈里能承担什么独特角色"。这个视角转变,恰好是理解 Argon 的最佳切入点。
Argon 建立在全新的预训练基础上——谷歌此前砍掉了 Gemini 3.5 Pro 的发布计划。模型规模未被披露,但谷歌将其定位为与 Astra、Fable 同级别的超大模型。
基准测试:知识工作领先,编程落后
从纸面数据看,Argon 在多个维度达到了前沿水平。知识工作方面,它在 VALS 指数、Automation Bench、VALS Finance Agent 和 Harvey 法律 Agent 基准上均取得最优成绩。Harvey 法律基准上,Argon 领先第二名 Fable 5.1 达 13 分,差距显著。
编程表现则复杂得多。Argon 在 DeepSuite 上略微领先 Opus 5.5,但在 Frontier Suite 上落后三大竞争对手约 10 分,在 Terminal Bench 4.0 上落后 Opus 5.5 约 9 分。不过基准测试本身近期更新导致分数整体收窄,Argon 仍处于前沿区间,只是不在最前列。
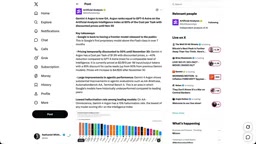
成本方面,Argon 在 API 上提供了 11 月 30 日前 50% 的折扣。在 Artificial Analysis 的独立评测中,Argon 完成基准任务仅需每任务 1.99 美元,与 GLM 5.3 相近,明显低于除 Sol 6.1 外的所有前沿竞品。补贴结束后,Argon 将比 Astra 更贵,但仍约为 Anthropic 模型价格的三分之二。
综合来看,Argon 像是"打折的前沿 AI"——这理论上应该让谷歌重新回到竞争中。
关于几个关键基准的补充说明:
- VALS 指数:由 Vals AI 维护的综合评估体系,覆盖知识工作任务,强调真实场景中的多步骤推理与工具使用能力。
- Automation Bench:衡量模型在自动化工作流(如数据处理、脚本执行、表单填写)中的端到端任务完成率,比单轮问答更贴近实际部署场景。
- Harvey 法律 Agent 基准:由法律 AI 公司 Harvey 发布的专业评测,任务涵盖合同审查、判例检索、法律备忘录起草,要求模型在长篇材料中保持精确引用。
- Frontier Suite / Terminal Bench 4.0 / DeepSuite:编程与终端操作类基准。Frontier Suite 侧重复杂代码库理解与多文件修改;Terminal Bench 4.0 模拟真实终端环境下的 shell 命令链执行;DeepSuite 则更偏向算法与竞赛题。三者评分逻辑不同,因此 Argon 在其中表现差异较大并不矛盾。
需要特别注意的是,此类基准近期普遍更新了测试集并收紧了评分口径,导致所有前沿模型分数整体下滑,横向比较时应参考同一时间窗口内的数据。
编程能力:争议最大的战场
编程一直是谷歌的软肋。有推测认为,正是编程表现不佳导致 Gemini 3.5 Pro 在夏季被搁置。
开发者 Pavel Hurin 用 bug 猎人任务测试 Argon,结果"不够理想"——表现与 Muse Spark 1.3 相当,明显落后于 Astra、Fable 和 Opus。Railway 的 Noah Dunnigan 更直接:"这个模型在真实代码面前毫无用处。"开发者 Theo 的代码库分析基准显示,Argon 是唯一一个误报率超过 50% 的模型。
但问题可能出在测试环境上。分析师 Max Weinbach 指出,在 anti-gravity 中表现不佳,但在 Claude Code 和 OpenCode 中"非常好"。不过在其他 harness 中使用可能违反服务条款。
更关键的发现来自 Pavel Hurin 的后续测试:在 anti-gravity CLI 而非 Gemini CLI 上运行同一基准,Argon 从"还行"跃升为前沿级别,"非常接近 Opus 5.5 Max"。他跑了三次确认结果。
这暴露了一个发布策略问题——谷歌对 Pro 和 Ultra 订阅者做了区分:Pro 用户只能在 Gemini harness 中使用 Argon,要使用 anti-gravity 需要升级到 Ultra 层级。这引发了开发者的普遍不满。Marcelo P. Lima 的吐槽代表了很多人的心声:"为什么谷歌让人这么难试用他们的新模型?"
分析者 Rishi 的总结颇具代表性:"几亿 token 之后,可以说 Gemini 4 大致等于 Opus 4.8。"
关于 harness 与 anti-gravity 的补充:
“harness”(脚手架/测试框架)指包裹模型的运行环境,包括系统提示词、工具调用协议、上下文管理、报错重试机制等。同一个模型在不同 harness 中表现可能天差地别——因为模型实际接收到的指令、可见文件范围和工具接口都不同。
anti-gravity 是谷歌面向开发者推出的 agentic coding 工具(与 Gemini CLI 并列),主打多 Agent 协作与长上下文代码库操作。文中 Pavel Hurin 的测试说明:Argon 在 Gemini CLI 中可能因为工具调用过于保守或上下文裁剪策略激进而“藏拙”,在 anti-gravity CLI 中则能放开手脚。
订阅分层问题也值得展开:谷歌将 Argon 的 anti-gravity 访问权限限定在 Ultra 层级,而 Pro 用户只能在 Gemini harness 中使用。这意味着多数开发者无法在最佳环境中评测模型,社区不满很大程度上源于这种“能力被订阅墙割裂”的体验,而非模型本身。
多模态与 3D:真正的差异化优势
如果说编程是 Argon 的短板,多模态和 3D 生成则是它的杀手锏。
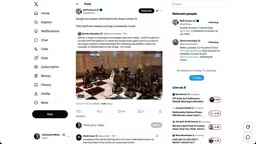
谷歌放出的演示令人惊艳:Demis Hassabis 展示了现代版战斗国际象棋,效果接近 AAA 游戏画质;Chet Aslua 分享的宝塔寺庙群 3D 场景支持多角度漫游。不过有观察者指出,这些演示是多 Agent 协作的成果,成本不菲。
实际用户测试则褒贬不一。Max Techno 用车辆 3D 渲染测试后发现:"车形比 Opus 好很多,但颜色完全褪色,纹理漂浮,UI 还停留在过去。"他甚至怀疑模型是否专门针对热门公开测试做了训练。
但那些探索性用法的反馈截然不同。Venture investor Justine Moore 要求 Argon 构建一个苹果电脑互动博物馆,不提供任何图片或数据——Argon 自行抓取档案照片、写工具清理图像、拉取 50 年规格数据,并构建了随年代变化的 3D Cover Flow UI。The Bugged Dev 给了一张哥特维多利亚马车图片,Argon 从零生成了包含 17.4 万面的 3D 模型,带开门、铰链窗、车轮物理、悬挂和定制骷髅雕刻——全部通过代码生成,未使用 Blender。
Websim Saria 的判断值得关注:"Gemini 4 Argon 是第一个让人感觉图像、视频和语言模型融为一体的模型。"
关于 3D 生成与多 Agent 协作演示的补充:
文中的“3D 生成”并非指传统的文本到 3D 网格模型(如 Point-E、TripoSR 的单次前向生成),而是代码生成式 3D:模型输出 Three.js/WebGL 代码,由浏览器实时渲染。The Bugged Dev 的 17.4 万面马车模型、“开门、铰链窗、车轮物理”都是代码定义的程序化几何——这也是为什么它不需要 Blender 或专业 3D 管线。
Demis Hassabis 演示的“战斗国际象棋”之所以接近 AAA 画质并被指出是“多 Agent 协作”,是因为任务被拆分给多个 Agent:一个负责游戏逻辑、一个负责材质与光照、一个负责 UI,再串联执行。这种模式下成本显著高于单次对话,但展示了 Argon 在长上下文编排与跨模态指令遵循上的潜力。
对开发者而言,理解“代码生成式 3D”的边界很重要:它在交互性和可编辑性上远超传统 3D 生成,但在几何精度和物理正确性上仍依赖模型对渲染管线的理解,因此“颜色褪色、纹理漂浮”这类反馈并不意外。
写作:被低估的强项
Every 的 Dan Shipper 花了整整一周,与五位同事一起在编程、写作、设计、知识工作四个维度测试 Argon,结论出人意料地积极。
"我本来准备好批评这个模型,但结果让我惊喜。"Dan 写道。他的核心发现是:Argon 在重构旧代码时不稳定,但在全新项目中快速高效;在多模态和"动手做东西"方面独特。
而他最推崇的,是写作。"DeepMind 雇了专业编辑来打磨模型的文风,效果显著。我用它来梳理结构、打磨隐喻。它对结构和详细解释有 Astra 和 Opus 缺乏的天然感觉。"
Dan 的工作流建议颇具参考价值:日常对话用 ChatGPT 和 Claude,需要编辑伙伴时切换到 Gemini 4——"用它来梳理复杂文章的结构、打磨隐喻或精读一本书。"他甚至称 Argon 是"被困在过时 harness 里的新模型",暗示 harness UX 的落后拖累了模型体验。
行业思考:模型多样性的价值
Google DeepMind 的 AGI 经济学总监 Alex Emas 提出了一个被忽视的视角:前沿模型的"输出多样性"本身就有价值。
"每个模型在写作、品味、代码上都有独特签名,在设计上尤为明显,比如选择的背景色板。相关信号和先验正是脆弱性、学习陷阱和 AI 垃圾内容的来源。"
Ethan Malek 也印证了这种"不同":"使用 Gemini 4 会让你意识到,其他多少模型在蒸馏 Claude 或 GPT,或使用类似的训练管线。它感觉和别的模型确实不一样。"
但也有开发者对这种"不同"持保留态度。Theo 表示:"这是 Gemini 的巨大进步,价格也很值。但它仍然是 Gemini 模型——经常做奇怪的事,我完全不觉得能信任它。"
关于“输出多样性”与模型蒸馏的补充:
Alex Emas 提到的“输出多样性”可理解为模型在相同提示下产生的分布差异。当大量开源模型通过对 Claude 或 GPT 的合成数据进行蒸馏训练时,它们的输出会呈现相似风格、相似句式、相似错误模式。这种同质化会带来两个后果:一是用户在不同模型间切换时得不到真正不同的视角;二是当某个被蒸馏的“教师模型”存在系统性偏见或漏洞时,整个生态会被同步放大。
Ethan Malek 所说的“其他模型在蒸馏 Claude 或 GPT”,正是指这一现象。Argon 因为建立在全新预训练基础上(且谷歌砍掉 Gemini 3.5 Pro 计划),其输出分布与主流 Claude/GPT 系差异明显——这既是它的卖点,也解释了为什么部分开发者觉得它“经常做奇怪的事”:多样性本身也意味着不可预测性。
从产品策略看,谷歌愿意保留这种“不同”而非简单对齐到主流风格,可能是其在写作与创意场景中形成差异化的重要前提。
结论:一个需要重新理解模型
回到最初的问题——Argon 适合放在哪里?目前的答案仍然是:"还不太确定。"
但有一些方向已经清晰:写作和编辑协作是它被低估的强项;多模态 3D 生成是它的独特赛道;编程能力高度依赖 harness,用 anti-gravity 才能发挥真实水平。
播客主播的总结颇有启发:就像当初对 Astra 的评价一样,Argon 可能需要用户"推动自己去做更难、更奇怪、更意想不到的事情",才能真正看到它的全部潜力。
对于中文开发者来说,实际建议是:如果你在谷歌生态内,Argon 值得认真评估;如果你需要一双"编辑的眼睛"来打磨文字,它是 Astra 和 Opus 之外的独特选择;如果你的核心需求是 agentic coding,可能还需要等 harness 和模型本身进一步成熟。
相关推荐

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。

Claude被曝可在正常图片中隐藏秘密信息
Reddit帖子称Claude Fable 5.1能在正常图片中隐藏秘密信息,本文梳理事件背景、图片隐写技术原理及潜在安全风险,并给出从传闻走向验证的测试路径建议。

AI助手何时该主动建议?时机决定一切
AI助手何时该主动建议?Reddit讨论揭示:同样的建议在不同时机感受迥异。本文分析主动建议的双面性、用户期待的分界线及设计原则,探讨如何平衡自动化与用户控制。