Gemini 4 Carbon登顶智能指数,腾讯Buddy One发布|AI日报

Gemini 4 Carbon 登顶智能指数,工具层编排与路由走向自动化。
本期聚焦前沿模型与工具层的两项变化。Google 发布 Gemini 4 Carbon,高推理版本在智能指数 V5 上以 59 分排名第一,主打网络安全和长程任务,并采取先向防守方、再向受信任伙伴分阶段开放的策略。工具层则出现明显的自动化趋势:GitHub Copilot Fusion 正式可用,用户只需选定力度,由系统决定模型组合与流程;OpenRouter 默认路由从几乎只奖励低价,改为按实际价格、等待时间、吞吐和失败率综合打分。此外,腾讯 Buddy One 打通文档、会议、网盘并共用 WorkBuddy Agent,Diffbot 开源 Clover 在网页操作上以 1.52 秒中位耗时和 13 步优于对比方案,NVIDIA 开源支持 40 种语言、约 1 小时录音的 Nemotron 3.5 Transcribe 转写模型。
前沿模型格局生变:Gemini 4 Carbon 登顶智能指数
Google 发布了 Gemini 4 Carbon,官方称其为当前最强的前沿模型。在智能指数 V5 上,高推理版本拿到 59 分,排名第一。这个模型主打网络安全和长程任务,本周先向一部分网络防守方开放,再经 Frontier 计划逐步提供给其他受信任伙伴。
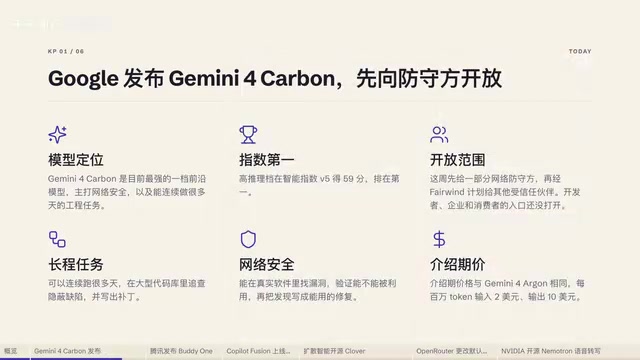
从定位看,Gemini 4 Carbon 并没有走通用聊天模型的路线,而是把能力重心放在安全场景和需要多步执行的复杂任务上。智能指数 V5 的 59 分是目前公开数据中的最高值,说明其在推理深度上具备明显优势。分阶段开放的做法也值得注意——先防守方、后受信任伙伴,这种节奏在以往模型发布中并不常见,反映出 Google 对高能力模型在安全侧落地的谨慎态度。
智能指数 V5 是一套用于横向比较前沿模型能力的基准评测体系,通常由多类高难度任务(推理、编程、长程规划等)加权汇总为单一分数。分数越高,代表模型在复杂、多步任务上的综合表现越强。"高推理版本"指模型在推理时投入更多计算(例如更长的思考链或更多的采样),以换取更高质量的输出,代价是响应更慢、成本更高。因此 59 分应理解为在"重推理"配置下的成绩,与常规对话版本不完全可比。
长程任务(long-horizon tasks) 指需要数十甚至上百步连续操作、跨越多个工具或页面才能完成的任务,其难点在于保持目标一致性、处理中间失败并自我纠错,而非单步回答质量。
腾讯 Buddy One:把办公套件串成个人 Agent
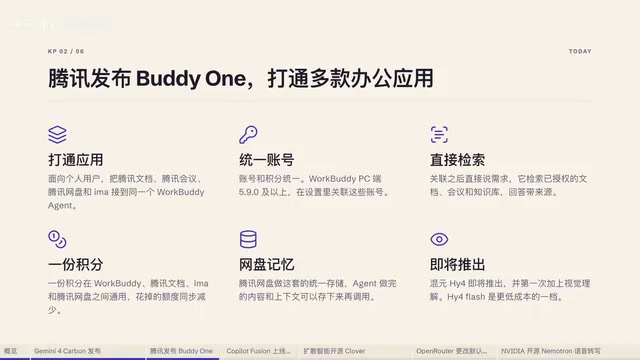
腾讯发布了面向个人用户的 Buddy One。它打通了腾讯文档、腾讯会议、腾讯网盘,并与 ima 共用 WorkBuddy广告 Agent,统一账号和积分体系。
这意味着用户在腾讯生态内的文档、会议、存储等操作,可以由同一个 Agent 统一调度,而不是在每个应用里各用一套助手。统一账号和积分的意义在于降低了跨应用使用的摩擦——用户不需要为不同产品分别维护额度或身份。对个人用户来说,这种整合的价值在于把分散的办公动作收敛到一个入口,减少在多个应用之间来回切换的成本。
GitHub Copilot Fusion 正式可用:从选模型到选力度
GitHub 把 Copilot Fusion 定为正式可用。用户不再需要为每一步手动选择模型,而是选定力度,由 Copilot 决定用哪些模型、按哪种流程配合。
这个变化的实质是把模型编排的决策权从用户转移到系统。过去用户要在不同模型之间做选择,需要理解每个模型的强弱项;现在只需表达任务需要多强的处理力度,剩下的路由由 Copilot 完成。对开发者而言,这降低了使用门槛,但也意味着对底层模型选择的控制权减少。GitHub 选择在这个时间点将其转为正式可用,说明内部对自动编排的稳定性已有足够信心。
模型编排(model orchestration) 指系统根据任务特征,自动决定调用哪个或哪些模型、以什么顺序和流程协作完成请求。常见做法包括:用轻量模型做意图识别与分流,把复杂步骤交给推理更强的模型,再对结果做校验或重试。它的核心权衡是——自动编排降低了用户的理解负担,但用户失去了对具体模型、成本和输出风格的直接控制。"力度"这一抽象层,本质上就是把"选哪个模型"翻译成"这项任务需要多强的处理"。
Diffbot 开源 Clover:网页操作中位 1.52 秒
Diffbot 开源了 Clover,用于写代码、做网页操作和调用工具。在网页操作场景中,Clover 的中位耗时为 1.52 秒,Gemini 3.6 Flash 为 8.86 秒。
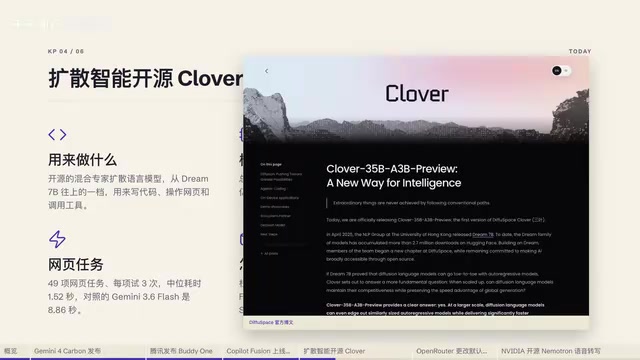
在任务执行步数上,创建项目并邀请成员,Clover 用了 13 步,对比方案用了 21 步。这两个数据指向同一个结论:Clover 在网页操作类任务上同时具备速度和步骤效率的优势。中位耗时相差数倍,步数少了约三分之一,对于需要频繁执行网页操作的 Agent 场景,这种差距会直接体现在可用性上。开源则意味着这套能力可以被更多工具链集成,而不局限于单一平台。
OpenRouter 路由规则大改:从拼低价到综合打分
OpenRouter 对默认供应商路由做了成立以来最大的一次改动。以前默认几乎只奖励更低的输入价格,现在按实际价格、等待时间、吞吐和失败率给供应商打分。
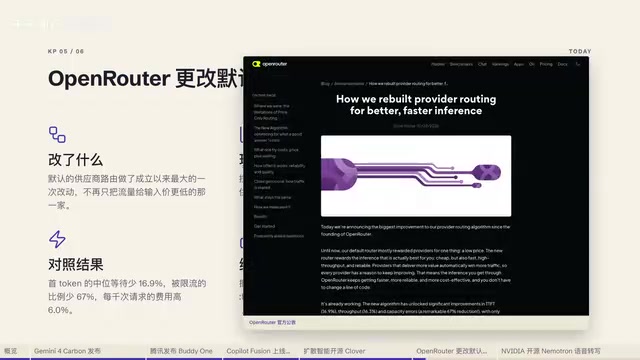
旧规则的问题在于单一维度优化——价格最低的供应商未必是体验最好的。新规则把等待时间、吞吐和失败率纳入评分,等于把用户实际感受到的质量放进了路由决策。对供应商来说,这意味着单纯靠低价获取流量的策略效果会减弱,稳定性和速度变得同样重要。这是路由层从价格竞争转向质量竞争的信号。
供应商路由(provider routing) 是聚合平台在多個后端供应商之间分发请求的机制。同一模型往往由多家供应商托管,彼此在价格、延迟、吞吐和稳定性上存在差异。旧规则几乎只按输入价格排序,会导致请求集中涌向最便宜的供应商,进而推高其排队时间与失败率。新规则把这些运行时指标纳入打分,相当于在成本与体验之间做加权平衡;对用户而言,路由质量变得与模型本身同等重要。
NVIDIA 开源 Nemotron 3.5 Transcribe:40 种语言、约 1 小时录音
NVIDIA 开源了 Nemotron 3.5 Transcribe 转写模型,覆盖 40 种语言,录音最长约 1 小时,可以用自然语言指令决定转写风格,例如逐字转写、书面语、带说话人标签。
用自然语言控制转写风格是这次发布中比较特别的一点。传统转写模型输出格式相对固定,用户要得到逐字稿或书面语版本往往需要后处理。把风格控制交给指令,等于把后处理环节前移到了模型内部。40 种语言和约 1 小时的时长覆盖,加上开源,使其适合被集成到会议记录、内容整理等需要长音频处理的流程中。
说话人标签(speaker diarization) 指在转写结果中标注"谁在什么时候说了什么",需要先做语音分段与说话人聚类,再把文本对齐到具体说话人。它比单纯语音识别更难,因为要处理重叠语音、说话人切换和音色相近等情况。把逐字转写、书面语改写、说话人标签等风格差异统一为自然语言指令控制,意味着模型内部需要同时具备识别、格式化与改写能力,而不是依赖外挂的后处理流水线。
今日观察
这一天的发布集中在两个方向:一是模型能力的边界继续外扩,Gemini 4 Carbon 在推理指数上刷新高位,并选择以安全场景作为落地切口;二是工具层的编排与路由正在变得自动化,Copilot Fusion 把模型选择交给系统,OpenRouter 把路由标准从价格转向综合质量。对使用者来说,直接选模型的机会在减少,表达需求、设定力度正在成为新的交互方式。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。