Gemini 4 Hydrogen 深度评测:高性价比之外的真实价值
Gemini 4 Hydrogen 指数高但非性价比最优,适合作为受限子代理而非主助手替代品。
Artificial Analysis 选型图显示,Gemini 4 Hydrogen High 指数得分较高但已越出最佳价值区,Extra High 档位以更高成本换取更高分数,说明最高分与最优性价比是不同选择。同一分数下,Hydrogen High 在 Automation Bench 上领先 Terra Max,但在 AA 2.0 代码仓库改动任务上被反超,选对任务比宣布通用胜者更重要。Hydrogen 适合处理边界清晰的子代理任务,架构决策等仍应留给主代理。按 API 费率 Hydrogen 并非默认最便宜,Google 订阅包的价值取决于是否用得上附带权益。SynthID 文本水印检测不保证成功,短文本或改写会削弱识别。结论认为 Hydrogen 是出色的受限子代理,但主助手位置仍属 ChatGPT。
划算与更强的分岔路
Artificial Analysis 的选型图上,Gemini 4 Hydrogen High 落在“高性价比象限”的右侧边缘:指数得分更高,但位置已经越出了最佳价值区。同一张图上,Extra High 档位拿到更高的指数分数,代价是每项基准任务的花费也明显上升。这组数据指向一个容易被忽略的结论——最高分和最优性价比,本来就是两个不同的选择。
这张榜单由九项评估合成一个指数,不是简单的百分比准确率;美元成本是加权后的基准任务成本,而非 token 单价或订阅费用。图上横轴是对数刻度下的成本,向上代表更高指数。这份快照从 740 个模型中筛出 31 个展示,仅呈现 Medium 与 High 档位,Low 和 Extra High 落在线外。同类产品中 Terra 和 Soul 也符合入选条件。
Artificial Analysis 指数是第三方评测机构 Artificial Analysis 对多个大模型基准测试结果进行加权聚合后形成的综合评分体系,通常将多项评估(如推理、代码、知识问答等)标准化后合成为一个指数分数,便于横向比较不同模型。该指数并非简单的准确率平均,而是考虑了任务难度和覆盖范围。美元成本则指在固定基准任务集上运行模型所产生的加权平均费用,包含输入与输出 token 成本,而非 token 单价或订阅价格。对数刻度用于展示成本差异跨越多个数量级的情况,使图表更易读。
同一分数,不同强项
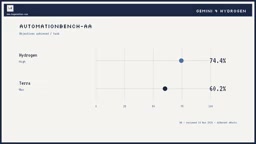
聚合指数会掩盖一项反转:Terra Max 同样拿到 51 分,与 Hydrogen High 持平,但两者分属不同的努力档位,并非同档对比。把视线放到具体基准上,强项开始分化。
在模拟真实商业应用工作流的 Automation Bench 上,Hydrogen High 对 Terra Max 形成明显领先,任务是按单任务计算目标达成比例,护栏违规或报错会让该任务直接归零,而不是整份工作失败。切换到前沿代码场景 AA 2.0 的仓库改动任务,排序翻转,Terra Max 领先于 Hydrogen High。两项评估都采用“越高越好”的评分规则,但努力档位和基准专用框架不同,结果便不再一致。
这意味着,选对任务比宣布一个通用胜者更重要。
Automation Bench 是评估模型在模拟真实商业应用工作流中执行自动化任务能力的基准测试。它按单任务计算目标达成比例,若任务中出现护栏违规或报错,则该任务直接计为零分,而不是整份工作流失败,因此能更细粒度地反映模型在实际业务场景中的可靠性。AA 2.0 则是针对前沿代码场景的仓库级改动任务基准,要求模型在真实代码库中完成补丁或重构,评分规则为“越高越好”,但与 Automation Bench 采用的框架和努力档位不同,因此同一模型在不同基准上的表现可能分化。
作为受限子代理的价值
假如让模型处理“找出接口变更影响的所有调用方”或“在单个模块内打补丁”这类任务,真正决定成败的是输入是否清晰、验收条件是否明确——边界清晰的产出更容易检查。架构决策、跨模块判断、验证和最终呈现仍应留在主代理与审查者手里。
缩小任务范围并不能消除错误,但能给审查一个可管理的目标。局部检查通过,也不代表改动契合项目其余部分。
子代理(sub-agent) 指在主代理或主助手协调下执行特定受限任务的模型实例,通常边界清晰、验收条件明确,便于审查和回滚。与之相对,主代理负责架构决策、跨模块判断、验证和最终呈现。将任务限制在“找出接口变更影响的所有调用方”或“在单个模块内打补丁”等范围,能降低错误传播风险,但局部检查通过并不保证改动与项目其余部分契合,因此仍需主代理进行整体审查。
定价与订阅包的两套账
按标准 API 费率,Hydrogen 的输入与输出价格中包含思考(think-tank)成本;Sonnet 5.5 在默认回退档位下每百万 token 的价格略低,Hydrogen 对应费率处于更低一档,而 Terra 的基础费率更便宜。思考与重试都会改变账单,但这些数字不是实测项目节省额。就单价而言,Hydrogen 并非默认最便宜的那个。
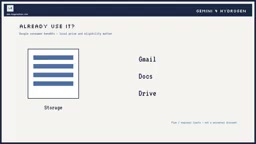
Google 的消费级订阅包回答的是另一个问题:你已经在为什么付费?如果确实用得上附带的存储、Gmail、Docs 或 Drive 等权益,且本地定价合适,这个包会显得很有吸引力。不过它面向合资格的个人账号,受套餐与地区限制,企业 Workspace 授权是另一套体系,也不提供无限 API 额度。换句话说,订阅包可能很值,但不代表它在每项基准上都赢。
垂直整合能带来什么
Google 的独特之处在于同时握有 TPU 设计、模型训练和 anti-gravity 框架。硬件、模型行为与任务路由可以被协同设计,这是单纯的模型厂商难以复制的杠杆。Anthropic 一边采购 TPU 产能,一边在 Trainium 和 NVIDIA 上分散布局;额外的产能预计要到 2027 年之后才会上线,目前尚未到位。Google 同样依赖外部供应商。对 Google 的竞争对手而言,自研框架与自研芯片都是可行路径。
协同是优势,但不是必然胜利。
输出标识规则是不是一票否决项
Google 为 Gemini 应用中的文本和受支持媒体提供 SynthID 标识。文本水印的做法是调整 token 概率,留下统计学痕迹;检测并不保证成功,文本越短或改写越多,越难识别。另有按产品区分的内容凭证,记录来源与编辑历史——它属于内容溯源,不是个人身份追踪,也不等同于训练隐私方面的承诺。
面向通用 Hydrogen API 或代码输出的水印方案,目前尚未确立;其 API 只输出文本。如果文档中写明的识别政策触及你的底线,最直接的做法是避开受影响的产品。
SynthID 是 Google DeepMind 开发的数字水印技术,用于在 AI 生成的文本、图像、音频等媒体中嵌入不可见的统计学标记。文本水印通过调整 token 概率分布留下痕迹,检测时分析这些痕迹判断内容是否由 AI 生成。但检测并不保证成功,文本越短、改写越多,识别难度越大。内容凭证(Content Credentials) 则是一种基于标准的元数据方案,记录内容的来源和编辑历史,属于内容溯源而非个人身份追踪,也不等同于训练隐私承诺。
结论: killer 子代理,而非主助手替代品
制作方的判断相当克制:在自身工作场景中,Hydrogen 在质量与打磨程度上仍落后于 ChatGPT——这是个人体验,不是受控对比;但把它当作边界清晰的子代理,表现非常出色;如果本地定价合适且用得上 Google 订阅包,也值得推荐。主助手的位置,仍然留给 ChatGPT。
它不构成对 ChatGPT 或 Anthropic 的致命打击。真正值得问自己的是:你愿意把哪一部分工作,交给一个受限的、可审查的子代理?
相关推荐
FBI警告的AI黑客工具ARTEX:成本颠覆与防御重构
FBI警告的AI黑客工具ARTEX让渗透测试成本降至150-1500美元,导致金融机构数据泄露和供应链攻击。了解其工作原理、真实案例及五步防御策略。
FBI警告:ARTEX AI黑客工具三小时攻破系统
FBI警告开源AI渗透测试框架ARTEX被犯罪分子滥用,部分入侵在三小时内获得特权访问,超1600个控制台暴露在外,并涉及韩国金融机构数据泄露与ConnectWise供应链攻击。
FBI警告Artex:AI自动化攻击框架威胁云身份安全
FBI警告AI渗透测试框架Artex正被用于自动化攻击:Go编写、AI代理驱动,覆盖侦察到数据窃取全链路。本文解析其对云身份与权限安全的真实威胁及防守重点。