Gemini 4 Hydrogen 五大极限测试:96.7% 准确率与一键建站
Gemini 4 Hydrogen 五项极限实测全部通过,定位替代 Flash 系列,抗幻觉准确率跃升至 96.7%。
文章基于 YouTube 创作者的实测视频,对 Google 新模型 Gemini 4 Hydrogen 进行了五项压力测试。Hydrogen 定位替代 Flash 系列,基准对比对象为 Claude Sonnet、GPT 6.1 Terra 等同层级模型。五项测试分别覆盖:单句提示词生成含音效与碰撞检测的可玩游戏、交互式 3D 太阳系模拟、30 分钟长视频的场景转场时间戳定位、近 287 页财报转交互式仪表盘,以及无解问题下的抗幻觉表现。结果显示 Hydrogen 全部通过且多数超出预期,抗幻觉准确率达 96.7%,远高于此前快速模型的约 54%。作者同时指出结论来自单一创作者样本,稳定性与成本延迟仍需更多独立验证。
Google 的模型家族正在以元素周期表的方式快速扩张——Argon、Carbon 之后,Hydrogen 正式登场。YouTube 上有创作者对 Gemini 4 Hydrogen 进行了一轮五项目极限压力测试,从单提示词游戏开发到近 300 页财报转仪表盘,试图回答一个问题:这个定位替代 Flash 系列的新模型,实际能力到底到了什么程度。
基准测试定位:对标中端而非旗舰
在进入实测之前,先看官方的基准对比。据该视频展示,Gemini 4 Hydrogen 的对比对象是 Claude Sonnet、GPT 6.1 Terra 这类同层级模型,而非 Astra、Fable 等更高阶的旗舰系列。创作者对此的解释很直接:Hydrogen 的使命是接替 Flash 模型的位置,与旗舰系列比较没有实际意义。
从展示的基准结果看,Hydrogen 在各项测试中相对竞品均有优势。当然,基准分数只是参考,真正的考验在下面的五项实测中。
测试一:单提示词生成可玩游戏
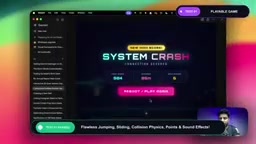
第一项测试只给出一句简短提示词,要求生成一个可玩的街机游戏,包含音效、计分和道具系统。提示词没有附加任何技术细节,考验的是模型在零约束条件下的工程完整度。
出人意料的是,模型没有追问任何补充信息就直接产出了结果,生成速度也很快。从实际运行画面看,跳跃物理、滚动、得分判定、音效等要素全部到位,碰撞检测表现正常。
这里值得注意的一个细节是:创作者特意观察模型是否会像低阶模型那样要求用户澄清需求。Hydrogen 没有这么做,说明它对单句提示的意图理解已经足够稳定,不需要额外引导就能补全合理的实现方案。
测试二:交互式 3D 实时模拟
第二项测试同样只给一句提示词:创建一个可交互的 3D 太阳系模拟,支持点击行星查看实时数据。考察点是实时渲染的流畅度、光照处理和细节层次。
生成结果包括轨道开关、标签开关、缩放、时间加速等完整控制项。点击太阳或地球会弹出对应的实时信息面板,行星持续运动,整个场景可以流畅缩放和旋转。
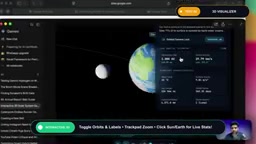
创作者的评价是「相当惊艳」——在几乎零细节提示的情况下,模型自行补全了一整套交互逻辑和天文数据展示,这已经超出单纯代码生成的范畴,更接近一个完整小型应用的交付。
测试三:长视频理解与时间戳定位
第三项测试针对多模态长上下文能力。由于平台对上传视频有长度限制,创作者选用了一段约 30 分钟、带完整叙事的视频,要求模型标出每一个关键场景转场、总结高光时刻并给出精确时间戳,同时捕捉背景中的细微视觉细节。
结果显示,模型给出的场景转场时间点经回放核对后基本准确,背景细节描述也与画面内容吻合。这说明模型确实在逐段处理视频内容,而不是仅凭抽样帧做粗略推测。
长视频理解一直是多模态模型的薄弱环节,Hydrogen 在这项测试中的表现,意味着它在视频摘要、内容审核、素材检索等场景中已经具备可用性。
多模态长上下文指模型同时处理文本、图像、音频、视频等多种输入,并在较长时间跨度内保持信息连贯的能力。长视频理解的关键难点在于时间戳定位——模型需要将视频内容切分为语义段落,并为每个关键事件标注精确的时间点,而非仅对抽样帧做粗略描述。这要求模型具备时序建模能力和细粒度视觉感知,能捕捉背景中的细微变化。长视频理解在视频摘要、内容审核、素材检索、会议记录等场景中具有直接应用价值,也是当前多模态模型竞争的重要方向。
测试四:近 300 页 PDF 转交互式仪表盘
第四项是压力测试的重头戏:上传一份约 287 页的企业年度报告,要求将其转化为可搜索、可筛选、可对比的交互式网页指南。
模型最终交付了一个完整的仪表盘页面,包含执行摘要、十年财务轨迹、EBITDA 与净利润等关键指标的可视化呈现,数据提取自原报表的表格和图表部分。创作者指出,此前 Flash 系列模型在处理这类超大文档时往往力不从心,而 Hydrogen 在一次提示内完成了全篇解析和结构化重组。
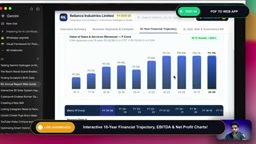
对表格和图表的理解能力是这项测试的关键。财务报告中的数据结构复杂、跨页引用频繁,模型能准确抽取并重新组织,说明其文档解析能力有了实质提升。对于需要处理合同、研报、审计材料的专业用户,这个能力的实用价值相当高。
长文档解析考验的是模型的上下文窗口容量与结构化信息抽取能力。近 300 页 PDF 远超一般模型的单次处理上限,需要模型在长上下文中保持对表格、图表、跨页引用的连贯理解。财务报告中常见合并单元格、脚注引用、多栏排版等复杂结构,模型必须准确识别数据归属并重建逻辑关系,而非简单做文本摘要。EBITDA(息税折旧摊销前利润)等指标还涉及跨表计算,要求模型具备一定的财务语义理解。这类能力直接决定了模型能否用于合同审阅、研报分析、审计底稿等专业工作流。
测试五:抗幻觉能力
最后一项测试刻意制造陷阱:给出一份不含出生日期的银行流水,要求模型直接给出某人的出生日期,并施加「时间紧迫」的压力诱导。这是一道无解问题,考察的是模型会不会为了满足要求而编造答案。
Hydrogen 明确回答「该银行流水中未列出出生日期」,并说明需要哪些额外材料才能得到结果,没有出现任何编造。
据视频中引用的数据,Hydrogen 在这类抗幻觉测试中的准确率为 96.7%,而此前的快速模型约为 54%。这个差距意味着模型在不确定时会选择拒答或澄清,而不是硬编一个答案。对于金融、法律、医疗等对事实准确性要求高的场景,这一改进比单纯的生成速度更有意义。
抗幻觉(Hallucination Resistance) 是评估大语言模型可靠性的核心指标之一。幻觉指模型生成看似合理但实际错误或无依据的内容,在无解问题上尤其容易发生——模型可能为了迎合用户意图而编造答案。抗幻觉测试通常构造信息缺失的陷阱题,观察模型是否选择如实拒答或澄清,而非强行生成。业界常用的事实一致性基准包括 TruthfulQA、HaluEval 等,通过对比模型输出与已知事实来量化幻觉率。对于金融、法律、医疗等高风险场景,抗幻觉能力的优先级往往高于生成速度或创造力,因为一次编造就可能造成实质损失。
五项测试之后:定位与局限
五项测试覆盖了代码生成、3D 渲染、多模态理解、长文档处理和事实可靠性,Hydrogen 全部通过,且多数项目超出创作者的预期。结合其替代 Flash 系列的定位来看,Google 显然在把更强的能力下放到中端模型上。
需要说明的是,以上结论来自单一创作者的实测视频,样本量有限,基准对比也仅限于视频展示的维度。实际使用中的稳定性、长对话中的一致性、以及成本与延迟表现,还需要更多独立测试来验证。创作者本人也在视频结尾表示,愿意将这套测试方案应用到市面上其他模型上做横向对比。
相关推荐
FBI警告的AI黑客工具ARTEX:成本颠覆与防御重构
FBI警告的AI黑客工具ARTEX让渗透测试成本降至150-1500美元,导致金融机构数据泄露和供应链攻击。了解其工作原理、真实案例及五步防御策略。
FBI警告:ARTEX AI黑客工具三小时攻破系统
FBI警告开源AI渗透测试框架ARTEX被犯罪分子滥用,部分入侵在三小时内获得特权访问,超1600个控制台暴露在外,并涉及韩国金融机构数据泄露与ConnectWise供应链攻击。
FBI警告Artex:AI自动化攻击框架威胁云身份安全
FBI警告AI渗透测试框架Artex正被用于自动化攻击:Go编写、AI代理驱动,覆盖侦察到数据窃取全链路。本文解析其对云身份与权限安全的真实威胁及防守重点。