Gemini 4 Hydrogen实测:基准亮眼但真实表现存疑
Gemini 4 Hydrogen 快速且有能力,但并非基准王者,思考等级是成败关键。
文章基于 SegFault 视频及多源信息,评估 Google 于 11 月 12 日发布的 Gemini 4 Hydrogen。它是 Gemini 4 家族中主打快速高效的成员,定价每百万输入/输出 token 1.50/7.50 美元,支持多模态与约百万 token 上下文,核心变量是低到超高的思考等级。Google 自报在 7/10 项基准胜过 Claude Sonnet 5.5,但测试条件有选择性;独立测试中 Artificial Analysis 排第 16/80,Arena 各榜居中上。思考等级从低到超高使分数由 27 升至 54,成本从 29 美分涨到 3.16 美元、时间从 1.4 分钟增至 14.5 分钟,高到超高成本增约 70% 仅换 3 分。Plotly 数据分析考试 43/43 通过且成本约为 Carbon 一半,但终端任务落后,GPT 6.1 Sol 以更低成本达到相近分数。结论是 Hydrogen 在数据分析、税务、金融智能体上可信,建议从高等级起步、简单任务降级并自行验证。
引言:又一个“基准王者”?
11月12日,Google发布了Gemini 4 Hydrogen。如果你用AI构建应用,一定听过这样的抱怨:Gemini在基准测试上光鲜亮丽,一到真实工作就掉链子。但也有开发者持完全相反的意见。那么,Hydrogen到底行不行?YouTube频道SegFault梳理了发布后两天内公开的信息——不是凭感觉,而是看证据。他们将信息分为四类:Google自己的声明、独立测试的测量结果、演示中展示的能力,以及他们自己的实测(这一项还是空的,因为他们还没跑过Hydrogen)。
本文基于该视频内容,结合多源信息,尝试回答一个核心问题:Hydrogen适合你吗?
Hydrogen是什么:快速高效的中间层
Hydrogen是Google Gemini 4家族中主打快速和高效的成员,改编自Carbon。Carbon和Argon仍然是Google的深度推理模型。在API定价上,Hydrogen每百万输入token收费1.50美元,每百万输出token收费7.50美元。它支持文本、图像、音频和视频输入,上下文窗口约100万token,由你发送的内容、模型思考的内容以及它写出的内容共享。
最关键的一个设置是“思考等级”(thinking level):低、中、高、超高。同一个模型,不同等级下结果差异巨大。而且思考过程按输出计费——这个旋钮你得时刻记着。
Google自己的数字:有选择性的对比
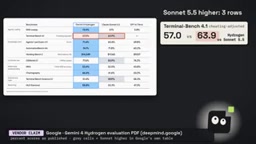
Google将Hydrogen与Claude Sonnet 5.5和GPT 6.1 Tera进行对比,这两个都是中端竞争对手,而非顶级模型。在10项测试中,Hydrogen有7项胜过Sonnet。在编码测试SWE Sweep上,Google报告自家测试框架下得分13.5,而Sonnet在公开排行榜上为3.1。但它也输掉了3项:Terminal Bench 4.1上57对63.9,OS World计算机使用测试上77.6对83.9,以及一项终端科学测试。
细节值得注意:Google主要在最高思考等级下运行Hydrogen,并使用自己选择的测试框架。竞争对手的数字来自公开排行榜、系统卡和Google自己的运行结果的混合。OS World分数是三次运行中的最佳成绩,且基于离线子集。这在发布时很常见,但这些是声明,不是干净的对比。
Google还表示,相比前代Gemini 3.8 Flash,Terminal Bench从18.2跃升至57%。如果属实,这对快速层来说是一个巨大进步。
独立测试:强劲但非顶尖
Artificial Analysis用同样的九项评估跑每个模型。在超高思考等级下,Hydrogen得分54,在80个条目中排第16(每个思考等级单独计数)。强劲,但不是顶级。Claude Fable 5.2在max等级下以65分领先。Google自家的Carbon在超高等级下得分60。
现在转动旋钮:低等级27分,中等级41分,高等级(默认)51分,超高等级54分。每个基准任务成本也随之攀升:29美分、80美分、1.87美元、3.16美元。每个任务时间从1.4分钟增加到14.5分钟。为什么?写作速度几乎不变,但在超高等级下,它写得更多——整个测试集约3亿输出token,大约是典型模型的四倍。
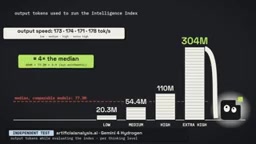
这些分钟数是长基准任务的时间,不是聊天回复。但方向是一致的:更多思考、更多token、更多时间和金钱。从高到超高,成本增加约70%,只换来3分提升。
另一个外部信号(仍标记为初步):在Arena投票榜上,Hydrogen文本排第15,Web开发排第10,智能体榜排第5。
Artificial Analysis 是一个独立的 AI 模型评测机构,其核心方法是对每个模型运行统一的标准化评估套件(通常涵盖推理、编码、数学等多项基准),并计算综合指数分数。与厂商自报数据不同,它固定测试框架和提示词,减少选择偏差,因此在社区中被视为相对中立的第三方信号。但需要注意其局限:评估任务偏学术和通用,与具体业务场景仍有距离;不同思考等级被单独计数,会稀释或放大排名差异;分数通常带有误差区间,相邻名次未必有统计显著性。阅读其排名时,应结合任务类型、成本与延迟一起判断,而非只看名次。
性价比:有竞争力,但非明确赢家
在模型页面小图表上,Hydrogen是绘制出的最快模型。但完整表格没那么好看。Claude Fable 5.2在低等级下也得分54,每个任务不到6分钟,花费差不多。GPT 6.1 Sol在超高等级下得分52,花费76美分。
一个明确优势:在这些索引任务上,Hydrogen在高等级下首个回答token约17秒到达,而Sol高等级下为43秒。所以它在速度或价格上都不是明确赢家,但有竞争力。
关于你自己的账单:按标价计算(非实测),一个智能体步骤发送20万token,返回2万token(含思考),输入30美分,输出15美分,共45美分。再次发送相同上下文时,Google的自动缓存对重复部分减免95%。缓存命中不保证。输出侧随思考增长,永远不会更便宜。
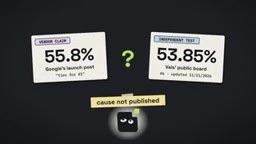
一个对不上的数字:Google发布帖称Hydrogen在Val's AI法律研究基准上以55.8%并列第一。但Val's公开榜(11月11日更新)显示Hydrogen为53.85,排第六。第一名是Gemini 4 Carp,55.77。我们不知道为何有差异,两个页面都没解释。所以不能称Hydrogen第一,但第六也不弱:每个分数误差约3.5分,前六名相差在2分以内。它接近领先者,没有明显高下。
另一个独立测试:图表公司Plotly的数据分析考试,43个任务,基于约2000万行的数据仓库,包含模糊问题和不可能请求等陷阱。Hydrogen通过了全部43个任务,Carbon 42个,Argon 41个——按Plotly自己的规则接近平手。但Hydrogen运行成本约一半,6.36美元。GPT 6.1 Sol也通过全部43个,花费2.69美元,每题中位时间18秒,而Hydrogen为32秒。另外两个模型也得了43分。Plotly明确表示:每个模型只跑一次,重复运行分数波动可达3分。他们的考试、他们的框架,未说明思考等级。有用,但只是一个数据点。
自动提示缓存(automatic prompt caching)是 API 提供商针对重复上下文的一种折扣机制:当多次请求共享相同的前缀内容(如系统提示、长文档、对话历史)时,服务端会缓存这部分计算结果,后续命中缓存的输入 token 按大幅折扣计费。文中提到的 95% 减免即属此类。它的关键限制在于“命中不保证”——缓存有存活时间、最小 token 门槛和路由一致性要求,请求间隔过久或负载变化都可能导致未命中。因此在做成本估算时,应把缓存视为潜在优化而非确定节省,对输出侧(尤其是思考 token)则不能指望任何折扣。
演示与早期评测:单次运行,参考有限
Google展示了Hydrogen一次生成带实时着色器的商店页面、将Google Sheets变成动画像素画布、制作幻灯片并修复自身文字重叠。演示展示可能性,但由销售模型的人挑选,不告诉你成功率。有些演示还有额外帮助:商店页面使用了Google的前端设计技能,而非裸模型。
Google之外,首批评测都是单次运行。Analytics Vidya在中等思考下,让它写了一个通过全部13个测试用例的SQL查询,但也把一个视频场景切点提前了一秒多。Active Pieces(用自动化研究系统写的文章)给了三个简单自动化任务,全部正确,和便宜得多的GPT-5.4 Mini一样。但在默认思考下,中位响应时间4.4秒,而后者0.9秒。
Gemini在真实工作中真的不行吗?
记录确实有问题。2024年,Google暂停了Gemini生成人物图像的功能。2025年,Ars Technica报道Gemini CLI清除用户文件。9月,AI Weekly援引Bloomberg报道,Google员工称未发布的Gemini 4模型在基准上比真实编码表现更好——那不是关于Hydrogen,Google称报道不准确。
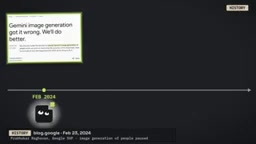
同一记录中也有亮点:2024年Gemini率先推出百万token上下文,2025年Gemini 2.5 Pro登顶LM Arena。公平的说法是“不稳定”,而非“差”。两天时间太短,不能说Hydrogen解决了问题。
Google自己的模型卡报告:在自动化安全测试中,无理由拒绝比3.8 Flash上升约5.5个百分点,尤其在多模态提示上。这是实验室测试,不是你被拒绝的频率,但Google选择报告它。
模型卡(model card)是模型发布时附带的标准化文档,用于说明模型的预期用途、训练与评估方法、安全测试结果及已知局限。它不同于营销材料,通常由负责模型开发的团队撰写,并包含拒绝率、有害内容测试、偏见评估等定量指标。文中引用的“无理由拒绝上升约 5.5 个百分点”即来自此类文档。阅读模型卡时应注意:这些是受控实验室环境下的测量,提示词分布与真实用户请求不同,因此数值更多用于横向比较和风险提示,而非预测你在生产环境中被拒绝的具体概率。
你应该用吗?
证据指向以下结论:
- 数据分析、税务、金融智能体:Hydrogen是可信选择。Val's(超高等级测试)和Plotly都将其置于或接近顶部。
- 终端密集型智能体:也看看其他选项。Google自己的表格显示它在Terminal Bench上落后于Sonnet,Val's在Terminal Bench 4.0上将其排在第11/64。
- 不要默认超高等级:Google自己警告它可能对简单提示过度思考。从高等级开始。对于路由或提取等简单步骤,试试中或低等级,并自行检查结果。
- 试试GPT 6.1 Sol:在Artificial Analysis和Plotly考试上,它以更低成本达到相近分数。
切换时注意两个警告:最小思考等级现在返回错误;Google Cloud上旧的思考预算同样报错;温度参数被忽略。
Hydrogen没有终结Gemini争论。它是一个快速、有能力的模型,带有一个你必须自己设置的旋钮。那个空抽屉?接下来,SegFault想填上它:同样的真实任务跨模型对比,成本和耗时都在屏幕上。
关键要点
- Hydrogen是Gemini 4家族的快速高效模型,定价$1.50/$7.50每百万输入/输出token,百万token上下文,思考等级是关键变量。
- Google自家基准显示其优于Claude Sonnet 5.5(7/10项),但测试条件有选择性;独立测试中Artificial Analysis排第16/80,非顶尖。
- 思考等级从低到超高,分数从27升至54,但成本和延迟大幅增加(29美分→3.16美元,1.4分钟→14.5分钟)。
- 在数据分析、税务、金融智能体任务上表现可信(Plotly 43/43),但终端任务落后,且与GPT 6.1 Sol相比性价比不突出。
- 建议从高等级开始,简单任务用中/低等级,并自行验证结果;切换时注意最小思考等级报错等限制。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。