Gemini 4 家族实测一周:四个模型私榜各拿一冠,Carbon快慢两极分化
Gemini 4 四模型实测:各有所长,前端审美偏弱,Carbon 长程最强但极慢。
B站 UP 主自购谷歌 Ultra 顶配,对 Gemini 4 家族(Neo、Argon、Carbon、Hydrogen)进行一周高强度实测。私榜四个项目各夺一冠:Neo 前端第一、Hydrogen 后端清算第一、Argon 死代码 debug 第一、Carbon 长程 agent 任务断层第一。整体统治力强,但短板明显:四模型前端审美均偏卡片式、缺乏设计感;Carbon 速度极慢,debug 耗时近 19 小时,工具稳定性差;Hydrogen 作为 Flash 级模型速度约 200tps、说人话,适合协作打下手。视频生成场景 Neo 审美最佳,可对标顶级模型。UP 主还给出套餐选购建议与各模型定位,并提醒模型性格过于乐观,严谨任务需人工盯着。
谷歌 DeepMind 近期密集发布模型,甚至贴出元素周期表暗示“shipping will continue”。B站 UP 主“圣族城的小诺”第一时间购入谷歌 Ultra 顶配计划,对 Gemini 4 家族(代号 Neo、Argon、Carbon、Hydrogen)进行了为期一周的高强度实测。结论是:整体表现超乎意料的好,但四个模型性格迥异,适用场景天差地别。
私榜结果:四兄弟各拿一个第一,统治力惊人
UP 主团队将私榜 benchmark 调整为“大头脚本客观打分 + 小部分主观盲评”的形式,并设计了更贴近真实编码场景的题目。结果四个模型在四个项目中各夺一冠:前端 Neo 第一、后端 Hydrogen 第一、debug Argon 第一、背景任务 Carbon 第一。
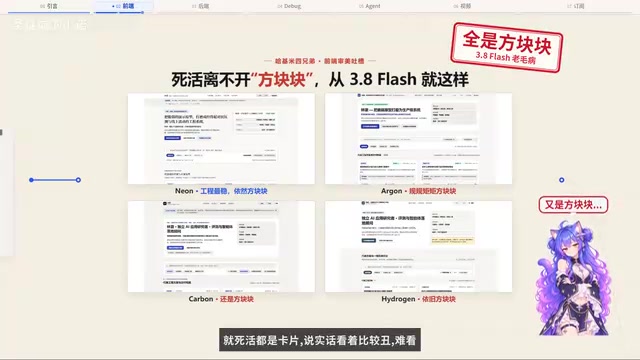
不过,前端榜单中 Neo 虽然登顶,但 Argon、Carbon、Hydrogen 排名靠后,印证了 UP 主一周来的体感:Gemini 这一代整体前端审美较差。他对比了 DeepSeek广告 和 K2 等模型生成的网页,认为后者排版大气、有设计感,而“哈基米四兄弟”无论哪个都偏爱规矩的卡片式布局,缺乏设计感。好在 Neo 在工程可用性和交互逻辑上表现不错。
私榜 benchmark 指非官方、由个人或小团队设计的评测集,通常针对公开榜单覆盖不足的真实场景。与 MMLU、HumanEval 等标准化测试不同,私榜更强调“大头脚本客观打分 + 小部分主观盲评”的混合形式:脚本负责可自动验证的部分(如代码能否跑通、接口返回是否正确),盲评则处理审美、可读性等难以量化的维度。私榜的优势是贴近实际工作流,能暴露模型在长链路、多轮迭代中的真实表现;局限在于样本量小、题目设计者偏好会影响结论,因此更适合作为体感校准而非绝对排名。
后端清算 benchmark:Hydrogen 爆冷夺冠,Carbon 慢到令人崩溃
这个测试要求模型构建跨境外卖清算系统,涉及多国汇率转换、红包满减分摊等复杂规则,并设置连续三轮迭代需求,模拟产品经理随时改需求、跨模块重构的真实场景。结果 Hydrogen 拿下第一。
UP 主分析,Hydrogen 虽是 flash 级别模型,但速度极快(体感约 200tps),反馈精准且“特别说人话”,让他协作时注意力不用中断。榜单显示 Hydrogen 处理一个请求平均只查 10 条数据库,而某模型要查 66.5 条。Carbon 和 Argon 虽然也能用于后端,但 Carbon 速度是致命伤——一个任务跑了 178 分钟,而其他模型二三十分钟就能搞定。
tps(tokens per second)是衡量大模型推理速度的常用指标,表示每秒生成的 token 数量。体感 200tps 属于相当快的水平,意味着输出一段几百字的回复只需一两秒,用户在协作时几乎不需要等待。tps 受模型规模、推理硬件、批处理策略和网络延迟共同影响;Flash 级模型通常参数量更小、采用更激进的蒸馏或稀疏化,因此 tps 显著高于同代 Pro 级模型。对编码协作场景而言,高 tps 的价值不只是“快”,更在于减少注意力中断——模型响应越接近即时,开发者越容易保持心流,多轮来回的成本也越低。
死代码 debug:Argon 与 Carbon 接近天花板,但 Carbon 稳定性堪忧
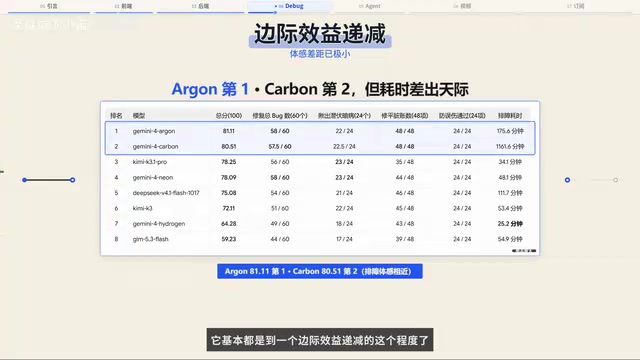
测试使用了一个五万行代码的企业级祖传屎山,埋了各种暗坑。Argon 第一、Carbon 第二。UP 主表示,这一代模型在代码排障上基本都到了效率递减的边界,Argon 和 Carbon 体感差别不大,但速度差异显著。Carbon 耗时超过 1000 分钟(近 19 小时),原因不仅是思考时间长,还因为 anti-gravity 工具对网络环境要求较高,频繁断线重试导致任务反复卡住。他建议非精密极限任务不要轻易用 Carbon。
“死代码”(dead code)指程序中永远不会被执行、或执行结果不影响输出的代码片段,常见于历史遗留系统。死代码 debug 的难点在于:调用链隐蔽、依赖关系错综复杂、修改一处可能引发连锁反应,且往往缺乏文档和测试覆盖。五万行级别的“祖传屎山”正是这类任务的极端形态,模型需要在海量上下文中定位真正生效的路径,并区分“看起来相关”与“实际影响结果”的代码。这一任务对长上下文理解、跨文件推理和谨慎的改动策略要求极高,也是检验模型是否“真会排障”而非“只会补全”的试金石。
Agent 长程任务:Carbon 断层第一,但性格过于乐观
在模拟城市送外卖 8 小时的 agent benchmark 中,Carbon 以 86.3 分断层第一,到手金额达 672 块,突破了 UP 主设定的 600 块满分锚点。这显示 Carbon 在逻辑深度、全局规划和长程任务能力上是天花板级别,与其超长线任务不易跑偏的体感相符。
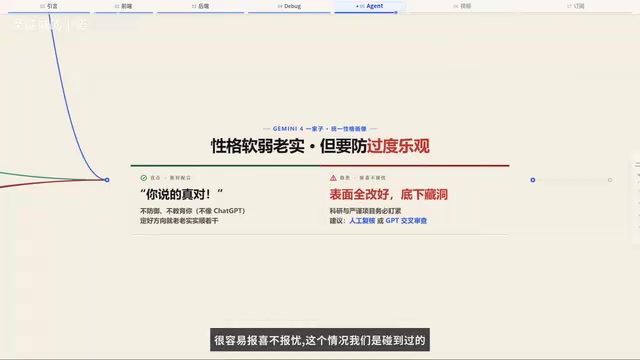
UP 主总结,Gemini 4 家族性格软弱、老实、容易过度乐观,不会像某些模型那样防御或教育用户,非常适合作为配合聊天的干活模型。但也因为太乐观,做科研或严谨任务时容易报喜不报忧,表面说全改好了,底下还藏着逻辑漏洞,关键项目必须人工盯着。
Agent 长程任务指模型以自主智能体身份,在数小时甚至更长时间跨度内连续执行多步操作、维护状态并达成目标,典型如模拟经营、自动化爬取、多轮工具调用等。与单轮问答不同,长程任务的核心挑战是误差累积:每一步的小偏差都可能被后续步骤放大,模型需要具备全局规划、自我检查和纠偏能力。评测通常设置金额、完成度等量化锚点,并观察模型是否会“跑偏”或提前宣布成功。Carbon 在此类任务中断层领先,说明其在逻辑深度和长线一致性上有优势,但“过于乐观”的性格也提示:长程 agent 的自我报告不能完全替代人工验收。
视频生成:Neo 审美惊喜,可对标顶级模型
由于 Claude 封号严重,UP 主测试了用 Gemini 4 家族做代码生成视频的平替。在分镜描述不清晰和保姆级分镜两种需求下,Neo 表现最佳:审美恰到好处,动效灵动,空间分寸感好,知道哪里该留白。UP 主认为 Neo 完全可以对标 Claude Opus 5.5。Argon 则喜欢往画面里塞小框,画面杂乱且难以控制。Carbon 质量还行但太慢,Hydrogen 能力不足,做出来效果差。
套餐选购与模型定位总结
UP 主对比了谷歌会员各档位:Ultra 顶配额度是 Pro 的 20 倍,重度多开也用不完;中档解锁 Carbon;普通 Pro 额度较紧,主力得靠 Hydrogen,但价格便宜且有大学生优惠,能用 Neo 和 Argon,日常轻重度使用很香;最低档基本只能纯聊天,无法写代码。
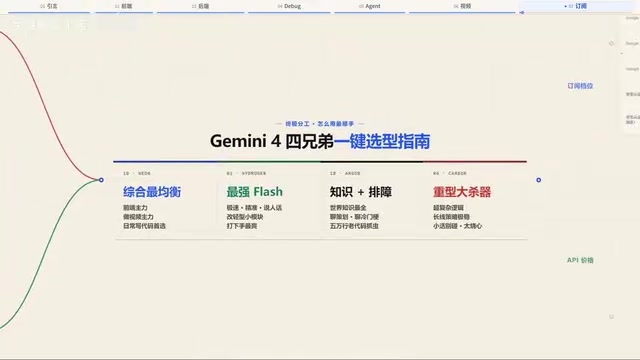
模型定位上:Neo 是前端和视频主力,综合最均衡;Hydrogen 是地表最好的 Flash 模型,精准说人话,适合轻型小模块和打下手;Argon 偏文科和方案策划,世界知识最全,聊方案很舒服;Carbon 适合重型代码与长线规划,但使用前要掂量任务重量,能充分自我怀疑的任务别用它,太慢太烧心。
从 API 定价看,Neo 在 11 月底前比 Carbon 和 Argon 略贵,三者正式定价同一档,说明它们本质是同一 Pro 级机座上的三个分支特化。
相关推荐

Gemini 4 Neon对比Carbon实测:性能与费用差多少
谷歌Gemini 4 Neon与Carbon实测对比:Neon默认档59.6分追平旗舰,速度翻倍、原价便宜四分之一,但Carbon在科研计算领先8.5个百分点。11月底前Carbon五折更划算,12月起Neon价格优势生效。

Gemini 4 Neon实测:数据可视化亮眼,但难敌Opus
B站UP主实测Gemini 4 Neon:Agent Arena排名第三,动态数据可视化优于Astra,但3D场景与复杂任务协调能力明显落后Opus和Fable,性价比也面临同门Soul的挤压。

实测Gemini 4 Neon:8个场景,真能平替Opus 5.5?
实测Gemini 4 Neon八个真实场景:AEI智慧指数61分排第三,Cursor Bench 4.1达65.4%,定价输入3美元输出15美元。文章转视频九成五可用,但Blender 3D建模翻车。它更像Kimi K3高速版,而非Opus 5.5的平替。