Gemini 4 教会人形机器人玩玉米洞:视频学习与自我迭代的突破

Gemini 4 仅凭一段人类示范视频和模拟器试错,就让人形机器人学会玩玉米洞并连续七次命中。
本文介绍了 Google Gemini 4 Argon 团队的一项机器人学习实验:团队只向 Gemini 4 展示了一段人类投掷玉米洞的视频,随后让它在 Mojoku 模拟器中反复练习。机器人并非执行预设程序,而是通过观察每次失败回放的视频,自主诊断动作偏差并调整站姿、挥臂轨迹与释放时机。在真实人形机器人上,它进一步根据沙包落点做厘米级微调,最终连续七次投入洞中。文章指出,这项实验的价值不在投掷本身,而在于验证了一种新范式:视频理解驱动的错误诊断、跨模态推理与 Sim-to-Real 在线校准三者结合,形成了无需人工设计奖励函数的自我改进循环,为通用机器人学习指出了一条潜在路径。
从视频到动作:Gemini 4 的机器人学习实验
如果让一个从未摸过沙包的人形机器人学会投掷玉米洞(Cornhole),需要多少行代码?Google 的 Gemini 4 Argon 团队给出了一个令人意外的答案:只需要一段人类示范视频,加上一个模拟器。
在这项实验中,研究团队向 Gemini 4 展示了一段人类完成投掷任务的视频,随后提示它运行 Mojoku 模拟器进行练习。机器人并非按照预设程序执行固定动作,而是通过反复试错、观察每次失败的视频回放,逐步修正自己的行为。
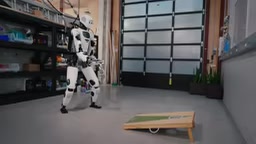
这一过程的核心在于「经验学习」——机器人从每一次投掷的结果中提取信息,分析偏差来源,并在下一轮尝试中调整策略。这种闭环学习机制,让 Gemini 4 展现出了超越传统机器人编程范式的适应能力。
玉米洞(Cornhole) 是一种在北美非常流行的户外投掷游戏:玩家站在一定距离外,把装有玉米粒的小沙包投进一块倾斜木板上的圆洞中,投中即可得分。看似简单的动作,实际上对投掷者的站姿、挥臂轨迹、释放时机和力度控制都有综合要求,因此常被用作检验机器人感知—决策—控制一体化能力的任务载体。它的挑战性在于:目标小、距离远、对释放点误差极为敏感,几厘米的偏差就可能导致命中或完全脱靶,这恰好能暴露机器人在视觉估计和精细运动控制上的不足,也让「从失败中迭代调整」这一能力变得可量化、可观察。
人形机器人(Humanoid Robot) 指外形和运动结构模仿人类身体的双足机器人,通常具有头部、双臂、双腿和多自由度关节。与轮式或机械臂式机器人相比,人形机器人在投掷类任务中具备明显优势:可以直接借鉴人类的示范动作,站姿、挥臂、转体等行为模式能够自然地映射到自身关节坐标上。但它的难点同样突出——双足平衡、关节串联误差、电机响应延迟都会叠加放大动作偏差,因此对人形机器人而言,Sim-to-Real 迁移的难度通常高于固定底座的机械臂。
模拟器中的自我优化:从失败视频中找答案
Mojoku 模拟器在这个实验中扮演了关键角色。它不仅是练习场,更是数据生成器——每一次投掷都会生成一段视频记录,而 Gemini 4 需要从这些视频中「看懂」问题所在。
根据实验描述,Gemini 4 能够通过视频理解能力进行推理,精准定位失败原因。例如,在某次模拟练习后,它总结道:「第三,我练习了投掷模拟,加宽了站姿并调整了挥臂动作,使我的手能够干净地越过髋部,并抛出平滑的弧线。」
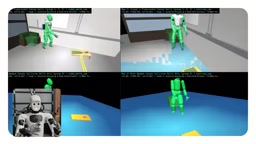
这段自我描述揭示了 Gemini 4 的推理链条:它不仅能识别动作偏差,还能将修正方案转化为具体的身体指令——站姿宽度、挥臂轨迹、释放时机。这种从视觉理解到运动控制的跨模态映射,正是当前机器人学习领域的前沿挑战。
跨模态映射(Cross-modal Mapping) 指的是模型在不同信息模态之间建立语义对应关系的能力。在本实验中,它具体表现为:Gemini 4 从「视觉模态」的视频画面中识别出站姿过窄、挥臂轨迹不流畅等问题,再把这种视觉诊断转译为「运动模态」的可执行参数,例如髋部宽度、手臂摆动弧度、释放时间点。这一过程之所以困难,是因为视觉语言描述(「干净的越过髋部」)与机器人关节控制指令(角度、角速度、力矩曲线)之间并不存在天然的对应关系,需要模型在训练中建立起二者共享的抽象表示。具备这种能力的模型,才有可能把「看懂问题」直接转化为「改对动作」。
Mojoku 模拟器 在文中扮演的是「练习场 + 数据生成器」的双重角色。与传统的刚体物理仿真器相比,它额外提供了视频回放输出,使得每一次尝试都留下一段可视化的失败记录。这样一来,Gemini 4 不需要依赖工程师手工设计的数值奖励信号,就可以直接从视频中提取「哪里做错了」的信息。这种用视频替代标量奖励的做法,正是实验宣称「减少对人工奖励函数设计依赖」的技术基础:学习信号由模型自身的视频理解能力生成,而不是由外部规则规定。
真实机器人上的厘米级调整
模拟器中的成功并不自动等于现实世界的胜利。当 Gemini 4 控制真实人形机器人时,它面临的是物理世界的不确定性:摩擦力的细微变化、关节电机的响应延迟、沙包重量的微小差异。
实验记录显示,Gemini 4 在真实机器人上采取了渐进式调整策略:「我观察每个沙包的落点,将释放点调整几厘米,直到我们连续七次投入洞中。」
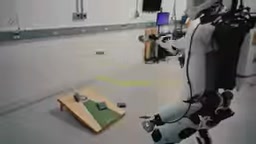
从模拟到现实的迁移(Sim-to-Real)一直是机器人学的难点。Gemini 4 的做法是通过实时视觉反馈进行在线校准,而非依赖精确的物理建模。这种方法更接近人类的学习方式——先建立粗略的动作框架,再通过实际结果微调参数。
连续七次命中对于一个没有预先编程投掷轨迹的机器人来说,是一个值得关注的成绩。它意味着 Gemini 4 不仅学会了「如何投」,还学会了「如何根据环境调整投掷」。
Sim-to-Real(模拟到现实)迁移 是指把在仿真环境中训练或优化得到的策略,部署到真实物理系统上的过程。它之所以困难,根本原因是仿真无法完美复现现实中的物理细节:摩擦系数、空气阻力、物体质量分布、电机死区与响应延迟、传感器噪声等,都会导致仿真中「完美」的动作在现实中偏离预期。传统解法通常有两种:一是进行「域随机化」,在仿真中故意加入大量物理参数扰动,让策略对不确定性更鲁棒;二是建立精确的物理模型进行标定。Gemini 4 采用的是第三条路径——放弃精确建模,转而依靠部署后的实时视觉反馈进行在线校准,把现实世界当作又一轮「练习」,用观察到的落点偏差持续修正释放参数。这种做法对模型的在线推理速度和视觉反馈闭环提出了更高要求,但省去了繁琐的物理参数标定流程。
自我迭代能力为何令人兴奋
实验中最引人注目的部分,或许不是机器人最终投中了多少球,而是它展现出的自我迭代能力。
「Gemini 4 能够通过视频理解进行推理,缩小问题范围,找出哪里出了错。它从自己的经验中学习,这非常令人激动。」
这种能力的意义在于:它减少了对人工奖励函数设计的依赖。传统强化学习需要工程师精心设计奖励信号,而 Gemini 4 直接从视频中理解「成功」与「失败」的视觉差异,将视频理解能力转化为了学习信号。
当然,这项实验仍属于早期探索。一次成功的投掷任务与通用机器人技能之间还有巨大距离。但它指出了一个方向:当大模型具备了足够的视频理解与推理能力时,机器人学习可能不再需要海量的标注数据或复杂的奖励工程,一段人类示范视频加上试错循环,就能启动学习过程。
奖励函数设计(Reward Function Design) 是传统强化学习中最关键也最耗人力的环节之一。要让智能体学会一项任务,工程师必须把「什么是好、什么是坏」写成可计算的数值信号,例如「沙包离洞越近得分越高」。奖励设计得不好,模型可能学会钻空子(如原地抖动骗分),或者因信号过于稀疏而学不动。本实验中 Gemini 4 的做法绕开了这一环节:它不需要人为定义的分数,而是直接从每次投掷的视频回放中判断成败、定位错误,把视频理解结果当作学习信号。这意味着「什么是成功」由模型的视觉常识来判断,而不是由工程师逐条编写。对于任务种类繁多、成败标准难以量化成公式的通用机器人场景,这种省去奖励工程的路径具有明显的可扩展性优势。
对机器人学习范式的启示
Gemini 4 玩玉米洞的实验,本质上是在验证一个假设:多模态大模型能否成为机器人学习的通用引擎。
从实验结果看,答案是初步肯定的。Gemini 4 展示了三项关键能力:
- 视频理解驱动的错误诊断——从回放中识别动作偏差
- 跨模态推理——将视觉分析转化为具体的运动参数调整
- Sim-to-Real 适应——在物理世界中通过实时反馈微调动作
这些能力组合在一起,形成了一个无需人工干预的自我改进循环。对于机器人研究社区而言,这或许比机器人投中玉米洞本身更有价值——它展示了一条通向通用机器人技能的潜在路径。
随着视频理解模型的持续进步,未来我们可能会看到更多类似实验:不是教机器人完成特定任务,而是教它们如何自己学习任务。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。