Gemini 4 Neon实测:编码第一但慢近一倍,这账怎么算
Neon编码Agent第一、单任务成本仅克劳德一半,但耗时比中位慢近一倍。
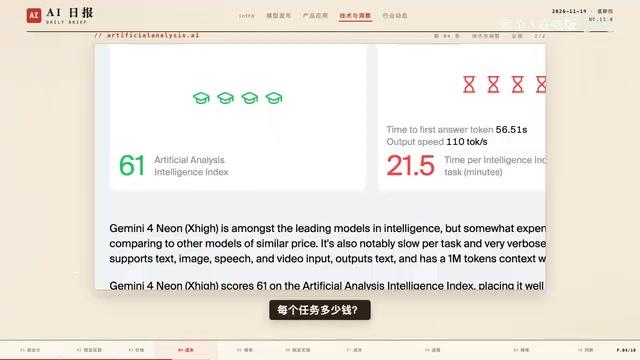
海外评测圈对 Gemini 4 Neon 的评测结论是:编码 Agent Index 以 59 分排第一,但综合智能指数 61 分仅列第三。成本上单任务平均 6.86 美元,约为克劳德一半,但便宜源于单价低而非用量省——每任务输出 Token 比上一代多 15%,总量达 2.83 亿。速度上每秒 110 Token 看似很快,端到端却需 21.5 分钟,比所有模型中位 12.1 分钟慢近一倍,仅比上一代 36 分钟快四成。能力展示以纯代码生成的像素世界、四足机器狗等原片佐证。文章结论是:Neon 定位够用又便宜,省的是账单、赔的是等待,是否值得取决于任务是批量跑还是赶时间。
海外评测圈对新模型「Neon」(Gemini 4 Neon)的账已经算完,结论出乎不少人意料:它在编码 Agent 这一项上拿了第一,却比同类中位慢将近一倍。今晚不聊发布会的热闹,只算这笔账——便宜和快,到底选哪个。
评测圈口径一致:编码第一,全能中上
据第三方机构 AA 的智能指数,Neon 最高档得分 61 分,排在第三位,前面是 Fable 5.2 的 65 和 Astrid 的 62。按编体(编码体)排名,它在 96 个模型里排第六。这个成绩在旗舰模型里算中上,不弱,但也不是最强,而且排名靠前的两个都更贵。
更能说明问题的是编码 Agent Index:Neon 以 59 分排第一,Fable 5.2 和 Opus 5.5 都是 58 分,Carbon 55 分。据 Google 官方博客引用,Neon 在该榜为 58.6 分,同样是第一。需要说明的是,这是编码这一项的第一,不是全能第一。
编码 Agent Index(编码智能体指数) 是一类专门衡量模型在"自主编码任务"中表现的评测集,与普通代码补全或单轮生成不同:它要求模型在多步工具调用、文件读写、测试运行、错误修复的循环中独立完成任务,最终以任务通过率或质量标准打分。这类榜单更贴近真实工程场景,因此被开发者视为比传统 HumanEval、SWE-bench 更贴近落地的指标。文中 AA 的编码 Agent Index 正是此类评测,Neon 在此项以 59 分居首,说明其在"端到端把活干完"的能力上有优势,但这与通用推理、数学、多语言等全能榜单的排名并不等价,读者需区分"单项冠军"与"综合第一"。
成本账:单任务约为克劳德一半
真正让评测圈兴奋的是价格。官方定价输入 3 美元、输出 15 美元,第三方 AA 用编码工具实测每个任务的平均成本,Neon 为 6.86 美元,Opus 5.5 和 Fable 5.2 则高出一截,差不多是克劳德的一半——同样的活,对面要花两倍钱。
不过,便宜背后有个反常识的原因:AA 指出 Neon 每个任务比上一代多用 15% 输出 Token,整轮输出达 2 亿 8300 万个,中位只有 6500 万。它不是更省,而是单价低,用量还更大。所以别以为它用得省,省的是账单。
输出 Token 与输入 Token 的计价差异 是理解成本账的关键。主流 API 定价中,输出 Token 单价通常是输入的数倍(Neon 为 3 美元输入 / 15 美元输出,比例 1:5),因为生成过程计算量更大。因此一个模型"每任务输出 Token 更多"会显著抬高账单,即便单价便宜。文中 Neon 每任务输出 2.83 亿 Token、约为中位 6500 万的 4 倍多,却仍把单任务成本压到 6.86 美元,说明其单价优势足以抵消用量劣势。反过来说,若某个任务对输出量敏感(如长文生成、大规模代码重构),Neon 的成本优势会被稀释,读者在估算自身账单时应把"单价×用量"一起算,而非只看单价。
速度账:打字快,干完活慢
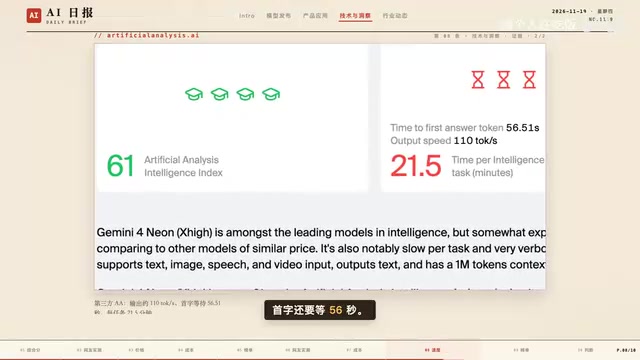
速度数据最值得细看。AA 测得 Neon 每秒输出 110 个 Token,看起来很快,上一代是 57,快了将近一倍。但每个任务耗时 21.5 分钟,所有模型中位是 12.1 分钟,比中位慢将近一倍。原文还有一句:比上一代的 36 分钟反而快四成。首字还要等 56 秒。
一句话:比同类中位慢,比上一代快。打字快和把活干完快是两码事,等的时间是实打实的。想快,就得多花钱。
每秒输出 Token 数(TPS)与端到端任务耗时 是两个不同层级的指标。TPS 衡量的是模型"吐字"的瞬时速度,影响的是用户感知的流畅度;而端到端耗时还包含首字延迟(TTFT)、工具调用往返、多轮思考与重试等开销。编码 Agent 场景中,模型往往需要数十次工具调用与自我修正,这些串行步骤的累积会主导总时长,TPS 再高也难以弥补。这解释了 Neon 的"矛盾":110 TPS 约为上一代两倍,但每任务 21.5 分钟仍慢于中位 12.1 分钟。评估模型速度时,应以任务级耗时为决策依据,TPS 仅作参考。
能力面:纯代码生成的原片
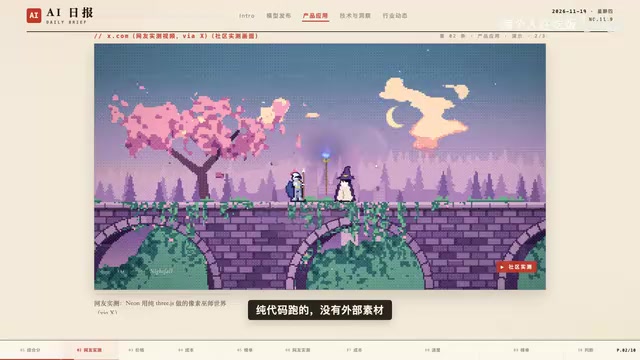
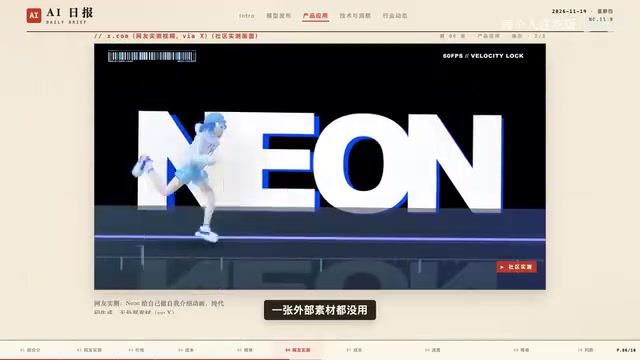
能力展示上,有网友拿 Neon 做了个像素巫师世界,纯代码跑,没有外部素材,画面全是它自己写的;还有人只给一张图,就搭出四足机器狗,步态全在算。官方博客也提到它给自己做了一支介绍动画,纯代码生成、一张外部素材都没用,还能凭一张图搭出整套可开的三维历史翻传风向能条。两段原片都不长,但能看出它能干什么。
据 Google 官方博客引用第三方榜单,Neon 拿了自动化测试 56.3%、经营模拟 16843 美元两项第一;编码测试从 12.8% 提升到用上工具后的 39%,工具比模型还重要。另一个第三方榜为 70.9%,排第二。这些是第三方机构自己设的榜,和官方自己跑的不是一回事。
工具调用对编码测试成绩的提升 值得单独说明。文中提到编码测试从 12.8% 提升到用上工具后的 39%,这揭示了一个常被忽视的事实:现代编码 Agent 的成绩很大程度取决于"能否正确使用工具"(运行测试、读文件、查文档),而非模型裸能力。同一模型在纯生成模式下表现平平,接入工具后可能翻数倍。这也意味着榜单间可比性有限——各机构给模型配置的工具集、重试次数、超时策略不同,分数不能直接横向比较。读者看到"某榜第一"时,应先确认其评测协议是否与自己的使用方式一致。
该不该用:看你的活是什么类型
批量跑、不敢交付?它划算。赶时间、要快?别省这点钱。Neon 抢的不是最强,是够用又便宜——省的是账单,赔的是等待。你手上的活是什么类型,决定它值不值。便宜和快,你选哪个?证据都在画面里。
相关推荐
把科学单位做成首饰:这波「理科浪漫」能打动谁?
从10克参考质量到半秒摆挂饰,一组把科学计量单位做成首饰的创意产品走红。本文解析其产品设计、科普传播价值与知识型周边的商业逻辑。
陶哲轩:无外力纳维-斯托克斯奇点与广义黎曼猜想的深层联系
陶哲轩:无外力纳维-斯托克斯奇点与广义黎曼猜想的深层联系
陶哲轩探讨无外力欧拉奇点、纳维-斯托克斯奇点与广义黎曼猜想之间的深层联系,分析流体方程与数论跨域类比的启发式价值及其对AI辅助数学研究的启示。
语言模型能改写自身权重:自编辑AI新范式
一篇新论文提出语言模型可直接重写自身权重,实现持久化知识更新与行为纠正,区别于上下文学习和外部微调。Hacker News热议其可逆性、验证与安全边界,指向持续学习系统的新可能。