Gemini 4与DeepSeek写特斯拉飞车游戏,谁更强?实测结果出人意料
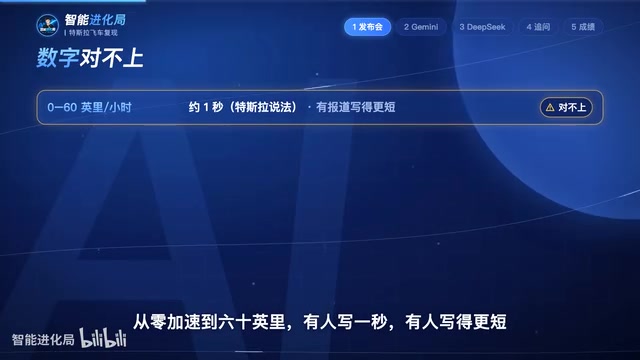
UP主让Gemini 4与DeepSeek V4 Pro用原生JS复现特斯拉飞车物理场景,Gemini胜出。
B站UP主用特斯拉发布会上会飞的车的场景做测试,要求Gemini 4和DeepSeek V4 Pro各用原生JS写一个真实物理计算的网页,包含坡道翻转和飞跃五辆车两个玩法。Gemini 4三分钟出稿,坡道翻转首次即可运行,仅需调参稳定落地;飞跃五辆车首次撞车,但在模糊反馈下自行修复成功。DeepSeek V4 Pro代码更长、界面完整,却因初始位置与地面重合导致第一帧误判落地,重写后仍未解决,小模型B4.1 Flash表现也不佳。UP主强调这只是单题对比,不能代表模型整体能力。
当AI遇到特斯拉飞车:一场物理模拟的较量
最近特斯拉发布会上那辆会飞的车引发了不少讨论——底盘风扇吸在坡道上倒挂爬坡,冲出坡道后空中翻身,再用冷气推进器喷气减速落地。有B站UP主突发奇想:让AI来复现这个场景,能行吗?
他选了两位选手:谷歌的Gemini 4和DeepSeek广告 V4 Pro,要求用原生JS写一个网页,物理必须真算不能拿动画糊弄,并设置两个玩法:坡道翻转和飞跃五辆停着的车。每人只有一次初始机会,结果差异巨大。
第一回合:坡道翻转,Gemini一次跑通
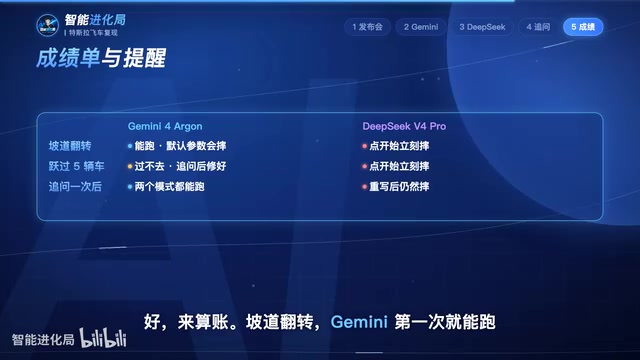
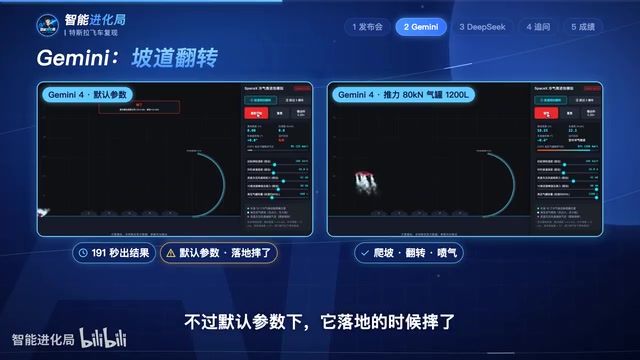
Gemini 4只用了三分多钟就交卷。UP主点击开始,车真的开上坡道、倒挂爬坡、空中翻转、喷气减速,一气呵成。不过默认参数下落地时摔了——把推力和喷气参数调大一点就能稳稳落地。
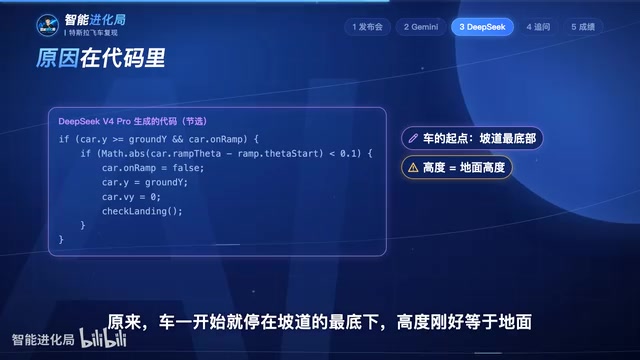
DeepSeek V4 Pro花了六分半,代码更长,界面也完整。但一点开始立刻显示“摔了”,车一动没动。UP主翻代码发现,车初始位置高度刚好等于地面,而代码里有一句“碰到地面就算落地”,结果第一帧就把自己判成落地了。换了九种窗口大小、多种初始说法,结果都一样。
文中提到的“倒挂爬坡”依赖的是吸附力而非普通轮胎摩擦力:当车辆倒挂在坡道下方时,重力方向与坡面法线相反,必须由底盘风扇持续提供指向坡面的负压(吸力),才能让轮胎获得足够的正压力来产生摩擦力。在物理模拟中,这通常需要单独施加一个沿坡面法线向内的力,并与法向支持力、摩擦力联合求解,否则车辆会直接脱离坡面坠落。这也是该场景比普通爬坡更难正确建模的原因。
第二回合:飞跃五辆车,Gemini改一次就过
Gemini 4在飞跃五辆车玩法中首次尝试无论怎么调参数都撞上第一辆——起跳位置离第一辆车只有一米左右,车还没飞起来就撞了。UP主只告诉它“哪里不对”,Gemini自己改好了,第二次稳稳落地。
DeepSeek V4 Pro被指出问题后把代码整个重写了一遍,但点击开始还是立刻摔。UP主还试了DeepSeek的小模型B4.1 Flash:坡道翻转能爬能翻但最后翻车,飞跃五辆车会慢慢爬。
“飞跃五辆车”属于典型的抛体运动 + 碰撞检测场景:车辆冲出坡道后只受重力(以及喷气推力)作用,水平速度决定能飞多远,起跳点的位置和角度共同决定弹道。文中Gemini首次失败是因为起跳点离第一辆车仅约一米,车辆尚未获得足够的垂直位移就进入了碰撞体范围。正确做法通常是将起跳点后移、增大起跳仰角或提高初速度,使弹道在到达第一辆车之前已经上升到车顶高度以上,并让落地判定区分“撞击障碍物”与“接触地面”。
结果与反思:单题测试不能定胜负
UP主的结论很明确:这道题Gemini赢了。但他也强调只测了这一道题,换一道结果可能完全不同。DeepSeek是直接调官方接口,没特别设置环境,和Gemini环境不同,所以不比速度。
这场测试揭示了几个关键点:AI对物理模拟的理解深度、代码初始状态的严谨性、以及根据反馈迭代修复的能力。Gemini在首次生成时更接近可运行状态,而DeepSeek的代码虽然更长,却在基础逻辑上犯了低级错误。
背后的技术差异:物理引擎与状态管理
从代码层面看,Gemini似乎更擅长处理物理模拟中的状态转换——比如“落地”判定需要结合速度、位置和接触状态,而不是简单的地面碰撞。DeepSeek的代码可能过度依赖简单条件判断,导致第一帧误判。
另外,Gemini在收到“哪里不对”的模糊反馈后能精准修复起跳位置,说明它对空间关系的理解更到位。DeepSeek的重写虽然工程量大,但没抓住核心问题。
当然,这只是一次非严格对照实验。不同模型在不同任务上各有优劣,提示词、环境、接口调用方式都会影响结果。UP主把提示词放在评论区,鼓励大家自己尝试。
“落地判定”是这类模拟中最容易出错的状态机逻辑。合理的实现通常需要同时满足多个条件:车辆最低点与地面距离小于阈值、垂直速度方向朝下(或已接近零)、且前一帧处于“空中”状态,才触发落地事件并切换到“着地”状态,同时还要有短暂的容差帧避免抖动。如果只用“位置与地面相交即算落地”这一条判断,那么初始摆放位置恰好贴地时,第一帧就会被误判为落地,导致车辆尚未运动就被锁定。这也是文中DeepSeek代码“一动没动就摔了”的直接原因。
结论:AI写游戏物理,还有多远?
特斯拉飞车这种复杂物理场景,对AI的代码生成能力是很好的压力测试。Gemini 4在这次测试中表现更稳,但DeepSeek V4 Pro的长代码和完整界面也展示了潜力。未来随着模型迭代,这类任务可能会变得更容易。
如果你也想试试,不妨用同样的提示词跑一跑,看看你那边谁能跑起来。
相关推荐
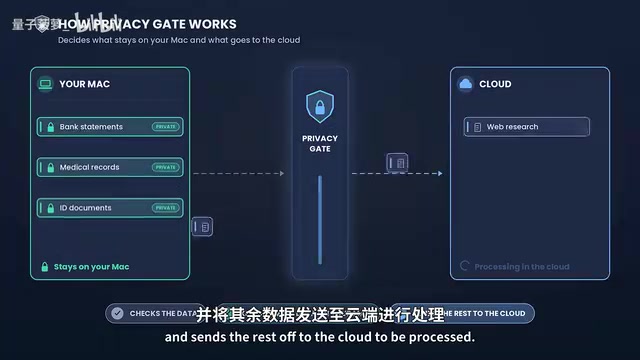
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。