GitHub 10月可用性报告:八起事故波及服务

GitHub 月度报告显示过去一月发生八起性能降级事故,平台可靠性再受关注。
GitHub 最新一期月度可用性报告披露,过去一个月共发生八起导致服务性能降级的事故,平均每周约两起。报告未说明单次事故的持续时长、受影响用户规模及根因归属,事故类型被界定为「性能降级」而非「全站中断」,影响多表现为响应变慢、API 超时率上升和 Webhook 延迟等。对将代码托管、CI/CD 与包管理集中依赖 GitHub 的团队而言,这一频率足以对自动化流水线造成压力。文章指出,月度报告的核心价值在于长期趋势观察,开发者可据此判断是否需在关键发布窗口准备镜像、备用 CI 或重试机制等降级方案;而官方能否持续透明披露并补充根因分析,才是更值得关注的信号。
GitHub 每月发布的可用性报告是观察其基础设施稳定性的一个窗口。最新一期报告显示,过去一个月共发生八起导致服务性能降级的事故,平台可靠性再次成为开发者社区讨论的焦点。
事故数量与影响范围
根据 GitHub 官方博客发布的报告,本月共有八起事故造成 GitHub 各项服务的性能降级。报告并未披露单次事故的具体持续时长或受影响用户规模,但从「degraded performance」这一表述来看,事故影响集中在响应变慢、部分功能间歇性不可用等层面,而非全站宕机。
对于把代码托管、CI/CD、包管理都压在 GitHub 上的团队来说,任何一次性能降级都可能传导到开发流程中。八起事故意味着平均每周约两起,这个频率足以让依赖平台 API 的自动化流水线感受到压力。
性能降级与彻底中断的区别
值得区分的是,报告定义的事故类型是「性能降级」而非「服务中断」。这两者对开发者的实际体验差异很大:前者更多表现为页面加载迟缓、API 超时率上升、Webhook 延迟投递,后者则是完全无法访问。GitHub 选择将性能降级也纳入统计口径,说明其对可用性的定义相对严格。
不过,报告本身并未逐一说明八起事故的根因归属——是基础设施故障、数据库瓶颈,还是部署变更引入的问题。缺少这部分细节,外界难以判断事故是否集中在某一类组件上。
可用性(Availability)与 SLA/SLO 的行业口径
在云服务领域,可用性通常以「正常运行时间 / 总时间」的百分比衡量,而 SLO(服务等级目标)会进一步细化为延迟、错误率、吞吐等多维指标。GitHub 将「性能降级」纳入事故统计,实质上采用了比「仅统计宕机」更细的 SLO 口径——只要关键指标偏离目标阈值即计为事故。这与 AWS、Google Cloud 等厂商在状态页上区分「service disruption」与「service degradation」的做法一致。理解这一点有助于开发者把月度报告中的数字与自身团队的监控告警阈值对应起来,而不是简单将其等同于「宕机次数」。
对开发者的实际参考价值
月度可用性报告的价值不在于单月数字本身,而在于长期趋势。开发者可以借此判断在关键开发周期(例如版本发布窗口)是否需要为外部依赖准备降级方案,比如本地镜像、备用 CI 执行环境或重试机制。
对于平台方而言,持续公开事故数量也是一种责任承诺。八起事故的数字本身不构成警报,但透明披露的节奏能否长期维持、后续报告是否补充根因分析,才是更值得关注的信号。
外部依赖的降级设计常见模式
当代码托管与 CI/CD 强依赖单一平台时,常见的工程实践包括:为 Git 仓库配置镜像远程(如本地 GitLab 镜像或定期 bare clone),CI 流水线设置多执行器与失败重试/排队策略,Webhook 消费端做幂等与延迟补偿,包管理使用私有 registry 或代理缓存以规避上游不可用。这些模式并不能消除外部依赖风险,但能把「性能降级」从阻塞性问题降为可容忍的延迟。月度报告的意义之一,就是为是否需要投入这些冗余设计提供数据依据。
相关推荐

Dify 工作流实战:本地部署与私有知识库智能体落地指南
基于 B 站 Dify 实战课程整理:Windows Docker 本地部署、MySQL 连接配置、五类应用与工作流节点案例、外部大模型接入选择,以及应用发布为站点或 API 的完整落地路径。
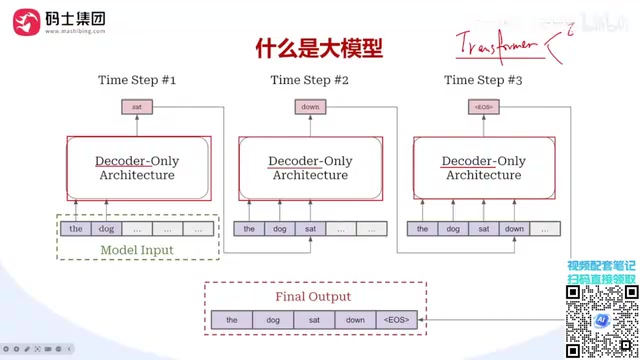
大模型分布式训练全解析:DP/TP/PP/SP一次讲透
从单卡显存瓶颈出发,系统讲解大模型分布式训练中的DP数据并行、TP张量并行、PP流水线并行与SP序列并行,剖析各自切分维度、通信代价与混合并行实战选型逻辑。
DeepSeek Harness保姆级教程:安装配置到插件实战
DeepSeek Harness保姆级教程:详解Node.js环境配置、客户端安装步骤,以及对话式、插件市场、命令行三种插件安装方式,助你快速上手这款开源AI Agent框架。