GLM 5.3 上线 Serverless Training API:免销售对接直接微调
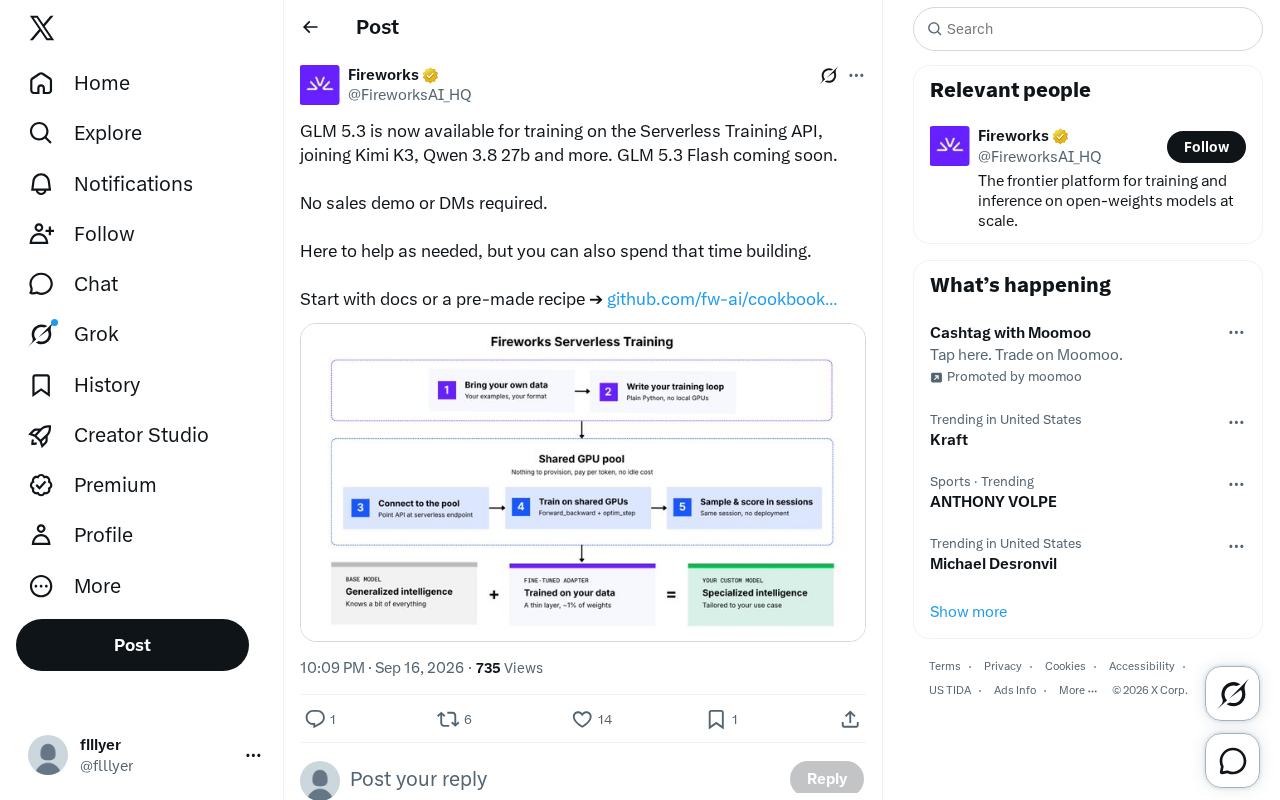
GLM 5.3 上线 Serverless Training API,与 Kimi、Qwen 等模型同台,降低开发者微调门槛。
GLM 5.3 正式加入某 Serverless Training API 平台,与 Kimi K3、Qwen 3.8 27b 等主流开源模型并列可用,GLM 5.3 Flash 版本亦在预告中。Serverless 训练模式的核心价值在于将 GPU 集群管理、资源调度等运维复杂度收敛至 API 背后,开发者按需触发、按量计费,无需经过商务对接流程,可直接通过文档或预制训练配方上手。平台同时托管多个来源的模型,使横向评测、低成本迁移和规避供应商锁定成为可能。这一动态折射出开源模型工具链的两个趋势:训练基础设施的 Serverless 化,以及多模型统一托管的平台化竞争。
GLM 5.3 加入 Serverless 训练阵营
一条来自 Twitter 的产品更新透露,GLM 5.3 现已可在 Serverless Training API 上进行训练,加入了 Kimi K3、Qwen 3.8 27b 等一批已支持的开源模型行列。同时,官方预告 GLM 5.3 Flash 版本即将上线。
对于关注开源大模型微调的开发者来说,这类消息的价值不在于某个单一模型,而在于平台化的训练能力正在快速覆盖主流模型家族。当一个训练平台同时支持 GLM、Kimi、Qwen 等多个来源的模型时,开发者可以在同一套工作流下横向比较、灵活切换,而无需为每个模型单独搭建训练环境。
Serverless 训练模式的核心价值
所谓 Serverless Training,即开发者无需自行管理 GPU 集群、调度资源或维护底层基础设施,训练任务按需触发、按用量计费。这种模式降低了模型微调的门槛——过去要跑一次定制化训练,团队往往需要提前采购或租赁算力、配置分布式框架、处理各种环境依赖,而 Serverless 把这些复杂度收敛到 API 背后。
原文中一句话点出了这类产品的态度差异:「No sales demo or DMs required.(无需销售演示或私信对接)」。这意味着开发者不必经过冗长的商务流程,可以直接通过文档或现成的配方(recipe)开始训练。官方的表述是「Here to help as needed, but you can also spend that time building.」——把决定权和时间交还给开发者,让他们把精力放在真正的构建上,而不是消耗在对接环节。
从技术实现角度看,Serverless Training 通常依托云厂商的弹性计算资源池,通过容器化和任务队列机制,在用户提交训练作业时动态分配 GPU 实例,任务结束后即释放资源。与长期租赁 GPU 实例(如 AWS EC2 p3/p4 系列或 A100 裸机)相比,Serverless 模式的优势在于「零闲置成本」——只有计算真正发生时才产生费用。对于训练频率不固定的团队,这可以显著降低实际支出。代价是:任务启动存在冷启动延迟,超大规模训练的定制化调优空间也相对有限。因此,Serverless Training 更适合中小规模的微调场景(如 LoRA、QLoRA 等参数高效微调方法),而非从头预训练数十亿参数量级的基础模型。
覆盖多模型意味着什么
GLM、Kimi、Qwen 分别来自不同的研发团队,它们在参数规模、架构设计、语言能力上各有侧重。一个训练平台能够同时托管这些模型,说明其在模型接入的抽象层做得足够通用。
对使用者而言,这带来几个直接好处:
- 横向评测更容易:同一份数据集、同一套训练配置,可以快速在多个基座模型上跑出对比结果,帮助选型。
- 迁移成本降低:当某个模型发布新版本(如从 GLM 5.3 到即将到来的 GLM 5.3 Flash),切换基座的改动被控制在最小范围。
- 规避单一供应商锁定:不把所有微调工作绑定在单一模型生态上,为后续调整留出余地。
GLM 5.3 Flash 的预告则暗示了「标准版 + 轻量版」的产品分层思路——Flash 通常代表更快的推理速度和更低的成本,适合对延迟和预算敏感的场景。
GLM(General Language Model)由清华大学 KEG 实验室与智谱 AI 联合研发,以双向注意力与自回归填空为核心架构特征;Qwen 系列来自阿里巴巴通义实验室,以多语言能力和长上下文支持见长;Kimi K3 则出自月之暗面,在长文本处理上有差异化投入。三者架构差异意味着同一份数据集在不同基座上的表现可能有实质性差别。平台能统一托管它们,背后通常依赖对 Hugging Face Transformers 接口的标准化封装——绝大多数主流开源模型均已兼容该接口,这使得「模型接入抽象层」的工程成本大幅降低,而非需要为每个模型单独开发适配层。
从文档或现成配方起步
官方给出的上手路径很直接:从文档开始,或直接使用预制的训练配方(pre-made recipe)。配方化的设计对新手尤其友好——它把常见的微调任务(如指令微调、领域适配)封装成可复用的模板,开发者只需替换数据和少量参数即可运行,无需从零编写训练脚本。
这种「开箱即用」的思路,正逐渐成为 AI 训练工具的标配。它反映出一个趋势:模型微调正从少数专家的专属技能,走向更广泛的应用开发者群体。
「配方(recipe)」这一概念借鉴自 PyTorch 官方的 torchtune 项目及部分 MLOps 平台的设计语言,指将一次完整训练实验的超参数、数据处理流程、模型配置打包成可版本控制的配置文件或脚本模板。常见的微调配方包括:全参数微调(Full Fine-tuning)、LoRA(Low-Rank Adaptation,仅训练少量低秩矩阵以节省显存)、以及 QLoRA(在 LoRA 基础上引入 4-bit 量化,可在单张消费级 GPU 上运行)。对于大多数垂直领域适配任务,QLoRA 或 LoRA 配方已能达到接近全参数微调的效果,同时将显存需求压缩至可接受范围,这也是 Serverless 平台重点支持此类配方的主要原因。
小结
GLM 5.3 上线 Serverless Training API 本身是一次常规的平台能力扩充,但它折射出当下开源模型工具链的两个方向:一是训练基础设施的 Serverless 化,把算力和运维复杂度隐藏在 API 之后;二是多模型统一托管,让开发者在 GLM、Kimi、Qwen 等选项间自由权衡。对于希望快速验证想法、又不想被繁琐流程拖慢的团队来说,这类「少沟通、多构建」的产品定位确实切中了痛点。
需要提醒的是,原文为一条简短的产品公告,关于 GLM 5.3 的具体训练性能、支持的微调方法、定价细节等信息尚未披露,建议以官方文档为准。
相关推荐
给AI代理网页收费:我看着Claude付了每页一分钱
一位开发者给访问网站的AI代理设置每页一分钱的收费门槛,并见证Claude自动完成支付。这一实验揭示了AI代理经济、HTTP 402微支付与内容变现的新可能,也引出成本失控与标准碎片化等争议。
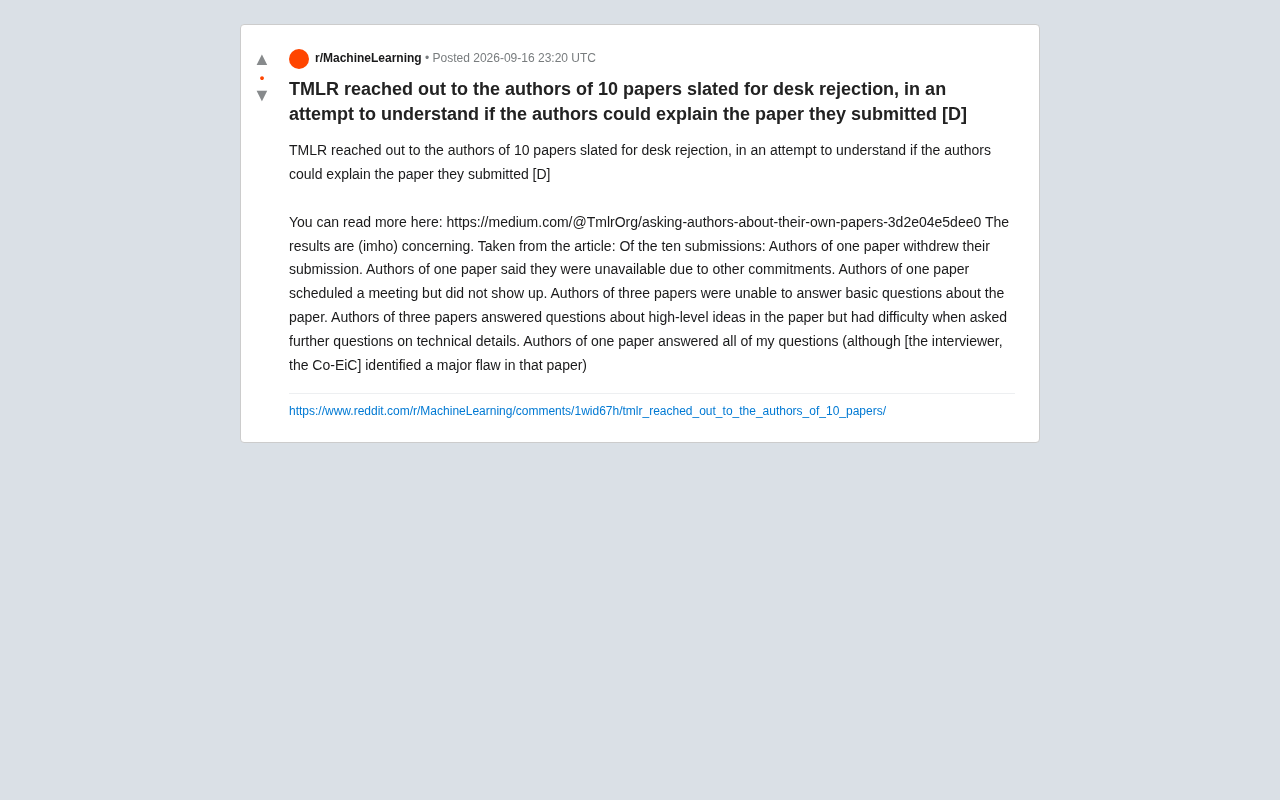
TMLR新实验:让作者解释自己的论文,结果令人担忧
机器学习期刊TMLR联系10篇桌拒论文的作者,请他们亲口解释自己的投稿,结果令人担忧:多数作者无法回答基础问题或讲不清技术细节。本文解读这一实验及其对AI时代学术诚信与同行评审的启示。
AI Agent 流水线中的劣质音频处理:架构策略与实战指南
面对回声、含混、噪声严重的劣质录音,AI Agent 语音流水线该如何设计?本文梳理音频预处理、STT 置信度护栏、幻觉检测与多 Agent 交叉验证等实战架构策略,帮你避免转录幻觉与上下文丢失。