GLM-5.3在Workers AI泄露用户提示词:SGLang修复清单
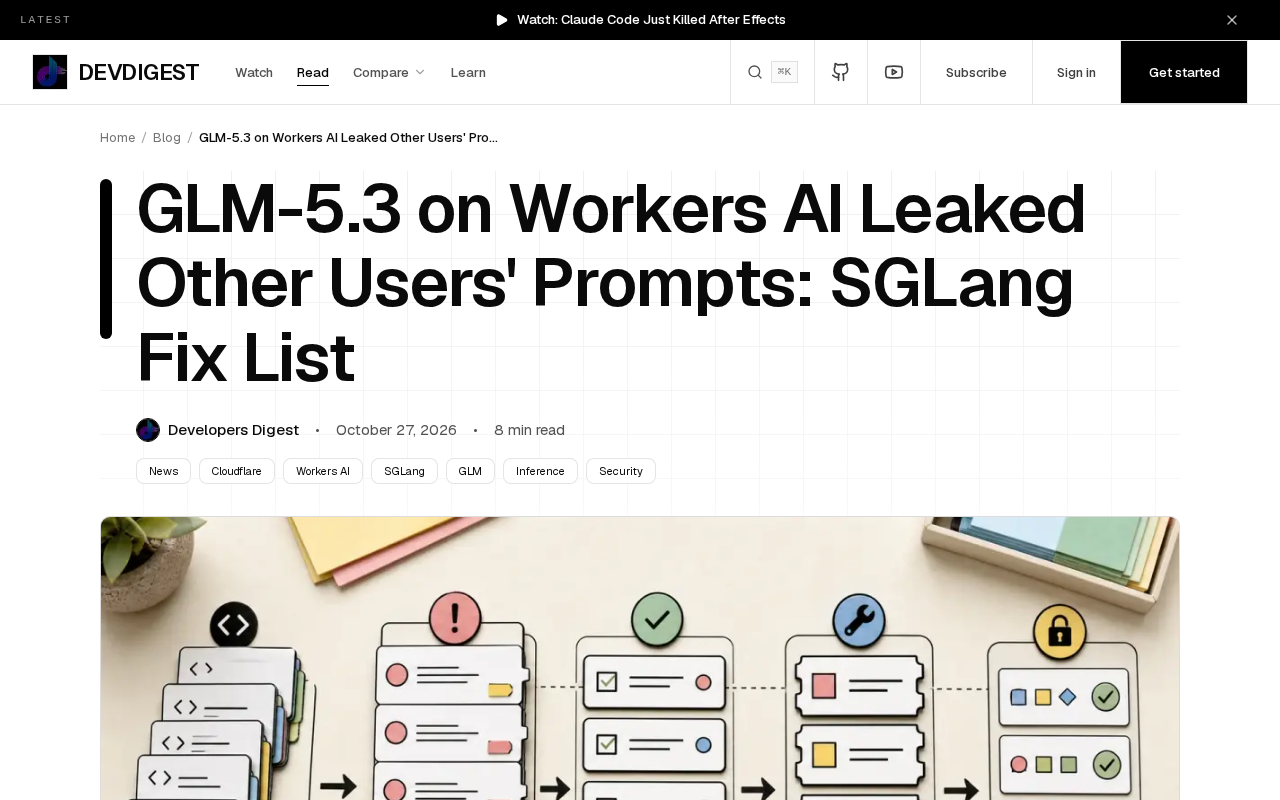
Cloudflare GLM-5.3 端点长提示词泄露他客数据,暴露推理栈多租户隔离缺陷。
Cloudflare Workers AI 上的 GLM-5.3 端点在 155 条长提示词响应中返回了其他客户的数据,构成跨用户内容泄露。文章分析指出,泄露与推理栈中共享状态机制的高风险环节相关,包括 SGLang 的前缀缓存键设计、动态批处理的请求生命周期管理以及流式响应缓冲区清理。由于泄露响应语法完整、不触发错误率告警,常规监控难以发现。文章提出升级组件、检查多租户缓存键与批处理配置、增加内容级隔离审计等修复清单,并建议 API 用户向服务商追问租户混跑策略与事件通知能力,呼吁将多租户隔离纳入持续集成和上线门槛。
Cloudflare 的 GLM-5.3 Workers AI 端点被曝在部分长提示词响应中返回了其他客户的数据。据原始报道,共有 155 条长提示词响应出现了跨用户内容泄露。这起事件不仅暴露了推理服务栈中的隔离缺陷,也给所有通过 API 调用大模型的服务商和开发者敲响了警钟:当模型托管在共享推理基础设施上时,会话隔离与缓存管理必须被当作一等公民来对待。
事件回顾:长提示词触发的跨用户泄露
根据原始素材,问题出现在 Cloudflare Workers AI 平台上运行的 GLM-5.3 模型端点。当请求的提示词较长时,部分响应中混入了其他客户的内容。155 条受影响响应这一数字来自原始报道,说明泄露并非孤立个案,而是在特定负载模式下可复现的系统性问题。
长提示词之所以成为触发条件,通常与推理引擎对上下文长度、批处理策略和 KV 缓存的管理方式有关。当多个请求被动态批处理到同一推理批次中,若会话边界标记或缓存键设计存在缺陷,一个请求的上下文就可能被错误地关联到另一个请求的输出上。
对于 API 使用者而言,这类问题的危险在于它不会以报错形式出现。用户看到的是一个语法完整、看似合理的响应,只是内容属于别人。这意味着常规的健康检查和错误率监控无法发现泄露,必须依赖专门的内容隔离审计。
SGLang 推理栈中可能出问题的环节
SGLang 是当前被广泛采用的高性能大模型推理框架,其核心优势在于 RadixAttention 前缀缓存和高效的批处理调度。这些优化在提升吞吐量的同时,也引入了共享状态的复杂性。
从架构上看,可能出问题的环节集中在几处。其一是前缀缓存的键设计:如果缓存键没有完整包含租户标识或会话标识,不同用户的相同前缀就可能命中同一缓存条目。其二是批处理调度中的请求生命周期管理:当长提示词导致请求在队列中停留时间变长,调度器对槽位的复用逻辑若存在竞态条件,就可能把残留上下文带给下一个请求。其三是流式响应路径上的缓冲区清理不彻底。
原始素材以“SGLang Fix List”为线索,指向的正是这类推理层缺陷。需要说明的是,具体是哪一处代码路径导致本次泄露,原始素材未给出完整的技术根因分析,因此这里讨论的是该类系统中高风险区域的合理推断,而非对官方结论的复述。
RadixAttention 前缀缓存是 SGLang 的核心优化技术,其原理是将多个请求的提示词构建成一棵基数树(Radix Tree),相同的前缀只计算一次 KV 缓存,后续请求可直接复用。这种共享机制在多租户场景下需要严格的缓存键设计:键中必须包含租户或会话的唯一标识,否则不同用户的相同前缀会命中同一缓存条目,导致上下文串扰。KV 缓存本身是注意力机制中键值对的中间计算结果,占用大量显存,因此推理引擎倾向于尽可能复用而非丢弃,这也放大了隔离缺陷的后果。
动态批处理(Continuous Batching) 指推理引擎将不同请求的 token 在迭代级别动态拼接成批次,以最大化 GPU 利用率。批处理调度器维护每个请求的生命周期和槽位分配,当长提示词导致请求驻留时间延长时,槽位复用若缺乏严格的会话边界清理,残留的 KV 状态就可能被下一个请求读取。流式响应路径上的缓冲区同样需要按请求隔离,避免在异常中断或超时后未彻底重置。
升级与配置检查清单
针对此类问题,运维和平台团队应当建立一套可执行的核查流程。以下清单综合了推理服务安全加固的通用实践,并与原始素材强调的升级与配置方向保持一致。
升级层面
第一时间跟进 SGLang 及 Workers AI 相关组件的最新版本,是消除已知缺陷最直接的手段。升级时应关注发布说明中与缓存隔离、批处理调度、多租户支持相关的条目,而不是只看性能数字。对于自建推理集群的团队,建议在灰度环境中先用长提示词和多租户并发场景做回归测试,确认隔离行为符合预期后再全量上线。
配置层面
配置检查应覆盖几个关键点。确认多租户部署下缓存键是否包含租户维度;确认批处理的最大序列长度和并发数设置不会导致请求被过度拼接;确认流式接口在异常中断后是否正确重置会话状态;确认日志中是否记录了足够的请求标识以便事后审计。这些配置项单独看都是性能调优参数,但在共享推理场景下,它们同时是安全边界。
监控层面
常规的延迟和错误率指标不足以发现内容泄露。建议增加基于内容指纹的抽样比对,例如对响应内容与请求上下文做一致性校验,或者在不同租户的请求中注入只应属于该租户的标记,定期验证标记不会出现在他人响应中。
内容指纹是一种轻量级的内容一致性校验手段,通常通过对文本做哈希或提取 n-gram 特征生成唯一标识。在推理服务监控中,可以将请求上下文的指纹与响应中疑似上下文片段做比对,若响应中出现了不属于当前租户的指纹标记,即触发告警。另一种实践是金丝雀标记(Canary Token):在请求中注入只属于该租户的随机字符串,若该字符串出现在其他租户的响应中,即可确认隔离边界被突破。这类方法不依赖对模型输出的语义理解,成本低且可自动化,适合作为多租户推理服务的常态化审计手段。
API 用户应当向服务商追问什么
对于依赖托管 API 的开发者,这起事件提示了几个必须问清楚的问题。服务商是否在同一推理实例上混跑不同客户的长上下文请求?缓存和批处理的隔离机制是如何设计的?发生类似事件时,服务商是否有能力定位到受影响的请求范围并主动通知?内容泄露的检测和响应流程是否公开可查?
这些问题听起来偏重合规,但它们直接决定了下游应用的数据风险。尤其是处理敏感业务数据的团队,应当把推理层的隔离能力纳入供应商评估清单,而不只是比较模型效果和价格。
对行业的启示
大模型推理正在从单租户实验走向多租户规模化服务,性能优化与安全隔离之间的张力会越来越明显。前缀缓存、动态批处理、流式输出这些提升效率的技术,本质上都在共享状态,而共享状态就是隔离风险的来源。
这起泄露事件的价值不在于指责某个框架,而在于提醒整个生态:推理栈的安全测试需要专门设计,不能只依赖功能测试和性能压测。对于框架维护者,这意味着要把多租户隔离纳入持续集成;对于平台方,这意味着要把内容隔离审计作为上线门槛;对于应用开发者,这意味着要对托管服务的隔离能力保持合理的怀疑并做好数据分级。
多租户隔离在推理服务中涉及多个层面:网络与进程隔离、显存与 KV 缓存隔离、调度队列隔离以及输出缓冲区隔离。与传统 SaaS 多租户不同,大模型推理的共享粒度更细——不仅共享计算资源,还共享中间计算结果(KV 缓存)和批处理批次。因此,隔离设计需要贯穿推理引擎的整个数据流,而不仅是部署架构。持续集成中的隔离测试应包含多租户并发压测、长上下文交错请求、异常中断恢复等场景,并将内容泄露检测作为断言条件,而非仅验证功能正确性与吞吐指标。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。