GPEvac:用GNN+PPO为枪击事件规划实时逃生路径
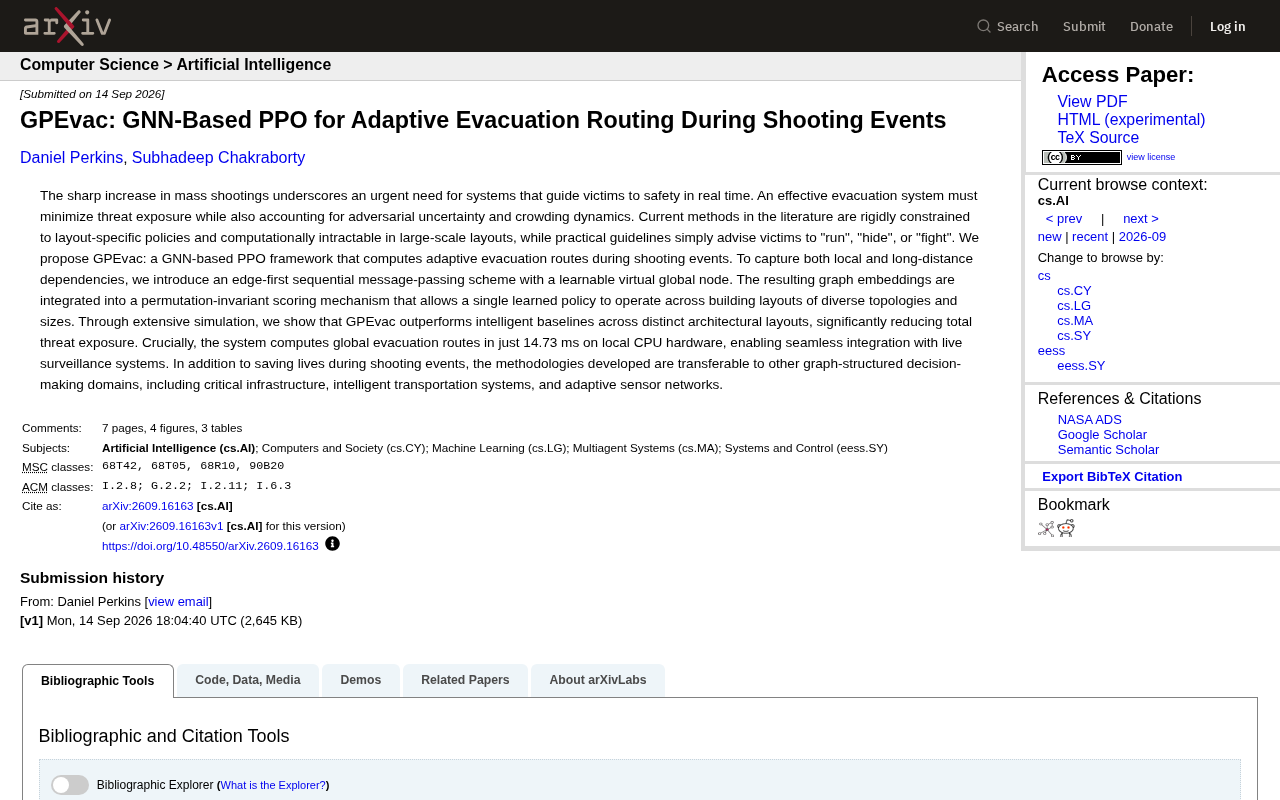
GPEvac将图神经网络与强化学习结合,在14毫秒内为枪击事件生成可跨建筑通用的实时疏散路线。
面对"跑、躲、抗"口号的局限,来自 arXiv 的研究提出 GPEvac 系统,将图神经网络(GNN)与 PPO 强化学习结合,为枪击事件实时计算自适应逃生路线。其核心创新在于边优先顺序消息传递机制与可学习虚拟全局节点,使模型能同时捕捉局部通道状态与全楼宏观态势;置换不变评分机制则让单一训练策略无需重训即可迁移至不同建筑布局。系统在本地 CPU 上仅需 14.73 毫秒完成全局路线计算,可与现有监控系统无缝集成。研究团队还指出,这套图决策框架在关键基础设施、智能交通和传感器网络等领域同样具有迁移潜力。目前成果仍处于仿真阶段,真实场景的验证路径尚待完成。
当"跑、躲、抗"不再够用
面对突发枪击事件,官方安全指南给出的建议往往只有三个词:跑(Run)、躲(Hide)、抗(Fight)。这些原则简单易记,却缺乏对现场态势的动态感知——受害者无法判断哪条通道更安全,也无法预知人群拥挤和威胁移动会带来的连锁风险。
一篇新发布于 arXiv 的研究提出了名为 GPEvac 的系统,试图用人工智能填补这一空白。它将图神经网络(GNN)与强化学习中的 PPO(近端策略优化)算法结合,能够在枪击事件发生时实时计算出自适应的逃生路线,目标是把受害者暴露在威胁下的风险降到最低。
研究团队指出,现有的疏散路径方法存在两大硬伤:一是过度依赖特定建筑布局,一套策略换个场地就失效;二是计算复杂度过高,在大规模空间布局中几乎无法实时运行。GPEvac 正是冲着这两个痛点而来。
技术核心:边优先消息传递与虚拟全局节点
把建筑物抽象成图结构是这类问题的自然选择——房间和走廊是节点,通道连接是边。但传统 GNN 在捕捉长距离依赖时往往力不从心,而疏散决策恰恰既要考虑局部通道情况,又要顾及整栋建筑的宏观态势。
GPEvac 的关键创新在于引入了一套边优先的顺序消息传递机制(edge-first sequential message-passing),并加入了一个可学习的虚拟全局节点(learnable virtual global node)。这个全局节点相当于给图结构安装了一个"信息中枢",让远距离的节点也能高效交换信息,从而同时捕捉局部与长距离的依赖关系。
生成的图嵌入随后被送入一个置换不变(permutation-invariant)的评分机制。这一设计的意义在于:单一训练好的策略可以直接迁移到拓扑结构和规模各异的建筑布局中,而无需针对每栋楼重新训练。这直接解决了传统方法"换个场地就失效"的老问题。
**图神经网络(GNN)**是一类专门处理图结构数据的深度学习模型。与处理网格状数据(如图像)的卷积神经网络不同,GNN 通过"消息传递"机制在节点之间传播信息:每个节点收集邻居的特征,聚合后更新自身表示,经过多轮迭代后形成能捕捉图拓扑结构的节点嵌入。然而,标准消息传递存在"过度压缩"问题——随着层数增加,远距离节点的信息在传播中逐渐稀释,导致模型难以感知全局结构。GPEvac 的边优先机制优先更新边的状态再传递给节点,相当于让通道连接关系本身也成为可学习的信息载体;而虚拟全局节点则与所有真实节点直接相连,提供了一条不受图直径限制的"快速通道",使任意两点间的信息交换最多只需两跳即可完成,从根本上解决了长距离依赖的衰减问题。
性能表现:14.73 毫秒的实时响应
研究团队通过大量仿真验证了 GPEvac 的表现。结果显示,在不同建筑布局下,GPEvac 均优于智能基线方法,能够显著降低受害者的总威胁暴露量。
更具实用价值的是它的计算速度:系统在本地 CPU 硬件上仅需 14.73 毫秒即可计算出全局疏散路线。这个数字意味着 GPEvac 不需要昂贵的 GPU 集群,就能与现有的实时监控系统无缝集成——当监控画面捕捉到威胁位置时,系统几乎可以立即为不同区域的人群生成对应的撤离方案。
对于安防应用而言,毫秒级的响应能力是能否真正落地的分水岭。任何需要几秒甚至几分钟计算的系统,在瞬息万变的枪击现场都毫无意义。
**PPO(近端策略优化,Proximal Policy Optimization)**是强化学习中一种被广泛采用的策略梯度算法,由 OpenAI 于 2017 年提出。强化学习的核心思路是让智能体在环境中反复试错、通过奖励信号学习最优策略,但早期算法常因策略更新步长过大而导致训练不稳定。PPO 通过引入"裁剪"机制,限制每次策略更新的幅度,在保证训练稳定性的同时维持较高的样本效率。在 GPEvac 中,强化学习负责解决"在动态威胁环境下如何为每个区域选择最优撤离方向"这一序列决策问题,而 GNN 则负责将建筑物的图结构特征编码成策略网络可以直接利用的输入表示——两者的结合使系统既能理解空间拓扑,又能针对实时变化的威胁位置做出最优响应。
不止于救援:可迁移的图决策框架
虽然论文的直接动机是应对不断上升的大规模枪击事件,但研究团队强调,GPEvac 所发展的方法论具有更广泛的可迁移性。任何可以建模为图结构的动态决策问题,理论上都能借鉴这套框架,包括:
- 关键基础设施的调度与防护
- 智能交通系统的路径优化
- 自适应传感器网络的资源分配
换句话说,边优先消息传递加虚拟全局节点的组合,本质上是一种应对"局部与全局并重、且需实时决策"的通用图学习范式,其应用边界远超疏散场景本身。
一点冷静的观察
作为一篇仿真阶段的研究,GPEvac 的成果目前仍停留在模拟环境中。真实枪击场景的混乱程度、人群的非理性行为、威胁位置感知的准确性等因素,都远比仿真复杂。把"降低威胁暴露"从仿真指标转化为真实的生命拯救,中间还有相当长的验证路径。
但这项工作的价值在于,它把一个原本只有"跑、躲、抗"三条口号的领域,推进到了可量化、可优化、可实时计算的技术层面。在 AI 越来越多地介入公共安全的当下,GPEvac 提供了一个兼顾算法创新与工程可行性的样本。
相关推荐
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。
让AI自己开发AI工具:7天31次提交的自举踩坑实录
一位工程师让AI自动开发AI工具,7天跑出31个commit,自举成功率仅六分之一。本文复盘五类典型踩坑、11条结构性规律及AI审AI机制,揭示自举飞轮如何把失败变成永久免疫。