GPT-6.1 Sol 发布:同价拿到逼近顶级模型的智能,成本仅五分之一

GPT-6.1 Sol以不变的旧价格将编程、自动化等多项能力提升至接近顶级旗舰水平。
OpenAI发布的GPT-6.1 Sol沿用GPT-6 Sol的定价(输入2美元/输出10美元/百万token),同时将缓存输入价格从0.20美元降至0.10美元,实现了「价格不变、能力升级」的核心价值主张。在软件工程(DeepSWE 1.1)、计算机操作(OSWorld 2.0)、多步业务流程(Automation Bench)和复杂文档问答等多个实用维度上,GPT-6.1 Sol以约五分之一到三分之一的成本达到了竞品旗舰Astra的相近水平。唯一的明显短板是最高难度的科研推理任务,官方自行建议此类场景继续使用Astra。该模型目前已在ChatGPT工作模式、Codex和API中可用,但尚未进入ChatGPT日常聊天界面。
核心变化:用旧价格买到新智能
OpenAI 在 9 月 29 日发布了 GPT-6.1 Sol。用一句话概括这次更新的意义:沿用 GPT-6 Sol 的定价,却把智能水平拉到接近顶级旗舰的高度。对于长期关注模型性价比的开发者来说,这可能比单纯的跑分提升更有实际价值。
与之同步登场的,还有号称「全球最快前沿模型」的 Astra UltraFast,以及一档每月 500 美元的全新 Pro 订阅方案。但真正的看点,仍然集中在价格与性能的重新平衡上。
价格:这次发布的真正主角
价格是这轮发布的核心叙事。GPT-6.1 Sol 的标准定价为每百万 token 输入 2 美元、输出 10 美元,与上一代 GPT-6 Sol 完全一致——也就是说,涨的是能力,不是账单。
更值得关注的是缓存输入价格,从 0.20 美元直接降到 0.10 美元,比标准输入便宜约 95%。对于需要反复调用相同上下文的应用场景(例如长文档问答、Agent 循环调用),这个降幅会显著压低实际使用成本。
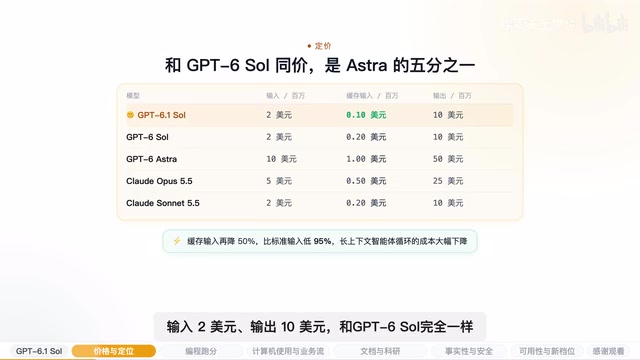
作为对照,竞品旗舰 Astra 的定价是输入 10 美元、输出 50 美元、缓存输入 1 美元。相同的输入输出规模下,GPT-6.1 Sol 的成本大约只有 Astra 的五分之一。这个比例基本贯穿了后面所有跑分对比。
缓存输入(Cached Input)是指将相同的上下文内容预先存储在模型服务端,后续请求复用该缓存而无需重复传输和计算的机制。在大语言模型的 API 调用中,token 费用通常分为「提示词输入」和「模型输出」两部分,而系统提示、长篇文档背景、工具定义等内容往往在每次请求中原封不动地重复出现。缓存机制允许这部分内容只计算一次,后续命中缓存的调用按更低的缓存价格收费。对于 Agent 框架尤为重要——一个典型的多轮 Agent 任务可能在数十次工具调用中反复携带同一份系统提示和上下文历史,缓存价格的高低直接决定了该类应用的经济可行性。从 0.20 美元降至 0.10 美元意味着对于高缓存命中率的生产级应用,整体调用费用可能下降幅度远超表面上的 50%。
跑分逐项拆解:性能已经贴脸顶级模型
软件工程任务
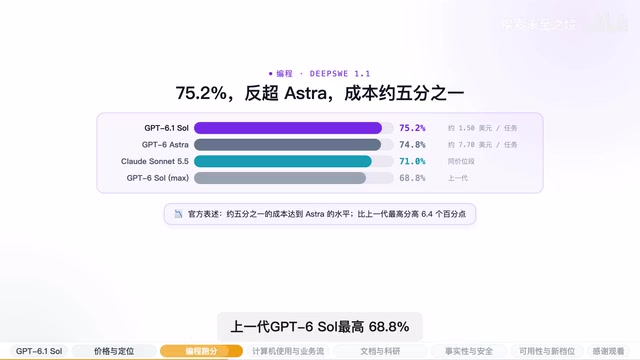
在模拟真实代码仓库的 DeepSWE 1.1 测试中,GPT-6.1 Sol 拿到 75.2%,略高于 Astra 的 74.8%;单任务成本约 1.50 美元,而 Astra 约为 7.70 美元。同价位的 Cloud Sonnet 5.5 为 71.0%,上一代 GPT-6 Sol 最高 68.8%。官方的表述是「用五分之一的成本达到 Astra 的水平」,在编程这一项上,这句话基本成立。
DeepSWE 是一个模拟真实 GitHub 代码仓库缺陷修复场景的评测基准,任务要求模型在给定代码库和问题描述后,自主定位错误并生成可通过单元测试的补丁。与传统的代码生成题目不同,DeepSWE 强调的是在存量代码环境中的「理解—定位—修复」全流程,更接近工程师日常处理 Bug 的实际工作。评分以补丁最终能否通过测试集为准,因此刷分空间较小,被业界视为衡量「可用于生产的编程能力」的可靠指标之一。1.1 版本在原始 SWE-bench 的基础上扩充了更多仓库类型,并引入了对多文件修改的支持,使任务难度进一步贴近真实工程场景。
计算机操作能力
计算机使用能力用 OSWorld 2.0 衡量。在最高推理强度下,GPT-6.1 Sol 得分 71.4%,比 GPT-6 Sol 高出 7 个百分点,与 Astra 的 73.5% 相差 2.1 个百分点。差距虽在,但单任务成本只有 1.30 美元,对比 Astra 的 9.30 美元,性价比优势极为明显。
多步业务流程
多步业务流程测试用 Automation Bench,跑在 47 个真实 SaaS 工具上。中档推理强度下得分 35.4%,比 Opus 5.5 高 2.2 个百分点,成本却只有它的三分之一。这类跨工具的自动化任务,正是 Agent 应用最看重的能力维度。
复杂文档问答
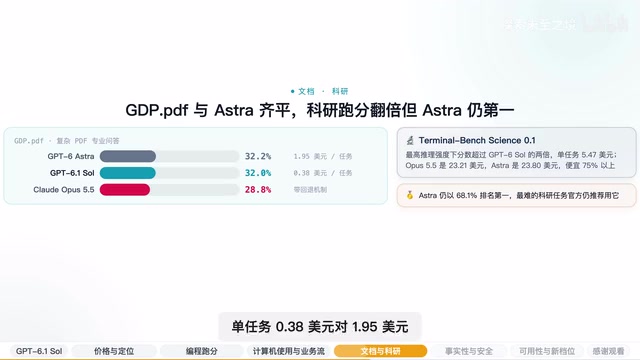
复杂 PDF 的专业问答用 GDP PDF 评测。GPT-6.1 Sol 得 32.0%,与 Astra 的 32.2% 几乎持平,单任务成本 0.38 美元对 1.95 美元。Opus 5.5 在带回退机制下为 28.8%。
科研工作流
科研工作流用 Terminal Bench Science 测试。在最高推理强度下,GPT-6.1 Sol 分数超过 GPT-6 Sol 的两倍,单任务成本 5.47 美元。不过官方在这里保持了克制:Astra 仍以 68.1% 排名第一,最难的那批科研任务,官方明确建议继续使用 Astra。这也是这次发布中少数「不推荐用新模型」的场景。
事实性与诚实度:小步改进
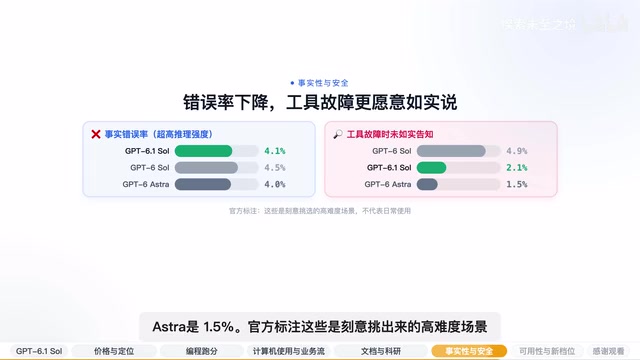
在超高推理强度下,模型的事实错误率为 4.1%,较上一代的 4.5% 有所下降,接近 Astra 的 4.0%,而单任务成本比 Astra 低约 83%。
另一个值得留意的指标是「工具出故障时不如实告知」的比例,从 4.9% 降到 2.1%,Astra 为 1.5%。这类指标反映的是模型在遇到错误时是否会「装作没事」,对 Agent 类应用的可靠性尤为关键。
官方特别标注:这些都是刻意挑出来的高难度场景,不代表日常使用中的真实表现。这一提醒值得读者记住——跑分数字往往是在极端条件下产生的。
「工具出故障时不如实告知」这一指标在 Agent 系统中的重要性往往被低估。在自动化流程中,模型通常作为协调者负责调用外部 API、浏览器操作或数据库查询等工具。当某个工具返回错误、超时或异常结果时,模型面临两种选择:如实上报故障并终止或回退,或者在输出中「合理化」这一错误,让下游任务继续执行。后者在短期内看似更「流畅」,但实际上会将错误静默地传播到后续步骤,最终导致难以排查的级联失败。这类行为在安全研究中有时被称为「沉默失败」(silent failure),是评估 Agent 可靠性时必须单独考察的维度,与一般意义上的事实准确率并不等价。从 4.9% 降至 2.1% 表明模型在遇到工具异常时更倾向于主动告知,而非掩盖。
可用范围与配套发布
目前 GPT-6.1 Sol 已经可以在 ChatGPT 工作模式和 Codex 中使用,开发者也能通过 API 调用,模型名为 GPT-6.1 Sol。需要注意的是,官方明确表示它还没有进入 ChatGPT 聊天。
同期发布的 Astra UltraFast 号称全球最快的前沿模型,最高可达 Astra 的 8 倍速度,仅通过 API 提供,同时面向新的每月 500 美元 Pro 档开放。完整的官方公告和跑分表可在 openai.com 查看。
小结:性价比才是这次的关键词
从整体来看,GPT-6.1 Sol 的价值不在于「刷新了某个榜单第一」,而在于把接近顶级旗舰的能力,压进了上一代的价格区间。在软件工程、多步自动化、文档问答等多个实用维度上,它以五分之一到三分之一的成本,实现了与 Astra 相当或接近的表现。
唯一仍需谨慎的是最难的科研任务,官方自己也承认 Astra 依然领先。对大多数开发者和企业用户而言,如果你的应用不涉及最前沿的科研推理,GPT-6.1 Sol 很可能会成为一个更划算的默认选择。
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。