GPT-6.1 Terra实测:56秒建3D房,比Soul快5倍还便宜

实测 GPT-6.1 Terra:快 5 倍、省 15 倍,中档够用,最高档未必划算。
文章记录了一位 B 站 UP 主在 Codex 中对 OpenAI 新一代 GPT-6.1 Terra 的实测。同一张手绘平面图转 3D 模型的任务中,中档 Terra 56 秒交卷,比 Soul 快约 5 倍、比 Astra 快 6 倍多,成本仅约 6 美分,是 Astra 的十五分之一;成品质量七八十分,明显优于翻车的上一代。把 Terra 开到最高档后可逼近甚至超过 Astra,但耗时 8 分 23 秒、账单涨到 35 美分,原因是读了 170 万 Token。八道陷阱题四模型全部识破,Terra 速度最快。文章由此解释电脑操作任务步数多、每步重复读屏,快和便宜比微小智能差距更关键,并给出日常用 Terra 中档、精细活换 Soul/Astra 的选购建议。
OpenAI 新一代模型 GPT-6.1 Terra 发布后,官方宣称它比自家 GPT-6.1 Soul 和 GPT-6 Astra 快三倍,价格却只要 Soul 的一半。一位 B 站 UP 主把同一张悉尼老房子手绘平面图同时交给 Terra、Soul、Astra 和上一代 GPT-5.6 Terra,在 Codex 里跑了一场实测。结果有些出乎意料:Terra 56 秒第一个交卷,做出来的 3D 模型有模有样,成本却只有 Astra 的十五分之一。
四档模型怎么选?Terra 定位“又快又便宜”
OpenAI 现在把模型分成四档:最轻的 Luna 负责日常简单任务,Terra 是中间档主力,Soul 是主力旗舰,Astra 是最强档。Terra 的定位很明确——不追求最聪明,而是追求又快又便宜,主推电脑操作场景,也就是让 AI 自己看屏幕、点鼠标、打字,在不同软件之间来回跑。
价格按 Token 计算:Terra 每 100 万输入 Token 1 美元、输出 5 美元;Soul 是 2 美元和 10 美元;Astra 是 10 美元和 50 美元。最贵那档的单价整整差了 10 倍。ChatGPT Plus、Pro 等付费用户可以在 ChatGPT 和 Codex 里直接使用,开发者也能通过 API 调用。
推理档位(Reasoning Effort) 是 OpenAI 在 o 系列及后续模型中引入的可调参数,通常分为 low / medium / high 等几级。它控制模型在给出答案前进行内部“思考”的深度:档位越高,模型生成的思维链(chain-of-thought)越长,越可能尝试多种解法并自我检查,但耗时和 Token 消耗也成倍增加。同一模型在不同档位下,能力上限和成本可以差出数倍,因此“模型型号”和“推理档位”是两个独立维度。文中 Codex 里新模型默认最低档,UP 主统一调高到中档,正是为了让四个模型在同等“思考预算”下比较。
官方成绩单:快三倍,错误率大幅下降
OpenAI 给了一份内部评测成绩。在一个叫 Agent's Last Exam 的专业任务考试中,中等推理档的 Terra 比上一代高 15 个百分点,成本只有三分之一,表现与最强的 Astra 接近,而每个 Token 的价格只有 Astra 的十分之一。OpenAI 还点名对比了竞争对手:开到最高档时,每个任务的成本比 Claude Ocus 5.5 低大约 9 倍。
速度方面,Terra 比 Soul 和 Astra 都快三倍多。低推理档的事实错误率从 53.6% 降到 16.7%。在命令行编程测试中,最高档从上一代的 21.5% 涨到 50.3%。不过 OpenAI 自己也承认,最难的编程任务还是交给 Soul 或 Astra 更稳妥。
这些数字都是 OpenAI 自己出题自己打分,所以 UP 主决定亲自上手验证。
Agent's Last Exam 是继“Humanity's Last Exam”之后出现的一类 Agent 基准测试,考察的不是单轮问答,而是模型在专业工作流中自主调用工具、多步推理并交付成果的能力,题目通常由领域专家设计,覆盖编程、科研、财务分析等场景。与此前的静态问答基准相比,它更贴近“让 AI 真正干活”的评测目标。需要注意的是,这类基准多由模型厂商自建或参与,题目分布和评分标准未必中立,因此厂商公布的百分比提升更适合横向看趋势,而非当作绝对能力刻度——这也是原文 UP 主坚持自己动手实测的原因。
实测规则:同一张图、同一句话、统一中档推理
测试在 Codex 里进行,同一张手绘平面图、同一句指令——“做成一个能在浏览器里转着看的 3D 模型”。四个模型全部开到中档推理,因为 Codex 里新的三个模型默认都是最低档,UP 主统一调高了一格。每个模型自己读图、写代码、自己检查,最后交一个网页。
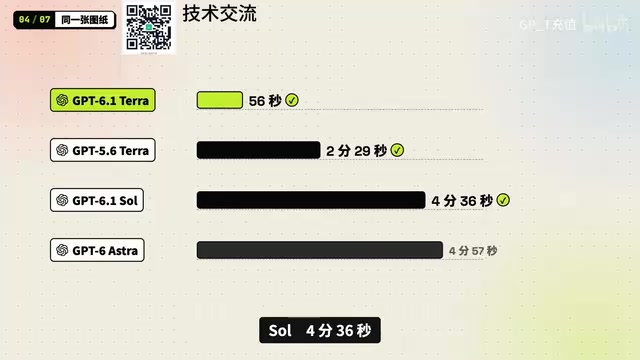
结果:Terra 56 秒第一个交卷,上一代 GPT-5.6 Terra 用了 2 分 29 秒,Soul 4 分 36 秒,Astra 最慢,5 分 45 秒。Soul 的耗时是 Terra 的约 5 倍,Astra 是 6 倍多。官方说快 3 倍,这次实测比官方说的还快。
成品对比:Terra 够用,Soul 和 Astra 更精致
速度之外,质量才是关键。上一代 GPT-5.6 Terra 翻车了:墙面竖起来挡住半个画面,鼠标一转整栋房子跟着翻跟头,上下方向搞反,后台还报了十几个错。
新的 Terra 交出的模型格局对得上,阳台、台阶、卫浴都有,窗户也画了,虽然有点糙,但一眼看得出是那栋房子。Soul 明显更讲究:沙发、床、壁炉砖色都做了,右上角还有开关可以切换平面图、调整墙高。Astra 再上一层,阳台一圈栏杆、宽台阶、家具摆放也最像样。
UP 主还算了一笔账:按 API 标价把消耗的 Token 折成钱,Terra 约 6 美分,Soul 约 20 美分,Astra 约 10 美分。同一张图,Astra 的花费是 Terra 的 15 倍左右。
最高档的 Terra 能追上 Astra 吗?
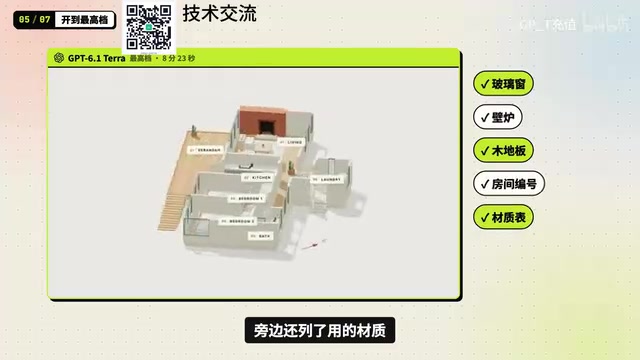
UP 主把 Terra 开到最高档又跑了一遍。这次它想了很久,到处找办法检查自己做的东西,8 分 23 秒才交卷,比 Astra 还慢。成品是玻璃窗、壁炉、木地板,每个房间编了号,旁边还列出使用的材质。跟 Astra 放在一起,UP 主个人觉得不相上下,甚至更好看一点。但账单是 35 美分。
为什么单价只有 Astra 的十分之一,账单却贵了?因为它读了 170 万个 Token,是 Astra 的 6 倍。单价便宜 10 倍不等于账单便宜 10 倍——想得越久,读得越多。
UP 主的结论是:中档 Terra 大概七八十分,但只用了 Astra 六分之一的时间、十五分之一的钱。要 100 分,Terra 开最高档也做得到,只是不再那么快。当然每一路只跑了一次,换一张图结果可能有出入。
陷阱题测试:四个模型全部识破
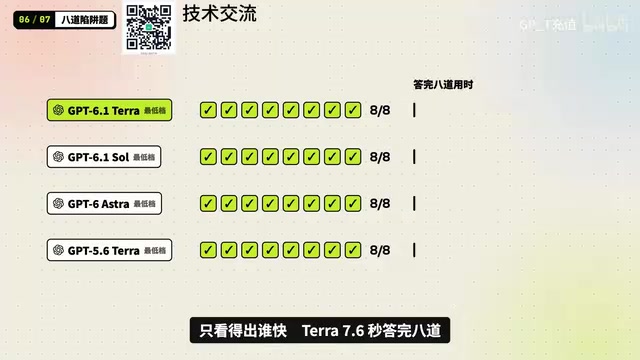
官方说“胡说八道少了”,UP 主出了八道陷阱题,题目本身就是假的,比如“Pixar 1998 年那部灯塔看守人的机器人讲了什么”(根本没这部电影)、“金星最大的卫星叫什么”(金星没有卫星)、“澳洲第七个州的首府在哪”(澳洲只有六个州)。四个模型都用最低档,结果全部识破,一道都没上当。这一项测不出谁更聪明,只看速度:Terra 7.6 秒答完八道,Soul 12 秒,Astra 13 秒,上一代 22 秒。
为什么电脑操作场景更看重快和便宜
账单里藏着另一个答案。中档 Terra 那一路,它自己只写了 4000 个 Token,读进去的却有 11 万——因为干活的 AI 每走一步,都要把前面的对话和图片从头再读一遍。今天这道 3D 建模题才走了几步,电脑操作那种活一个任务动不动几十步,每一步都要重新看一眼屏幕。
对干活的 AI 来说,快和便宜比“聪明那一点点”更要命。这也是 OpenAI 把电脑操作主推给中间档 Terra 的原因。
Agent 的上下文累积机制 是理解账单结构的关键。对话式 Agent 每一步行动(看屏幕、点击、输入)都会产生新的截图和文本,但模型本身是无状态的,所以系统必须把此前所有历史——包括每一张截图——重新拼进提示词再发送一次。这意味着第 N 步的输入 Token 大致与前面所有步骤的内容总量成正比,总消耗随步数呈近似平方增长。截图经视觉编码后占用的 Token 远高于纯文本,因此“读”的量往往几十倍于“写”的量。电脑操作任务动辄几十上百步,成本瓶颈几乎全在输入侧,这也解释了为何单价低十倍的模型,在高档位长时间思考后账单反而更贵。
选购建议:日常用 Terra,精细活换 Soul 或 Astra
UP 主的建议很直接:日常改文件、整理表格、看图跑腿,先交给 Terra,快还省;要做精致的成果或者最难的编程,再换 Soul 和 Astra。在 Codex 里 Terra 默认是最低档,活难一点就把档位往上调一格,但最高档别随手开——又慢又不一定省。
Terra 不是最强的,但它是最划算的。用对地方,它就是你最常用的那个。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。