GPT-6.2双模型Astra与Soul实测对比:同题跑分、成本与选型建议

OpenAI 发布 GPT-6.2 双变体 Astra 与 Soul,同题实测揭示交付逻辑与成本结构差异,并汇总安全事件与工具生态动态。
OpenAI 推出 GPT-6.2 的两个变体 Astra(面向复杂交付)和 Soul(适合日常迭代)。第三方同题测试显示,Astra 在复杂任务和长任务上能力更强但成本更高,Soul 在编码测试中分数不及 Astra 一半但成本仅约五分之一。API 定价 Astra 每百万 Token 输入 8 美元、输出 40 美元,Soul 输入 2 美元、输出 10 美元。DataCamp 测试还发现汇总口径不同会导致结论差异,提醒同题对照需检查方法论。此外,文章汇总了 npm 安全事件、额度调整、Gemini Tasks 免费开放、微软 Ignite 编码工具更新、可灵 Image 4.0 等动态,并给出选型建议:日常迭代用 Soul,复杂交付用 Astra。
OpenAI 发布 GPT-6.2,一次性推出两个变体:Astra 面向复杂交付,Soul 更适合日常迭代。同一道题交给两款模型,结果差异比想象中更大——这不只是跑分高低,而是交付逻辑、成本结构和适用场景的分野。
同一道题,两种交付思路
官方演示里,Astra 把山路画面、悬架运动和轮胎载荷放进同一套驾驶仿真,展示的是多要素协同的复杂任务能力。第三方也用同一道题做了对照。Simon Willison 用 Codex 的 Ultradown 让地图中的城市变成机甲,Astra 与 Soul 都能做出动作,但作者认为变形效果不如 Fable 和 Gemini Carbon 自然——这说明在创意类任务上,两款的差距并没有价格差距那么大。
DataCamp 的测试更能说明问题:让新旧 Astra 用同一份就业数据做看板,新版花费 1 美元 79,旧版 2 美元 93,新版更便宜。但两者汇总口径不同——新版按各专业中位数汇总,旧版按毕业人数加权,导致健康类排名从第四变成第十。同一份数据、同一个问题,方法论差异直接改变结论,这也是评估模型输出时必须交叉验证的原因。
跑分与成本:差距在哪
据 B 站 AI 日报整理的多方评测,AA 三位比赛中 Astra 用 55 道离线交互题做盲评,得分 1318,Soul 为 1259;综合指数另一套题、同为最高推理档,两者分别是 62 和 57。长任务上 Astra 有成本优势:OpenAI 发布的 Agent's Last Exam 对照里,新 Astra 每题约 2 美元 89,旧 Astra 接近 9 美元。
但换到 Cognition 的编码测试,Soul 据称不及 Astra 的一半分数,单题成本却只有约五分之一。标准 API 定价上,每百万 Token,Astra 输入 8 美元、输出 40 美元,Soul 输入 2 美元、输出 10 美元。
这组数据指向一个清晰的选型逻辑:常规改代码可以先跑 Soul,遇到复杂交付再拿自己的任务对照 Astra。Pro 200 的急速挡这轮先给 Soul,也印证了日常场景优先用轻量款的策略。
AA 盲评与综合指数
文中提到的 AA(可能指 Artificial Analysis 或类似评测机构)盲评是一种让模型在不知道自身身份的情况下回答同一组问题的评测方式,以减少品牌偏好带来的偏差。综合指数则是将多个基准测试的成绩加权汇总成一个数值,便于横向比较。1318 与 1259 的差距约 4.7%,属于中等幅度差异,但结合成本差距,选型时需权衡性价比。
Agent's Last Exam 与长任务成本
Agent's Last Exam 是一个针对智能体长任务执行能力的基准测试,要求模型在多步交互中完成复杂目标。新 Astra 每题成本约 2.89 美元,旧 Astra 接近 9 美元,说明模型迭代在保持或提升能力的同时显著降低了推理开销。这种成本下降对需要批量运行长任务的团队尤为重要。
安全事件与额度调整
Wiz 确认 npm 上的 1.26.1 和 1.26.2 版本带有凭据窃取载荷,早上约 5 点半已下架。使用微软 Agent Framework 的团队今天应先查依赖,检索文件、流水线和镜像,跑过受影响版本的环境要隔离并轮换可能暴露的凭据。
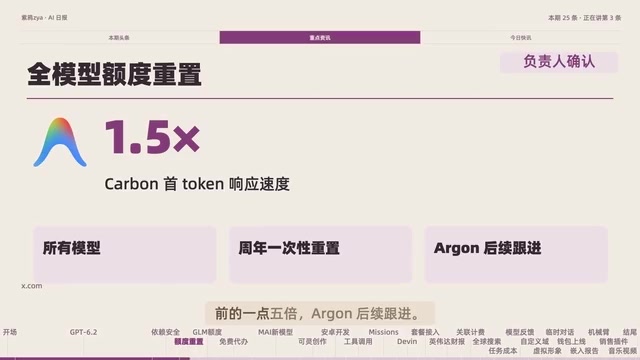
额度方面,Anti-Gravity 负责人确认一周年给所有模型重置额度;Carbon 的首 Token 响应提速到此前的 1.5 倍,Argon 后续跟进。最直接的感受是开始出资更快。OpenCode 的 GLM 活动进入第二阶段,10 美元对应价值 200 美元的 GLM 5.3 用量,比第一阶段翻一倍,已订阅用户可以先看额度页是否更新。
工具生态:从任务代理到开发环境
Gemini Tasks 向美日韩、加拿大、澳大利亚和印度免费开放,可以让他联系车店、把有空的预约放进日历,短信和转发邮件入口先从美国开放。涉及购物时可设消费上限,关键购买步骤会请求确认或预授权。官方已接入 60 多款应用。
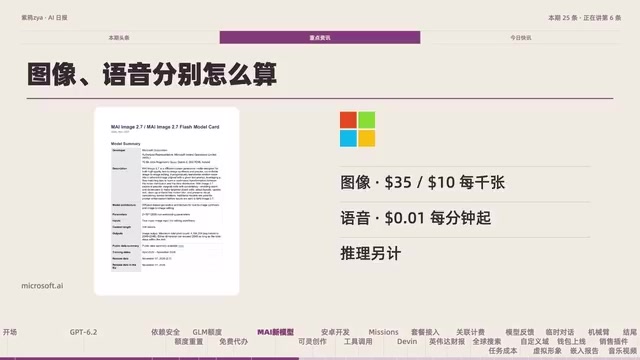
微软 Ignite 这轮先看编码:MacCode R 和 Flash 已进 GitHub Copilot,前者擅长跨文件修改,Flash 也进入免费档。MaiImage 2.7 和 Flash 在 Foundry 公开预览,官方示例价每千张约 35 和 10 美元。语音 RealTime 1 的基础价格每分钟 1 美分,推理另计。
可灵 Image 4.0 的官方样例重点看三件事:原生 8K 能给裁切留空间,单图最高 2000 元;一个提示还能出最多十张连贯组图。实际 API 分辨率要按你用的渠道核对。Google AI Studio 更新安卓开发,浏览器模拟器支持高清和音频,Firerace 可以处理登录和跨设备数据同步,在美国还能把应用发到个人 Play 资料库装到自己手机上。
Cloud Code 的 Code Mode 是实验性预览版,可以先写一段脚本把多个工具调用串起来,长命令跑着也能继续对话,需要 2.1.323 以上原生版并在交互终端打开,桌面版和 VS Code 面板这轮不支持。
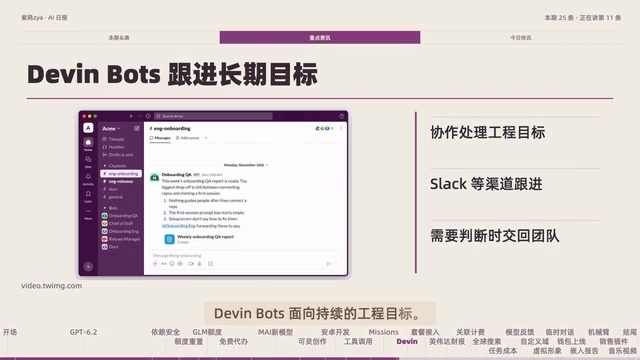
Replete Missions 把目标花费上限和需要批准的动作写在一起,再让智能体并行推进。官方案例在两天、3000 美元预算内做出了自托管监控工具 DataCat 并开放代码,达到预算上限会停下来,任务仍按验收条件判断。DevinBot 面向持续的工程目标,一个 Bot 跑测试发现问题,另一个接去改代码,团队可在 Slack 跟进。两者都值得看,但实际收益取决于团队怎么划权限、怎么验收。
Code Mode 与工具调用编排
Code Mode 是一种实验性功能,允许用户编写脚本将多个工具调用串联起来,形成可复用的工作流。与传统的逐次调用相比,它能减少交互轮次、提升长命令执行效率,并支持在命令运行期间继续对话。目前需要原生版 2.1.323 以上并在交互终端中启用,桌面版和 VS Code 面板暂不支持。
其他动态速览
OpenCloud 宣布 ChatGPT 登录结束测试,可用现有 ChatGPT 套餐接入,官方确认包括 Business 以及两款 GPT-6.2。英伟达公布 2027 财年第三季度财报,营收 1158 亿美元,同比增长 103%,数据中心收入 1076 亿、占约 93%,夏季指引是 1300 亿美元上下 3%,包含额外一周,未计入中国数据中心计算收入。Cloud 关联计费进入测试版,使用 Factory 或 Linear 等接入工具时可授权由自己的 Cloud 组织付费,不必交 API 密钥,应用花费可设上限也能解除授权。
谷歌确认 Hydrogen 已在全球 Search 上线,演示展示更细的搜索拆解、链接与可视化结果。Perplexity Search 和 Computer 也接入了两款新模型,自家 WNDR 评测每题 Astra 约 12 块 5、Sol 2 块 65,同时保留两款的实际分数。负责人确认 Altman 会优先改善新模型的协作体验,这个回应值得对照前面的同题演示,包括模型有没有把关键困难说清楚。
Google AI Studio 的 Build 可以连接自定义域名,适合需要把原型交成正式网站的用户,具体绑定和收费条件看发布面板。GoogleViz 为个人账号免费开放个人形象,用自拍和声样生成虚拟人物再输入解说词。Google 搜索的 AI Mode 增加临时对话,入口在右上角,临时生成不经历史、也不用旧偏好做个性化。美国 iOS 用户现在可以用 Google Wallet 管理票据和购买记录。Google 补上 Embedding Gemma 2 的技术报告,讲清如何把文本、图像、音频和视频映射进同一空间,以及模型如何做得更紧凑。DeepMind 展示 Anti-Gravity 机械臂插件,配合 Hydrogen,先在 Mujoco 里演练再把任务交给兼容的实体机械臂。ChatGPT 今天发帖展示 Ceos 插件,能把 CRM、会议笔记和跟进工具串起来。Zuno 今天补发 Visuals 示例,从歌曲进入 Create Visual 可以做 5 到 15 秒的片段,生成用的是单独的视觉积分。
Embedding Gemma 2 的多模态嵌入
Embedding Gemma 2 是 Google 推出的嵌入模型,能将文本、图像、音频和视频映射到同一向量空间,从而实现跨模态检索与相似度计算。技术报告重点介绍了模型如何保持紧凑性以适应边缘设备,以及多模态对齐的训练策略。这对于构建统一搜索、推荐或多模态 RAG 系统具有参考价值。
选型建议
两款模型的核心差异不在能不能做,而在做的成本与交付确定性。日常迭代、快速改代码、批量任务优先 Soul;复杂交付、多要素协同、长任务用 Astra。第三方测试已经暴露出一个关键提醒:同题对照时务必检查汇总口径和评测条件,否则跑分差异可能被方法论噪声放大。真正可靠的判断方式,是拿自己的真实任务分别跑一遍,再对比交付质量与单次成本。
相关推荐

小模型微调逆袭:2B/4B参数击败GPT-6 Luna
用Shopify商品分类任务实测:20亿和40亿参数的Qwen 3.5微调后准确率分别达69.8%和73%,超过GPT-6 Luna的68.2%。完整拆解数据准备、LoRA超参数、serverless微调与评估流程。

Beni跟拍摄像机器人上手:4K 60p HDR+智能避障
Beni 跟拍摄像机器人亮相 YouTube:4K 60p HDR 成像、17.9 英里/小时最高速度、智能避障可跨越 10 英寸台阶,支持并行追踪、宠物尾巴追踪与 Orbit 环绕运镜,配手表遥控器,重新定义自动跟拍体验。

Gemini 4 Krypton曝光:性能逼近Fable 5.2价格更低
谷歌Gemini 4 Krypton曝光,性能逼近Fable 5.2而成本更低;Claude Code新增主题定制与多线程项目协作;Anthropic官方指南揭示选型真相:Opus 5.5日常使用性价比高于Fable 5.2。