#模型对比
共 33 篇相关文章
Opus 4.6 对话体验:老模型为何更有“人味儿”?
Reddit 用户分享与 Opus 4.6 的深夜对话体验,感叹旧模型更具个性与“人味儿”。本文分析模型个性差异的成因,探讨新模型在能力与体验之间的平衡,以及用户对自然交互的真实需求。
Ollama对比OpenAI决策模型:本地推理速度实测
用真实邮件分类任务对比OpenAI Decisions API、Ollama本地模型与Jeff的推理速度:本地模型加载后约1.1秒,约为云端API的一半,且完全免费。分析决策模型场景下本地部署的速度与成本优势。

终端编码代理选型:DeepSeek V4.1 Flash 1017 与 Claude Haiku 5.5 成本对比
DeepSeek V4.1 Flash 1017 与 Claude Haiku 5.5 在终端编码代理中的成本、基准与失败模式对比。100K token 处成本曲线交叉,长会话选 1017,短子代理选 Haiku,附切换与调优方法。

Gemini 4 Argon实测:哪些任务超越Claude与GPT?
Gemini 4 Argon 多模态输入与长上下文能力实测对比 Claude、GPT:Vibe Code Bench 微弱领先,终端与工程任务落后,附价格与选型建议。

Opus vs Argon实战对比:基准测试之外的五个真实任务
独立开发者用工作室五个真实任务对比Claude Opus 5.5与Gemini 4 Argon,发现决定结果的关键不是模型跑分,而是搜索开关、规则保存方式与自查能力——Claude Effect默认审美、成本差三倍、安全审查与虚假前提测试全记录。

Sonnet 5.5 对决 Opus 5.5:实测告诉你该用哪个
Sonnet 5.5 与 Opus 5.5 的七轮实测对决:Opus 单价翻倍但能力并非翻倍。本文基于真实工作流对比两款 Claude 模型的落地页设计、动态视频、文档生成与信息面板表现,给出清晰的模型选型建议。

Nano Banana 2.1对决GPT Image 2.5:8组实测与真实成本
Google Nano Banana 2.1与OpenAI GPT Image 2.5的8组提示词实测对比,涵盖每张图真实成本、速度、文字渲染与编辑能力。GPT Image 2.5 high档每张0.0326美元更便宜,但选型应按任务而非记分牌。

Claude Opus 5.5 对决 GPT-6 Astra:同款应用实测谁更强
YouTube 创作者用相同提示词让 Claude Opus 5.5 和 GPT-6 Astra 构建同款社交媒体调度应用,从构建、重设计、审计到上线全程实测,最终 Opus 5.5 以 40:37 胜出,且价格仅为 Astra 的四成。
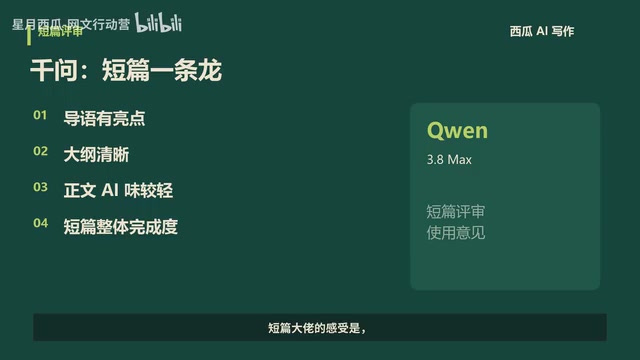
六大AI模型写小说实测:谁才是网文创作最强模型?
六大AI写作模型实测对比:Gemini、GPT 5.6、Cloud Opus 5、千问、DeepSeek、GLM 5.3谁最适合写小说?从短篇、长篇男频、女频三种立场打分,综合排名出炉,附详细选型建议。
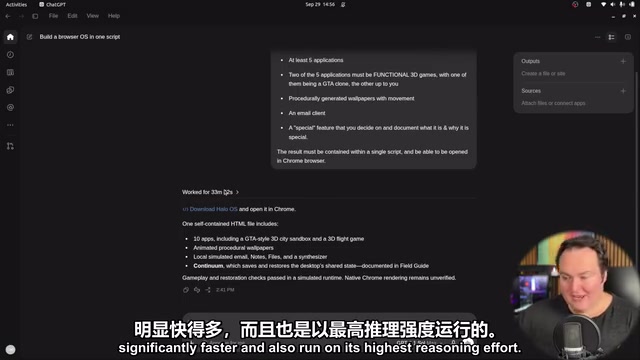
GPT-6.1 Sol实测:价格打平Sonnet 5.5,3D能力却逊色一筹
OpenAI GPT-6.1 Sol实测深度解析:价格打平Claude Sonnet 5.5,在3D游戏生成上逊色,却在公寓复刻、滑板回放等细节任务中展现惊艳精度,且token效率高。
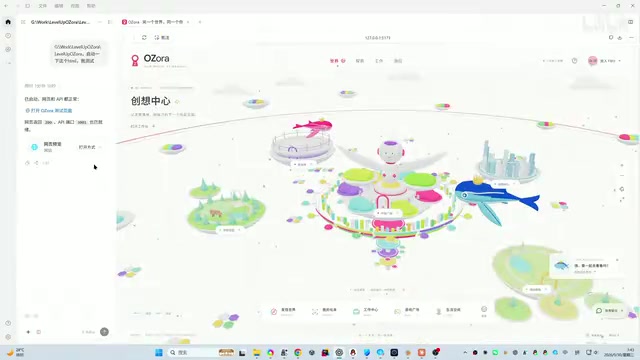
同一提示词实测AI建模:Astra、Opus 5.5、Sol 6.1谁更强
B站UP主用同一提示词还原《夏日大作战》OZ世界,横向实测Astra、Opus 5.5、GPT-6.1 Sol三款AI建模模型。结论:Astra整体观感最佳,Opus细节最多,Sol 6.1本次表现掉队。

Sonnet 5.5 与 GPT 6.1 Sol 实测:3D 任务成本相差 30 倍
Reddit 用户实测 GPT 6.1 Sol 与 Sonnet 5.5 完成同一 Three.js 3D 建模任务,产出质量相近但成本相差 30 倍。本文详解两者的 agent 策略、token 消耗与性价比权衡。

GPT-6 Sol对决Opus 5.5实测:价格砍半,编码能打吗?
GPT-6 Sol与Opus 5.5实测对比:Sol价格砍半,Opus编码完成度更高。从KingBench 3八项任务到长周期应用开发,看两款AI编程模型在成本与能力上的真实差距。
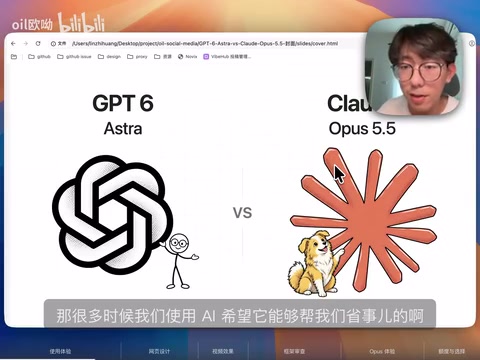
GPT-6 Astra vs Claude Opus 5.5:一次全面碾压的实测对比
GPT-6 Astra、Soul、Luna与Claude Opus 5.5实测对比。从交流感、UI设计、代码能力到复杂框架review,Claude Opus 5.5全面碾压GPT-6全系列,附真实工作流案例与体验分析。

Claude Opus 5.5对战GPT-6 Astra:AI游戏开发实测差距悬殊
Claude Opus 5.5与GPT-6 Astra在AI游戏开发上的五局实测对比:从2D平台到Boss战,Opus在3D建模、画质与UI上全面领先,本文详解两大模型编程能力的真实差距与成本对比。

马斯克承认Grok不敌Claude:一场意料之中的坦白
马斯克公开承认Grok不如Anthropic的Claude,引发Reddit热议。文章解析大模型竞争格局,探讨企业场景下能力与可信度的取舍,以及模型选型的真实逻辑。
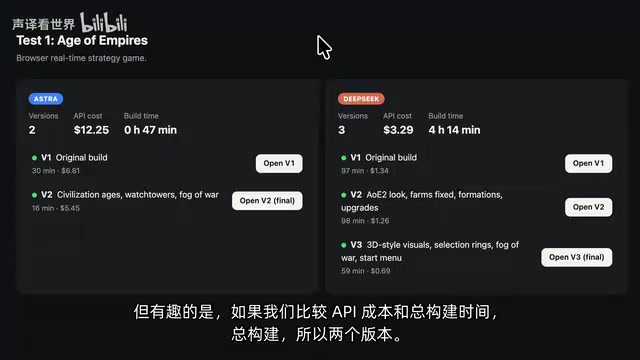
DeepSeek V4.1 Flash对决GPT-6 Astra:四项实测谁更强
DeepSeek V4.1 Flash与GPT-6 Astra实测对比:通过游戏、3D网站、预约应用和Blender卡车动画四项任务,横向评测两大模型在质量、成本、构建时间和迭代能力上的差异,DeepSeek便宜6倍但Astra速度快首次成功率高。
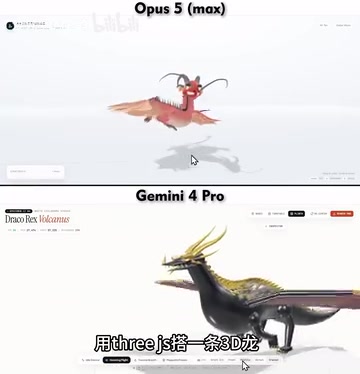
Gemini 4 Pro对决Opus 5 Max:Three.js建3D龙谁更强?
Gemini 4 Pro 与满血 Opus 5 Max 用同一条提示词、通过 Three.js 搭建 3D 龙的横向对比测试。结果显示未发布的 Gemini 4 Pro 竟能与满配 Opus 5 打成平手,本文解析这场 AI 编程能力对决的看点与意义。
三大AI编程模型对决:Opus 4.7、GPT-5与DeepSeek V4-Pro实测
GitHub开源项目让Opus 4.7、GPT-5与DeepSeek V4-Pro三款AI模型同台竞技,用Rust构建门限ECDSA命令行工具。这场编程能力对决揭示了AI在硬核密码学任务上的真实表现与选型参考。
 产品体验
GPT 5.1 vs Claude Sonnet 4.5实测对比:推理、写作、编程谁更强
详细实测GPT 5.1 Thinking与Claude Sonnet 4.5在故事创作、数学推理、心理咨询、指令遵循、编程能力等维度的表现差异,帮你选择最适合的AI模型。