GPT-6 Astra全面实测:从光线追踪到自动通关宝可梦
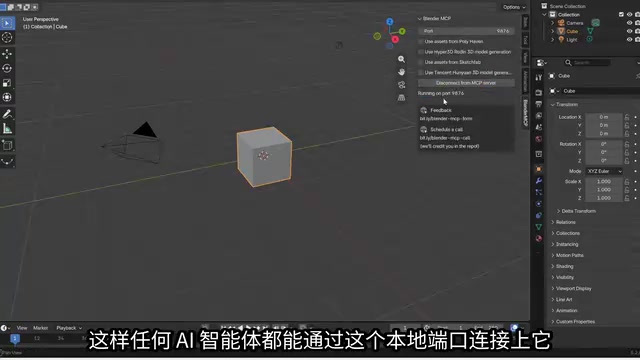
GPT-6 Astra以双智能体循环展现强大Agent能力,但细粒度视觉任务仍有明显盲区。
本文梳理了AI Search频道对GPT-6 Astra的高强度实测。该模型采用「评审+构建」双智能体循环方法论,从零手写光追物理模拟、耗时4小时做出可玩的虚幻引擎3D游戏,并通过直接操控浏览器实现逐笔临摹绘画、逐帧制作精灵动画乃至在线钢琴现场演奏。基准测试层面,它在ARC-AGI-3、Frontier Math、多项Agent编程与电脑操作榜单均排第一,并成为首个通关《传送门》的通用AI。然而在细粒度视觉搜索(找青蛙)和医疗影像识别(脑肿瘤)上表现欠佳,六张脑扫描图仅答对一题。评测数据均来自单一创作者与官方自报基准,独立验证有限,结论宜谨慎参考。
AI Search频道对号称最新一代旗舰模型GPT-6 Astra进行了一轮高强度实测。从物理模拟、游戏开发到电脑操作、音乐创作,这个模型展示出的智能体(Agent)能力确实令人印象深刻——但也在一些经典测试中翻了车。本文梳理这次评测的核心发现,并客观呈现它的强项与短板。
智能体式编程:从零写出光追物理模拟
评测的第一个测试直击模型对物理与光线追踪的理解。UP主给出的提示词要求它模拟一颗子弹击穿水气球的过程——气球爆开、水喷涌形变、最终落地,同时要支持任意角度冻结查看,并提供子弹速度、气球大小、光照、重力等参数滑块。关键约束是:不允许使用three.js或任何外部网页库,必须完全从零手写。
这里最值得关注的不是模型本身,而是一个可复用的提示词技巧:引入独立的"评审智能体"。每次迭代后,评审智能体会从不同角度截图并对真实感和物理准确度打分(0到10分),只有拿到8分以上才算通过,否则会生成一份按优先级排序的问题清单让构建智能体继续修改,最多循环若干轮。
实际运行了32分钟。第一轮评审只给了4.7分,第二轮6分,第三轮6.5分——始终没到8分,最终因触及轮数上限而停止。尽管评分未达标,成品已经能真实地展示子弹穿透水团、水花喷射落地的效果,并支持调节光照强度与方向。这套"评审-构建"双智能体循环,是整期评测反复使用的核心方法论。
4小时做出一款虚幻引擎3D游戏
更硬的挑战是游戏开发。提示词要求它在虚幻引擎中制作一款第三人称程序化3D游戏,角色来自SketchFab模型,需要自行到Mixamo上寻找并映射走路、奔跑、跳跃等动画,场景是程序化生成的中国古代皇宫,资产通过Blender MCP生成。
模型的完整工作链条相当复杂:用Playwright扩展登录下载资源,通过MCP协议连接Blender生成资产,再在虚幻引擎中程序化渲染,最后用评审智能体从多个视角截图打分(3A品质标准设为8.5分)。首轮耗时1小时26分,评审仅给5.8分、6.3分,仍未达标。经过后续针对角色动画、镜头特效、跳跃机制的多轮修改,累计约4小时后,成品变成了一款可实际操控、能连续跳跃跨越屋顶、还带收集图标机制的游戏。虽然仍有建筑楼层脱节、灯笼错位等瑕疵,但整体完成度确实可观。
光线追踪(Ray Tracing)是一种通过模拟光子从光源出发、经过反射折射最终到达摄像机的过程来渲染图像的技术。传统实时渲染依赖光栅化走捷径,而光追则逐像素计算真实光路,能还原软阴影、焦散、次表面散射等物理现象,计算量极大。要求「不使用任何外部库」意味着模型必须从向量数学、射线-球体相交检测、Lambertian漫反射模型等底层算法手写起,这对模型的数学推理与代码合成能力是双重考验。评审智能体自动打分这一设计,本质上是把人类反馈环路(RLHF中的人工审核)替换成了另一个语言模型,让迭代可以在无人监督的情况下持续进行——这种「LLM-as-Judge」的范式近年在自动化评估领域越来越常见,但也存在评审模型本身判断偏差的风险。
电脑操作能力:一笔一笔画画、弹钢琴
GPT-6 Astra官方主打的最大卖点是"电脑操作"能力——它可以直接控制浏览器和桌面应用,点击、拖拽、填表。评测设计了几个递进难度的任务。
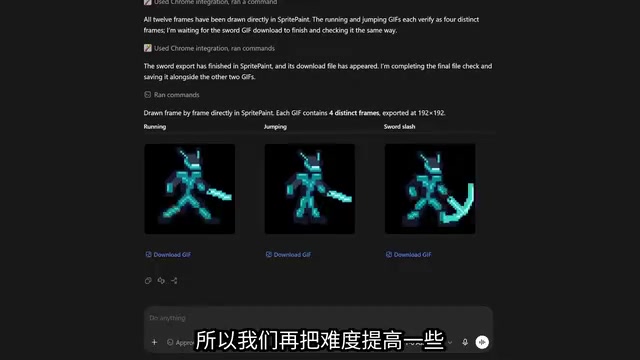
最基础的是让它打开Photopea(在线版Photoshop),新建画布并临摹一幅画。它没有用代码作弊,而是真的用光标一笔一笔画出来,约20分钟完成。进阶版是让它在精灵动画网站上,为参考角色逐帧绘制奔跑、跳跃、挥剑、劈砍动作并导出GIF,耗时约40分钟。
最让评测者震撼的是钢琴测试:进入在线虚拟钢琴,先创作一段肖邦风格的快节奏独奏曲,再通过依次精准按下琴键"现场演奏"出来。难点在于这里存在时间维度——按键时机必须准确。模型先花几分钟摸索录制方式,最终大约7分钟就弹出了一段听起来相当正经、节奏很快的古典独奏。这种在真实界面上完成带时序要求的操作,确实体现了智能体操控的成熟度。
音乐、视频与3D重建
评测还测试了内容创作的广度。让它在Waveform中制作一首Europop EDM,首版偏基础,经反馈迭代后成品明显提升。让它作为"导演"通过Higgsfield MCP调度视频生成模型做一支30秒产品广告,20分钟出片,效果被认为优于同提示词下的竞品结果。此外还有一个亮点任务:把日本某豪华民宿房源的所有照片喂给它,用Blender MCP重建整栋建筑与室内,并编排相机路径做虚拟导览。1小时12分后,它在场景中生成了数千个元素,虽非100%还原,但泳池、沙发、客厅布局都相当接近原场景。
模型对电脑界面的直接操控依赖于「计算机使用(Computer Use)」接口,通常通过截图感知当前屏幕状态,再输出鼠标坐标与键盘事件来执行动作,形成「感知-规划-执行」的循环。与API调用或代码生成不同,这种方式不需要目标应用提供任何结构化接口,理论上可操控任何人类能用的软件。钢琴测试之所以特别有说服力,是因为它引入了时间维度——模型不仅要知道按哪个键,还要按照节拍在正确的时刻触发点击事件,这要求模型在执行层面具备一定的时序规划能力,而非仅仅完成静态的界面交互。MCP(Model Context Protocol)是Anthropic提出的开放协议,允许AI模型通过标准化接口连接Blender、Higgsfield等外部工具,类似于给模型装上可插拔的「工具手臂」。
翻车环节:找青蛙与识别脑肿瘤
评测并没有回避模型的短板。经典的"找青蛙"测试中,模型运行近7分钟仍未能圈出隐藏的青蛙,甚至误判为响尾蛇;换另一张图重试多次同样失败。这说明在细粒度视觉搜索上,它依然存在明显盲区。
在脑肿瘤识别测试中,六张不同类型脑部扫描图,模型仅答对左上角一题(脑膜瘤),其余五题全错。评测者也如实指出,这一分(六分之一)虽然是被测模型里的"最高分",但对医疗场景而言远不可靠。这类如实呈现失败案例的做法,让整期评测更具参考价值。
基准测试与定型成就
从官方自报数据看,GPT-6 Astra在多个榜单表现突出:
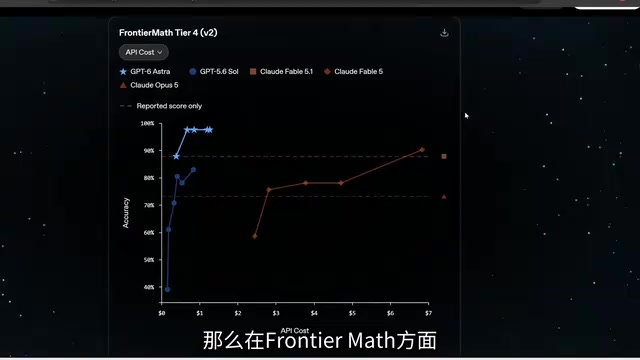
- Frontier Math约98%,几乎刷满;**Frontier Math(埃尔德什基准)**是唯一得分高于0%的模型
- Terminal Bench 4(终端智能体编程)、OS World、Agents Last Exam、Automation Bench等智能体与电脑操作类榜单均排第一,官方称其为"世界最强电脑操作模型"
- ARC-AGI-3得分超过60%(其他前沿模型不足10%),加外部框架可接近100%
- iBench(视觉能力)拿到95%,其他模型不到50%;3D重建、音乐转谱等榜单也领先明显
定型成就方面同样抢眼:它是首个通关《传送门》(Portal)的通用AI,需要三维空间推理和精准操作;仅用18小时12分通关《宝可梦火红》,远快于其他模型。
不过评测也保持了客观——在"人工智能分析指数"上它落后于Claude系列排第二,在LiveBench上甚至排到第三,低于部分Claude模型。它的真正优势在性价比:任务成本远低于昂贵的Claude模型,且幻觉率明显低于Claude Opus 5和上一代GPT-5.6。
ARC-AGI(抽象与推理语料库)由François Chollet设计,旨在测试无法通过死记硬背解决的流体智能:每道题给出少量视觉规律示例,要求模型归纳出规则并预测新输出。第一代ARC曾被认为是人类轻松过关但AI难以突破的门槛,第三代ARC-AGI-3进一步提升了规则复杂度与分布外难度,使大多数前沿模型得分不足10%。Frontier Math则由数学家团队构建,包含需要数小时才能验证的研究级难题,埃尔德什(Erdős)基准是其中专为极端难度设计的子集,以匈牙利数学家保罗·埃尔德什命名,象征着接近人类数学研究前沿的挑战。这两项基准的高分,相比传统的MMLU、GSM8K更能反映模型在开放式推理上的真实天花板。
使用方式与总结
据评测,该模型已面向所有ChatGPT付费计划(Plus和Pro)推出。在线聊天界面中需通过"Work"标签才能使用,也可在桌面应用(原Codex)中调用。UP主使用的是5X Pro计划,一个约一小时的智能体编码任务通常消耗每周额度的5%到10%。
综合这轮评测,GPT-6 Astra在智能体式编程、电脑操作、长程规划和数学推理上展现了显著跃升,多智能体自评循环的工作流也颇具启发。但需要提醒的是,本文数据均来自单一UP主的实测演示,其中包含大量官方自报基准和主观判断,且部分结论(如产品命名、发布状态)无法从独立来源交叉验证,读者宜谨慎看待,等待更多客观评测佐证。
相关推荐
GPT-6 Sol与Luna实测:建模、游戏、写作全面对比
B站UP主实测GPT-6 Sol与Luna Max在3D建模、小游戏、写作三大场景的表现,并与Opus 5.5横向对比。Sol降价带来Codex额度利好,但创意生成能力仍不及Opus 5.5,Luna小模型也有清明上河图贴图惊喜。
GPT-6 Soar对比GPT-5.6 Soar实测:更快更省的真实差距
GPT-6 Soar与GPT-5.6 Soar实测对比:从SVG绘图、代码理解到3D场景生成,记录耗时、额度消耗与完成质量。简单任务难分高下,复杂任务中GPT-6 Soar在速度、成本和方位准确性上明显占优。
GPT-6 Luna实测:性价比最高的干活模型
GPT-6 Luna实测评测:价格比GPT-5.6 Luna再降50%以上,5亿Token只扣3%额度。本文分享Luna的实际干活能力、Skill调用短板、执行者定位以及上下文窗口配置技巧,帮你找到性价比最高的AI模型使用方式。