GPT-6 Astra实测:Plus用户的真实额度能干多少活?
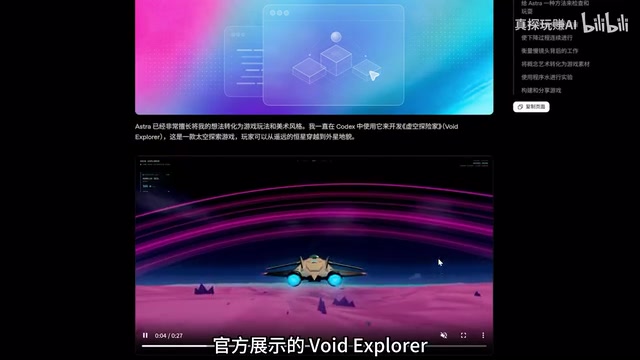
GPT-6 Astra实测:官方演示需多轮迭代,Plus用户宜将其留给最难的跨工具高返工成本任务。
OpenAI于2026年9月发布的GPT-6 Astra,是首个被放入持续执行环境、能操控浏览器与专业软件完成多步骤任务的主流模型。官方展示的3D建模与游戏制作均经历多轮提示和分阶段迭代,并非一句话零人工生成。B站UP主用草图让Astra在ChatGPT Work里生成AI热点雷达网页,五项功能验收全部通过,首次任务耗费5小时额度约6%,追加改动再耗约10%。跑分显示电脑操作成功率提升至72.6%,耗时减少约47%,但API成本结论不等于Plus额度更省。结论是:普通任务交给低成本模型,只将最困难、返工代价最高的跨工具任务交给Astra,即"82分配"策略。
OpenAI在2026年9月发布的GPT-6 Astra,被官方定位为目前最智能、对齐程度最高的模型,并开始向Plus、Pro、Business和Enterprise用户陆续开放。官方演示里,它能在Blender建模、制作可运行的游戏、操作浏览器完成多步骤工作,看起来无所不能。但B站UP主的这次实测提出了一个更现实的问题:Plus用户每个月付的钱,究竟能让Astra替自己干几次真活?
Astra是大脑,工具才是它的手
很多人容易把Astra理解成又一次跑分更高、回答更准的模型升级。但这次真正值得普通人关注的,是它被放进了一套可以持续执行工作的环境——它不只生成一句答案,还能使用浏览器、代码、文件和专业工具,把一个目标拆成很多步,最终交付一个可用的结果。
不过这里必须分清两件事:Astra更像是大脑,而ChatGPT Work、浏览器、插件以及你授予的权限才是它的手。看到Astra模型不代表它自动拥有所有本地软件和账号权限,看到Work入口也不代表每个任务都能不经确认一路执行到底。这是理解Astra实际能力的关键前提。
ChatGPT Work(有时也称为ChatGPT Agent或Operator模式)是OpenAI为让模型真正"动手干活"而构建的执行层。与普通对话不同,它允许模型在一个持久会话中操控浏览器标签页、运行代码沙箱、读写文件,并在多个步骤之间保留上下文和中间结果。用户需要主动授予对应权限,模型才能访问特定资源,这也是文中测试时弹出浏览器权限请求的原因。这种"大脑+工具"架构被业内称为Agentic AI(代理式AI)——模型不仅能生成内容,还能感知外部环境、制定计划、调用工具并根据反馈修正行为,理论上可以完成传统聊天机器人无法胜任的多步骤、跨软件任务。理解这一架构,是判断Astra实际能干什么、不能干什么的基础。
官方3D演示背后被剪掉的细节
传播最广的3D建模案例中,Astra可以根据参考图在Blender里搭建房屋,再把场景带进Unreal Engine做成可以行走的环境。这确实很强,因为它跨越了建模、材质、灯光、检查和修改等多个步骤。
但翻看OpenAI的完整案例会发现一个容易被短视频剪掉的细节:最初的一条提示词确实生成了可编辑的Blender场景,可后面完整的房屋、森林、家具和Unreal场景,是经过多轮提示和分阶段迭代完成的,部分树木还使用了外部素材。
游戏案例也是如此。官方展示的Void Explorer拥有2048个信息和上万个程序化生成的星球,视觉效果非常完整,但制作过程包含反复调整提示词、修改渲染架构、加入图像生成、制作测试界面并通过自动化工具测试等多个阶段。HoloFlux和SunWake两个案例同样经历了战斗、移动、经验系统、水体、浮力、天气等多阶段迭代。
结论并非官方造假,而是我们需要把"能做到"和"一句话、几分钟、零人工做到"区分开。Astra最大的进步是能在复杂软件里持续工作、自查并修改,但它并没有消灭审美判断、需求确认和最终验收。对普通创作者来说,它更像一个执行力很强的制作搭档,而不是说一句话就能实现所有愿望的许愿机。
跑分说明什么:三个普通人能懂的结论
关于跑分,只需记住三个结论。
第一,电脑操作成功率更高。官方Oswald测试中Astra成绩为72.6%,上一代Cell为65.7%。这不代表现实任务都有七成成功率,只说明在同一套受控测试里它更可靠。
第二,长流程办公和专业软件提升明显。Automation Bench从Cell的8.1提高到41.4,CAD任务从83.3提高到95.9。
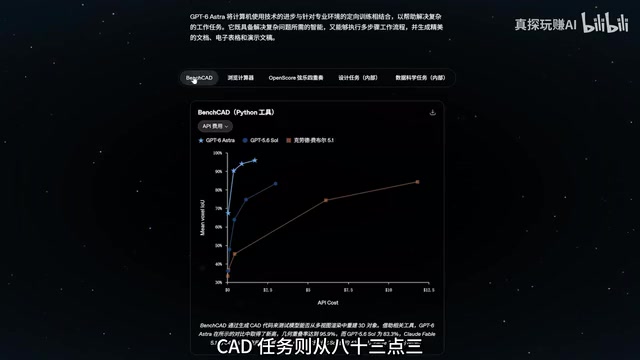
第三,速度和成本不能只看单价。OpenAI模拟结果显示,Astra完成电脑任务的时间可减少约47%,部分任务用更少输出内容完成工作。这意味着即便API单价更高,某些任务总成本也可能更低。但要注意,这是官方评测里的API成本结论,不等于你的Plus额度一定更省。
文中提到的Oswald测试和Automation Bench均属于"Agent基准测试",专门用来衡量AI模型在真实计算机环境中自主完成任务的能力,而非传统的知识问答或推理题。Oswald模拟操作系统级任务,例如管理文件、使用系统设置和原生应用;Automation Bench则侧重于RPA(机器人流程自动化)场景,包括填表、数据录入和软件操作等重复性工作;CAD任务测试则针对专业设计软件的操控精度。这类评测的分数提升对企业用户意义更直接,因为许多商业流程的核心瓶颈正是"人工在软件之间反复切换"。对个人用户而言,这些数字更应被理解为趋势参考,而非日常任务的成功率保证。
真实实测:一张草图做一个AI热点雷达
UP主没有复刻官方最炫的3D大场面,而是给Astra一张手画草图,让它在ChatGPT Work里把"AI热点雷达"做成一个能搜索、筛选、排序、适配手机的真实网页。测试前记录额度:5小时额度剩余79%,每周额度剩余88%。
任务使用Astra中等推理(不开最高),从全新Work对话开始,避免长上下文影响额度。UP主只给出最终目标和验收标准,不在旁边一步步指导写代码。测试过程中Astra弹出一次浏览器权限请求,UP主选择"仅在本次使用中允许",避免权限给得太高。
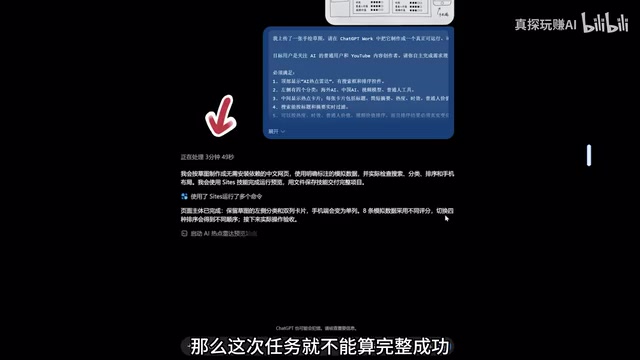
第一版页面直接交付,没有追问实现细节。随后UP主像普通用户一样逐项验收:搜索无关卡片消失、切换四个分类内容真实变化、按四种维度排序内容跟着切换、手机宽度下无溢出且按钮可点、刷新后核心功能仍在——五项检测全部通过,是一个真正的"活网页"。
这次网页制作后,5小时额度剩73%,月额度剩81%,消耗尚可接受。随后UP主追加需求:增加"适合普通人"开关,只显示普通人价值≥四星且不要求编程基础的热点,同时不破坏原有功能。这一步测试的是它能否理解已存在的项目、只改必要部分。结果生成成功,但因数据单一,切换后效果不明显,这一轮耗时十多分钟,额外消耗5小时额度的10%。
普通人该不该事事都用Astra
答案是否定的。搜索热点、总结、修改标题、撰写提纲这类任务,Gemini Pro通常就够了;简单重复、对价格敏感的代码任务可考虑成本更低的工具;长时间编码和agent工作流也可对比Claude Sonnet。这些产品并非完全等价的一键平替。
Astra更适合留给三类工作:任务横跨网页、文件和多个软件;任务失败一次会带来很高的人工返工成本;项目持续时间很长,需要模型一直记住目标并自行验证结果。
UP主推荐一种"82分配":80%的整理和草稿交给速度更快、成本更低的模型,最困难的20%——复杂执行、最后排错、跨工具交付——再让Astra上场。最强模型的价值不是承包所有琐事,而是打通最容易卡住你的环节。
文中与Astra对比提到的Claude Sonnet和Gemini Pro,代表了当前主流大模型"按场景分级使用"的生态格局。Claude Sonnet(Anthropic出品)以长上下文处理和代码生成的性价比著称,在持续编码和大文档分析场景中常被开发者优先考虑;Gemini Pro(Google出品)深度整合Google Search和Workspace,在实时信息检索与文档摘要方面具有天然优势。这种多模型并用的策略,本质上是把"模型能力"当作可按需调用的计算资源来管理,而不是非此即彼地押注单一产品。对普通用户来说,最实用的思路是按"任务复杂度"和"容错成本"两个维度分流,而不是默认所有任务都交给最强模型处理。
结论:从回答问题走向接手一段工作
这次实测的真正启示,不是"AI取代了谁",而是AI正在从回答问题走向接手一段可以验收的工作。Astra给Plus用户带来的升级,不是聊天框里更漂亮的答案,而是减少了大量"复制出去、打开软件、再回来追问"的往返操作。
但额度变化也提醒我们:Plus更像是让普通人偶尔调用一位高级执行者,而不是无限雇佣一名全天候员工。从官方演示到普通人的稳定生产力,中间还隔着工具、权限、运行环境和人工验收这四道门槛。Plus用户可以期待这次升级,但暂时别把它当成一名可以完全无人指挥的员工——把它用在最困难、返工成本最高的任务上,它才最值。
相关推荐
DeepSeek训练2万亿参数模型,剑指8万亿超大模型
据社交媒体爆料,DeepSeek正训练2万亿参数模型并计划打造8万亿参数超大模型。本文梳理其Flash、Pro等现有模型参数梯队,解析MoE架构下超大模型的技术路径与行业影响。
16GB显存是多数人的天花板:本地大模型的现实与未来
为什么16GB甚至12GB显存才是多数人跑本地大模型的现实上限?本文解析小显存下的AI能力现状——量化模型让agentic编程成为可能,同时探讨世界知识的硬性限制与超越Transformer架构的未来方向。
macOS 27 本地 AI 模型太占空间?分析与规避思路
macOS 27 本地 AI 模型占用大量存储空间,本文分析设备端 AI 占用磁盘的原因、常见规避下载的变通思路及其风险,并给出更稳妥的存储管理建议。