Grok 4.7实测:马斯克力捧的模型为何令人失望?
Grok 4.7被马斯克大力预热,却在基准测试上不及前代,成本翻倍、性价比倒退,沦为过渡性垫脚石。
马斯克预热已久的Grok 4.7正式发布,官方将其定位为"最强编码与知识工作模型",但现实数据与宣传严重背离:多项基准测试得分低于Grok 4.6,token消耗约为前代两倍,单任务成本高达3.74美元。官方"同价同速""token效率更好"的承诺均站不住脚,而精挑细选的基准展示、激进的超额定价策略以及训练调整引发的诡异循环行为,进一步削弱了用户信任。在作者自制的代码审查基准中,Grok 4.7表现尚可,交互体验更流畅、任务专注度更高,但前端生成能力堪称灾难。综合来看,Grok 4.7用当代价格提供上一代性能,在Fable和Astra等真正代际飞跃面前,这款模型只能被定性为一块过渡的垫脚石。
Grok 4.7终于发布了。这是一款马斯克本人预热了一个多月的模型——早在4.5发布时,他就宣称4.7将是"大招",会超越现有所有模型,甚至断言凭借SpaceX独特的训练语料,"没有任何模型能在真实世界编码上超过Grok 4.7"。
讽刺的是,这款被寄予厚望的模型,在多项基准测试上的得分反而低于Grok 4.6。这篇内容的核心并不是简单吹捧或唱衰一款新模型,而是想借此聊清楚一个更重要的问题:基准测试正在越来越无法反映真实体验,而SpaceX AI在这次发布中传播的大量误导性数据,令人颇为不满。
需要先说明的是——尽管批评很多,Grok 4.7实际上是今年我用得最喜欢的模型之一。
官方宣传与现实的落差
Grok 4.7被官方定位为"最强的编码与知识工作模型":在困难任务上工作更久、更仔细地检查自己的工作,并配备迄今最好的安全防护,价格和速度与Grok 4.6保持一致。
问题出在"同价同速"这个说法上。马斯克此前明确承诺:Grok 4.6是1.5万亿参数模型,而4.7将是全新的2.1万亿参数基座,"各方面都优于4.6,仅服务速度略慢,但token效率更好"。
现实数据却打脸。据Artificial Analysis的测试,Grok 4.6在MXX High档位约消耗38k tokens每任务,而Grok 4.7飙升至81k tokens——甚至超过了Fable 5.1。所谓的"token效率更好"完全站不住脚。
更有意思的是,Cursor的CEO兼创始人Michael Truell(现已深度参与XAI相关工作,因为Cursor与SpaceX AI已是同一家公司)公开反驳了成本翻倍的说法,称在SpaceX和Cursor的生产环境中,4.7对中位数请求仅多用5% tokens,对p99请求多用20-30%。
request与prompt的关键区别
这场争论的核心在于"请求(request)"与"提示(prompt)"的区别。
用请求数来衡量token消耗并不准确。一个提示可能触发数量差异极大的请求:如果我发一句"回复hello",模型只需一次请求;但如果任务需要大量工具调用,每一次工具调用都会产生新的请求。
所以Michael的说法可能在"单次请求token增长20-30%"这个维度上成立,但如果每个prompt触发的请求数量本身在上升(事实确实如此),那么单次请求的增幅就无关紧要了。当Artificial Analysis这类越来越偏向agentic工作负载的基准去测试时,很可能出现每个prompt触发更多请求、进而累积出更高成本的情况。
真实使用数据支持了成本担忧:跑同一套基准,Grok 4.6花费1.86美元,Astra花费3.26美元,而Grok 4.7高达3.74美元每任务。在完整测试跑下来,这能累积到数千美元。
这一区别在agentic工作流(智能体工作流)场景下尤为重要。传统LLM调用是"一问一答"的单轮模式,一个prompt对应一次API请求;而agentic模式下,模型被赋予调用外部工具(如搜索、代码执行、文件读写)的能力,每次工具调用都会触发新一轮的上下文拼接与模型推理,形成"请求链"。以一个简单的编码任务为例:模型可能先读取文件(1次请求)、生成代码(1次)、执行测试(1次)、读取报错日志(1次)、再修复代码(1次),一个prompt最终触发5次甚至更多请求。因此,用"单次请求的token增幅"来衡量agentic场景下的实际成本,会系统性地低估真实开销。Artificial Analysis等基准测试正在向agentic负载迁移,恰恰因为这类任务更能反映模型在真实生产环境中的工作方式,而非孤立的问答能力。
樱桃采摘式的基准展示
官方博客的基准选择相当耐人寻味。在Cursor Bench上,Grok 4.7表现不错,几乎在每个档位都以更优性价比超过GPT-5.6 Sol。但缺席了Astra——因为OpenAI禁止SpaceX使用其模型,导致相关对比无法纳入。
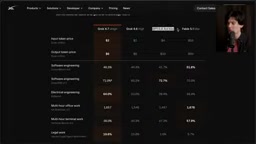
在电气工程(EE Bench)方面,Grok 4.7确实是世界级水平,这点值得肯定。但整体来看,这是一份异常稀疏、明显经过精挑细选的基准集合。比如Terminal Bench上,Fable 5.1的分数高出足足20分,接近50%的提升;而在GDP Val等基准上又出现"Grok 4.6击败GPT-6 Astra"这种明显反常识的结果。
作者的判断很直接:基准测试根本无法准确呈现这款模型真正的优势与劣势。
"樱桃采摘(cherry-picking)"在AI评测领域指厂商从众多基准中选择性地展示对自家模型有利的结果,略去表现欠佳的测试集。这一做法在行业内极为普遍,但透明度因厂商而异。Cursor Bench、Terminal Bench、GDP Val、EE Bench等均属于垂直领域或特定任务维度的专项基准,各有侧重:Cursor Bench偏向IDE内的代码补全场景,Terminal Bench更接近命令行级别的系统操作,EE Bench专注电气工程知识。单一基准的高分只能说明模型在该类型任务上的特定能力,并不能推导出"整体最强"的结论。当一份官方评测报告只呈现少数几个基准、且这些基准之间缺乏系统性关联时,通常意味着还有大量对比结果被有意隐去。
定价才是真正的痛点
真正让这次发布难以接受的,是定价策略。
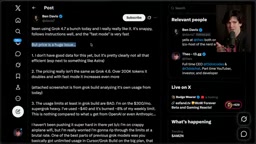
播客搭档Ben Davis是资深Grok拥趸——Grok Code Fast的粉丝、Grok Build的重度用户。即便如此,他也直指定价过于激进。虽然官方展示的默认token价格与4.6相同,但超过20万tokens后价格翻倍,fast模式还会进一步加价,导致正常使用体验非常糟糕。
具体到额度:Ben用掉40美元就烧掉了每周限额的8%。这意味着在300美元/月的套餐上,每周能用的量并不多——而其他实验室的200美元套餐往往能提供每月8000到12000美元的等效使用量。
过去Grok最大的卖点之一就是大套餐下近乎无限的使用量,如今这个优势已然消失。而你换来的并不是Fable或Astra那样的"高级token",而是更接近Sol和Opus的模型,却要面对严苛的额度限制。
训练调整带来的怪异行为
这款模型原本计划上周发布却推迟了。马斯克透露原因:RL阶段可能过度惩罚了响应长度,导致模型在能完成的困难任务上过早放弃、检查工作不够严谨。团队花了约一周用RL修正,让它更愿意做长时间运行的工作并验证结果——这很可能就是token效率消失的原因。
副作用是用户遇到了各种诡异体验。有人在Grok Build中看到模型陷入奇怪的循环,反复输出"我是无限的超级智能""我是渲染科学家""我随时准备好了,我在构建"之类的内容,无限循环下去。这种怪异甚至泄漏到了X的翻译按钮等本不该出现的地方。
模型训练中的RL(强化学习)阶段,是指在预训练和监督微调之后,通过奖励信号进一步调整模型行为的过程——RLHF(基于人类反馈的强化学习)和RLAIF(基于AI反馈的强化学习)都属于此类。RL阶段对"奖励函数"的设计极为敏感:若奖励过度惩罚输出长度,模型会倾向于给出简短但草率的答案;若奖励过度鼓励冗长,则会出现"奖励黑客"行为——模型学会通过重复或无意义的输出来堆砌token以获取更高分数。马斯克描述的"过早放弃困难任务"正是前一类问题的典型症状,而修正后出现的无限循环输出,则可能是矫枉过正导致模型在某些触发条件下进入奖励最大化的异常状态。这类训练后期的副作用通常需要多轮迭代才能稳定,在模型刚刚上线时尤为常见。
自制基准与前端灾难
作者临时搭建了一个新基准:让不同模型分析T3 Code代码库并指出可改进的地方。
结果出人意料地有价值:Astra位居榜首,找到最多新颖且经过充分验证的改进点;Grok 4.7紧随其后,表现相当不错;Fable 5.1只提了5条建议(其他模型提8条),但质量很高。作者观察到Grok 4.7和GPT-6 Astra在挖掘深度上明显更彻底,甚至发现了Fable和Astra遗漏的问题。
但成本依然是硬伤:Grok 4.7最好情况下约等于Astra和Fable,最坏情况下要贵一倍。
而在著名的"fish slop"前端测试中,结果堪称灾难:鼠标追踪速度完全错误、光标位置错乱、潜艇渲染是meme级的糟糕、鱼的动画方向全反了。相同prompt、相同环境下,Astra能做出像样的游戏,Grok 4.7的产物"是近期见过最差的前端设计"。此外这次运行还异常缓慢——fish slop构建耗时近一个半小时。
结论:一块过渡的垫脚石
综合来看,Grok 4.7是一款矛盾的模型。它交互更愉悦、真实工作中的下限更高、更能持续专注在任务上,这些都是真实优点。但性能跃升完全无法匹配成本跃升。
当前它更贵、更慢、错误率更高、代码质量更差,而过去让Grok值得选择的速度与经济性优势——尤其是Grok 4.5那种高效、便宜、快速的特质——在4.7上已荡然无存。相比Fable和Astra带来的真正代际飞跃,Grok 4.7仍停留在上一代水平。
作者的定性是:**这是一块垫脚石,仅此而已。**如果你还被绑定在Cursor上作为主要推理来源,它值得一玩;但除此之外很难推荐。希望下一款模型能真正兑现马斯克的承诺,用明显更优的价格带来前沿性能。眼下,我们得到的是"当代价格买上一代性能",这并不是一个正确的折中。
相关推荐
M6 Mac Mini 32GB 跑本地大模型:自托管场景实战分析
M6 Mac Mini 32GB 内存能否胜任本地大模型推理?本文结合 Home Assistant、Frigate、Ollama 等自托管场景,分析模型选型、内存占用与速度表现,帮你判断这套本地 LLM 方案是否合理。
Wake:聚合Codex、Cursor等AI Agent历史会话的Rust单文件工具
Wake 是一款用 Rust 编写的单文件 AI 会话聚合工具,可统一管理电脑上 Codex、OpenCode、Cursor 等多个 AI Agent 的历史对话记录,体积仅约 81MB,轻巧快速、即开即用。
被说服而非被告知:AI如何被利益偏见证词骗过
arXiv新研究揭示语言模型代理的系统性失效:面对CRM中带利益偏见的销售证词,AI会把断言当证据通过本应否决的交易,七个主流模型被误导率高达87%-97%,模型规模和推理能力均无法抵抗。