M6 Mac Mini 32GB 跑本地大模型:自托管场景实战分析
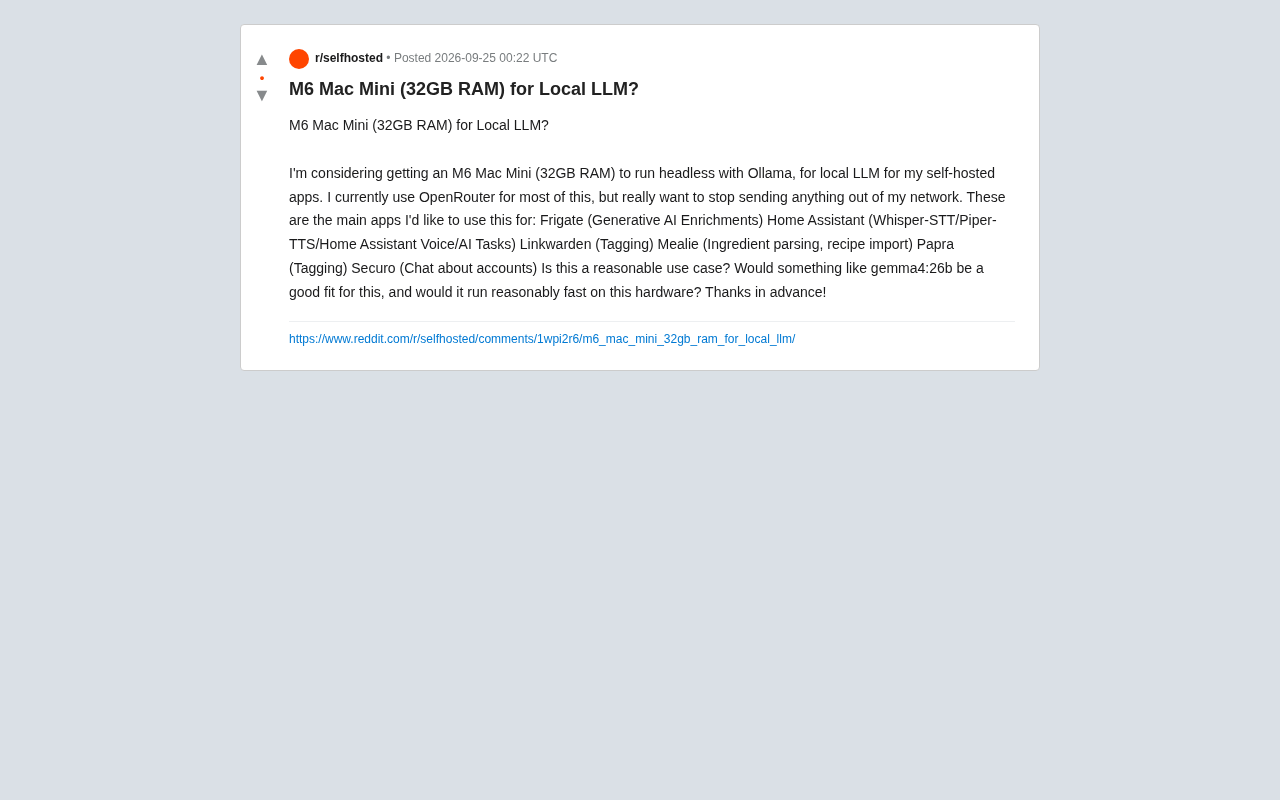
M6 Mac Mini(32GB)可满足家庭自托管AI隐私需求,但应以9B-14B模型为主力而非追求26B。
一位自托管爱好者计划用 M6 Mac Mini(32GB)无头运行 Ollama,替代 OpenRouter 以实现完全本地化的 AI 推理。其使用场景涵盖 Frigate 视觉增强、Home Assistant 语音助手、书签打标、菜谱解析等,绝大多数属于异步低频短文本任务。文章指出,32GB 统一内存在运行其他自托管服务的同时难以流畅承载 26B 量化模型,建议以 9B-14B 量级模型为主力,既能覆盖几乎所有列出任务,又能保持合理速度。Apple Silicon 的高能效比和统一内存架构非常契合「常开低负载」的家庭 AI 中枢场景,隐私目标完全可达成,但模型选型需保持理性。
从 OpenRouter 到本地部署:一个典型的隐私诉求
Reddit 上一位自托管爱好者提出了一个颇具代表性的问题:他计划购入一台 M6 Mac Mini(32GB 内存),无头运行 Ollama,用于支撑家中一系列自托管应用的本地大模型推理。目前他大部分 AI 任务都通过 OpenRouter 完成,但出于隐私考虑,他希望「不再把任何数据发送到网络之外」。
这个诉求在自托管社区非常普遍。随着 Home Assistant、Frigate 等开源工具越来越多地集成生成式 AI 能力,用户开始意识到把家庭摄像头画面、语音指令、账单信息发给第三方 API 存在隐私风险。本地部署成为自然的替代方案,而问题的核心在于:一台入门级的 Apple Silicon 主机能否胜任?
Ollama 是目前最主流的本地 LLM 运行框架之一,它在 llama.cpp 的推理引擎之上封装了类 Docker 的模型管理体验和兼容 OpenAI API 格式的 HTTP 接口。用户可以用 ollama run llama3 这样的命令一键拉取并运行模型,而暴露出的 REST API(默认监听 localhost:11434)可以被 Home Assistant、Open WebUI 等上层应用直接调用,无需修改大量代码。Ollama 在 Apple Silicon 上通过 Metal API 调用 GPU 加速,能够自动识别可用内存并决定模型层的卸载策略。对于无头服务器场景,Ollama 可配置为 systemd/launchd 服务随系统启动,并通过环境变量 OLLAMA_HOST=0.0.0.0 开放局域网访问,使家庭内网中的其他设备和容器均可调用本地推理能力。
他想跑的这些应用,负载到底有多重?
发帖者列出了六类具体应用场景,值得逐一拆解其对模型的实际要求:
- Frigate(生成式 AI 增强):为监控画面生成描述,属于视觉理解任务,通常需要多模态模型,但触发频率不高。
- Home Assistant(Whisper-STT / Piper-TTS / 语音助手 / AI Tasks):语音转文字和文字转语音有专门的轻量模型,真正吃 LLM 的是「AI Tasks」和对话式语音助手,对响应延迟敏感。
- Linkwarden、Papra(标签生成):书签和文档的自动打标,属于短文本分类,负载很轻。
- Mealie(食材解析、菜谱导入):结构化信息抽取,同样是轻量文本任务。
- Securo(账户对话):需要一定的推理和上下文理解能力。
这些任务的共同特点是:大多为异步、低频、短文本处理,而非需要持续高吞吐的场景。这意味着即便硬件不算顶级,只要单次响应能在可接受时间内完成,用户体验就不会太差。
32GB 内存能装下什么模型?
发帖者点名想用 gemma4:26b(应为 Gemma 系列约 26B 参数的模型)。这里需要泼一点冷水。
Apple Silicon 的一大优势是统一内存架构,GPU 可以直接调用系统内存作为显存。但 32GB 内存并非全部可用——系统本身和其他自托管服务也要占用资源。一个 26B 参数的模型,即便采用 4-bit 量化,也需要约 15-18GB 内存来加载权重,加上推理时的 KV 缓存和上下文开销,32GB 会相当吃紧,尤其是在同时运行多个自托管应用的无头环境下。
更现实的选择是中小尺寸模型:
- 7B-9B 量级(如 Gemma 2 9B、Llama 3.1 8B、Qwen2.5 7B):4-bit 量化后仅需 5-6GB,运行流畅,足以应对标签生成、食材解析、简单对话等绝大多数列出的任务。
- 12B-14B 量级:在 32GB 上运行无压力,推理质量与速度取得较好平衡,适合作为主力模型。
- 26B+:可以跑,但会明显挤占其他服务的资源,速度也会下降。
对于发帖者列出的以「打标、解析、简单问答」为主的负载,一个高质量的 9B-14B 模型完全够用,盲目追求 26B 反而得不偿失。
**量化(Quantization)**是理解本地模型内存占用的关键概念。原始的大语言模型权重通常以 float16(每个参数 2 字节)或 bfloat16 格式存储,一个 26B 参数的模型原始权重就需要约 52GB。量化技术通过降低每个参数的数值精度来压缩模型体积:4-bit 量化将每个参数压缩到 4 bits(0.5 字节),理论上可将内存占用压缩到约 13GB,但实际还需额外开销,因此 26B 模型的 4-bit 量化版本通常落在 15-18GB 区间。常见的量化格式包括 GGUF(llama.cpp / Ollama 使用)中的 Q4_K_M、Q5_K_M 等,后缀字母代表不同的量化策略,在压缩率和精度损失之间取得不同平衡。量化不可避免地带来一定的输出质量损失,但在 4-bit 以上精度时,对多数实用任务的影响相对有限。
速度体验:Apple Silicon 的真实表现
M 系列芯片跑本地 LLM 的速度取决于内存带宽和 GPU 核心数。以往 M 系列基础款的内存带宽约在 100-120GB/s 区间,跑 7B-9B 量化模型通常能达到每秒二三十个 token 以上,交互体验接近云端;到了 20B 以上模型,速度会降到个位数或十几 token/s,用于异步后台任务尚可,用于实时语音对话则可能感到卡顿。
对发帖者而言,好消息是他的多数应用(标签、解析、Frigate 增强)都是后台异步任务,对延迟不敏感;唯一需要注意的是 Home Assistant 的语音助手对话,这类交互对首字延迟要求较高,建议搭配较小的模型以保证响应速度。
内存带宽是决定本地 LLM 推理速度的核心瓶颈,而非算力(FLOPS)。LLM 在生成每个 token 时需要将几乎全部模型权重从内存读入计算单元,这一操作是高度内存带宽受限的。以 Q4 量化的 8B 模型(约 4.5GB)为例,若内存带宽为 120GB/s,则理论上每秒可完成约 26 次完整权重读取,对应约 26 token/s 的生成速度。模型越大,单次读取数据量越多,在相同带宽下生成速度成比例下降——这正是 26B 模型速度显著慢于 8B 模型的根本原因。Apple Silicon 统一内存架构的优势在于 CPU 和 GPU 共享同一物理内存池,避免了传统 PCIe 显卡的数据搬运瓶颈,使得 Mac 上可用内存容量远大于同价位独立显卡的显存,但内存带宽本身仍是硬性约束。
这是一个合理的方案吗?
综合来看,用 M6 Mac Mini(32GB)无头运行 Ollama 来承载这套自托管 AI 栈,是一个务实且合理的选择:
- 隐私目标可达成:所有推理都在本地网络完成,彻底摆脱对 OpenRouter 等外部 API 的依赖。
- 硬件与负载匹配:列出的任务以轻量异步为主,Apple Silicon 的能效比和统一内存架构非常契合这类「常开低负载」场景,功耗和噪音也远低于独显主机。
- 模型选型需理性:放弃 26B 的执念,以 9B-14B 模型为主力,才能在多服务并行的情况下保持稳定。
如果预算允许,选择更高内存版本(如 48GB 或 64GB)会为未来运行更大模型或同时加载多个模型留出余地。但就当前列出的需求而言,32GB 加上合理的模型选型,已经能够搭建一套隐私自主、够用好用的本地 AI 中枢。
相关推荐
喜剧人Druski:一把顶在头上的枪,如何改变他的人生
喜剧人Druski自述:一把顶在头上的枪如何改变人生。从街头挣扎、退学到被Drake邀请参演MV引爆流量,这是一个关于创伤疗愈、坚持与内容创作使命感的真实故事。
你会按下AI按钮吗?一场关于人类命运的赌局思辨
一场关于「是否按下AI按钮」的深度思辨:千分之一灭绝概率对999个疾病治愈方案,你敢赌吗?本文剖析AI安全辩论中的伦理困境、虚假二元选择,以及全速推进AI的「正确时机」判断。
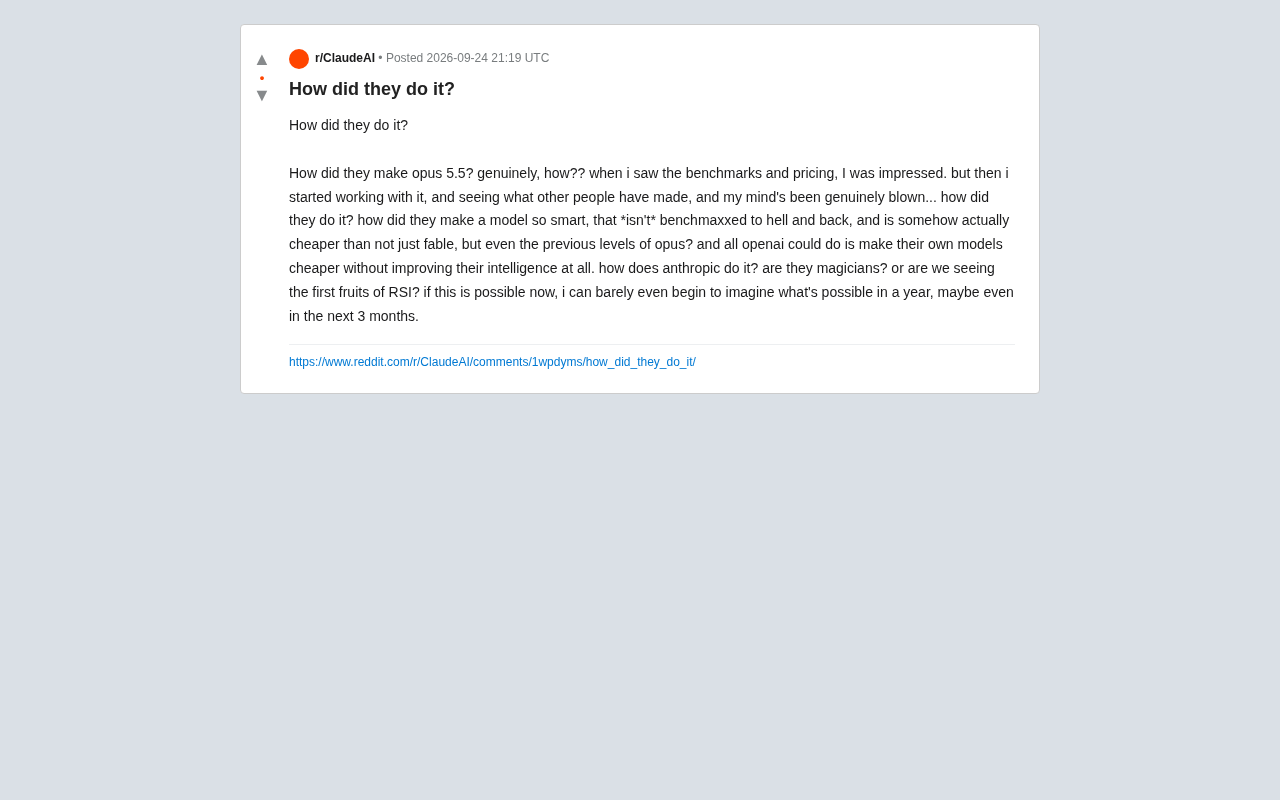
Opus 5.5引爆讨论:便宜又强的模型是怎么炼成的?
一条Reddit热帖引发热议:据称的Opus 5.5为何能做到更强、更便宜且不刷榜?本文梳理用户体验中的三个反常识点,并冷静分析RSI猜测与跳跃式进步背后的工程解释。