谷歌 Gemini 4 Argon 发布:登顶多项基准却藏隐忧

谷歌 Gemini 4 Argon 多榜单登顶、幻觉率骤降,但真实使用体验仍存疑问。
谷歌发布的全新基座模型 Gemini 4 Argon 在 Arena AI、Vals Dex 等多个第三方独立榜单中登顶,并在幻觉控制(15%)、三维空间理解(Blueprint Bench 2 第一)及百万 token 输出能力上展现出差异化优势,标志着谷歌在 AI 竞赛中重新发力。然而,彭博社的初步内部测试显示其真实工作场景表现可能不及纸面亮眼,编程能力(Code Arena 排名第八)也相对薄弱。基准成绩与实际体验之间的落差,是否只是刷榜假象,仍有待大规模用户验证。
谷歌刚刚发布的全新 AI 模型 Gemini 4 Argon 在社交媒体上掀起不小的波澜。根据 YouTube 频道 TheAIGRID 的解读,这款模型在谷歌公布的基准测试中以相当大的优势超越了几乎所有前沿模型,让一度被外界戏称为"AI 恐龙"的谷歌重新回到竞争前列。但基准成绩亮眼的背后,一些真实使用场景中的反馈却给热度泼了一盆冷水。
全新基座模型,而非 Flash 衍生版
值得关注的一个细节是,Gemini 4 Argon 并非谷歌 Flash 系列的升级版本,而是一个全新的基座模型。它被直接拿来和其他前沿旗舰模型对标,而不是与 Sonnet、Haiku 这类中小型号比较。
按照该视频的分析,Gemini 4 Argon 在知识工作、Agentic 编程、科学与数学、长上下文、计算机操作等多个维度上都展现出接近业界顶尖(state-of-the-art)的水平。在这样一个高度白热化的竞赛环境中,能做到如此跨度的提升确实令人意外——此前谷歌的多次更新都被认为"平平无奇"。
多个独立榜单交叉验证
UP主没有仅仅采信谷歌官方的宣传,而是查阅了多个第三方榜单。在 Arena AI 的综合排名中,Gemini 4 Argon High 在全部 29 个类别里位居第一,超过了 Opus、Astra 以及部分 Meta 模型。
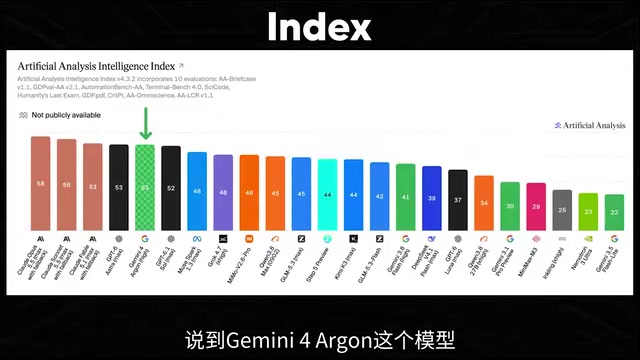
在偏向真实工作场景的 Vals Dex 榜单上,它同样拿下第一,甚至超越了仅几天前才发布的 Sonnet 5.5 和 Claude Opus 5.5。在 Artificial Analysis 综合指数中,Gemini 4 Argon 也稳居顶级前沿模型之列。
不过作者也客观指出,像文本写作竞技场(Text Arena)这类评测带有较强主观性,输出好坏取决于个人偏好,Claude Opus 在"创意写作"维度仍与其并列第一。而且顶级模型之间往往只有五到十分的差距,可以视为误差范围——但 Gemini 4 Argon 在部分榜单上出现了约 25 分的跳跃,这或许说明谷歌确实做了一些不一样的事情。
价格效率与三维世界理解是亮点
除了纯粹的性能,Gemini 4 Argon 的性价比也被反复提及。它虽然没有占据"价格—智能"象限中最理想的位置,但综合成本与表现,对多数用户而言足够有吸引力,相较其他前沿模型价格相对低廉。

另一个被低估的强项是三维世界理解。据 Andon Labs 的说法,Gemini 4 Argon 比任何其他 AI 都更懂物理三维世界,在 Blueprint Bench 2(让 AI 根据公寓内部照片绘制平面图的基准)上排名第一,击败了 Opus、Astra、Fable 等对手。这与谷歌长期在机器人与三维世界方向的投入相吻合——作为一家历史远比 OpenAI 和 Anthropic 更悠久的公司,谷歌在通往 AGI 的路径上有着不同的目标取向。
此外,谷歌 DeepMind 透露该模型拥有 100 万 token 的输出上限(注意不是上下文窗口),意味着它能在一次响应中生成多达百万 token,从而更好地处理长链条、多步骤的复杂任务。叠加谷歌一贯强大的长上下文能力(可输入一小时视频或音频进行处理),这在长文档和多模态任务上有明显优势。
Blueprint Bench 2 是专门评测 AI 空间认知与三维重建能力的基准:给定一组室内真实照片,AI 需要推断相对位置、估算尺寸,并生成符合真实比例的平面图。这项任务要求模型同时具备几何推理、深度感知与多视角一致性理解,而非仅靠语言模式匹配就能完成,因此被认为是衡量模型"真正理解物理世界"的有效指标之一。谷歌在该方向的积累源自其长期的机器人研究(如 RT-2 系列)与 Google Maps 三维建图经验,这与 OpenAI 或 Anthropic 以纯语言模型为核心的技术路径存在明显差异。100 万 token 的输出上限(区别于输入上下文窗口)则意味着模型可以在单次推理中生成极长的代码库、完整报告或多步骤规划,而无需截断或分段请求。
幻觉率显著下降
幻觉一直是 Gemini 系列的老大难问题。许多用户反映,在聊天界面使用 Gemini 时经常遇到模型"记错"对话历史或凭空编造信息的情况,其幻觉率相比其他前沿 AI 偏高,令人沮丧。

这一次谷歌似乎做了实质性改进。在幻觉基准测试中,Gemini 4 Argon 得分 15%(分数越低越好),比目前任何前沿模型都更少"胡编乱造"。而部分近期发布的前沿模型在该项上的分数要高得多。如果这一数据能在真实使用中得到印证,将是一个重要进步。
幻觉(Hallucination)特指大型语言模型生成看似流畅、实则不准确或凭空捏造的内容,覆盖范围从错误事实、虚构引用到错误记忆上下文对话。业界常用的幻觉基准包括 TruthfulQA、HaluEval 以及各类开放域问答数据集;分数越低表示模型产生幻觉的频率越低。Gemini 系列历史上幻觉率偏高,与其早期在事实核查和引用溯源方面的薄弱有关。此次 15% 的得分若能在独立复现中保持,将是实质性突破——相比之下,部分近期发布的竞争模型在同一基准上得分高达 30% 以上。需要注意的是,单一幻觉基准并不能覆盖所有场景,专业领域(如医学、法律)中的幻觉风险需要更有针对性的领域测试才能全面评估。
刷榜还是真材实料?
问题的核心随之浮现:这些漂亮的基准成绩,是实打实的能力,还是又一次"为跑分而优化"(Benchmax)?
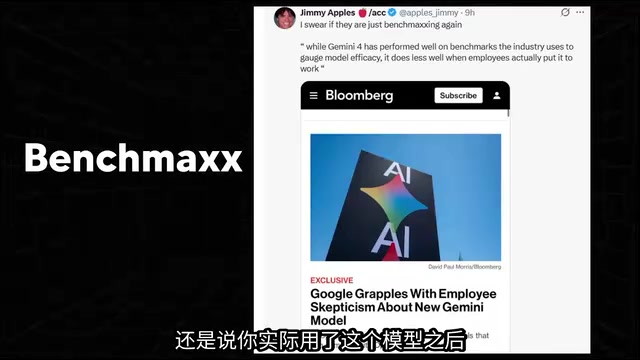
一篇彭博社(Bloomberg)的报道给出了谨慎的信号:Gemini 4 虽然在行业基准上表现优异,但当员工实际投入工作使用时表现"没那么好"。彭博自己的初步用户测试显示,这款模型在真实场景中的表现可能不如纸面数据亮眼。
作者也坦言这只是彭博一家之言,最终模型口碑仍要由终端用户决定。但这种"基准亮眼、实战拉胯"的情况在过往 AI 发布中并不罕见——不少模型跑分看似惊艳,真正对话起来却像在和一个不断幻觉的外星人交流。
编程能力同样是短板之一。在 Code Arena 的 Web Dev 项目上,Gemini 4 Argon 仅排第八,略高于 QWEN 3.8。这并不意味着它糟糕,而是说明在编程这一通往递归自我改进(RSI)的关键能力上,其他模型明显更强,而编程历来不是谷歌的强项。
「为跑分而优化」(Benchmarking Gaming,有时戏称 Benchmax)是 AI 领域的顽疾:模型训练时若大量接触基准测试题目或类似题型,即便没有直接"背题",也会在测试分布上产生过拟合,导致跑分远优于实际使用效果。学术界对此已有专门研究,Hugging Face 等机构也定期更新基准题库以对抗污染。值得关注的是,Arena AI、Vals Dex 等依赖真实用户偏好投票的"竞技场式"榜单,理论上更难被直接刷分——因为它们评测的是与真实用户交互的主观体验,而非固定答案。Gemini 4 Argon 在这类榜单同样领先,一定程度上增加了其成绩的可信度,但终究无法完全排除训练数据与用户投票行为存在相关性的可能。
结语
Gemini 4 Argon 的发布让谷歌在 AI 竞赛中重新站上牌桌,尤其是在综合榜单、价格效率、三维理解和幻觉控制上表现亮眼。但基准神话与真实体验之间的落差,仍需等到广泛的用户测试才能揭晓答案。对于已经习惯 Opus 或 ChatGPT 工作流的用户来说,是否值得给谷歌一次机会,恐怕要亲自上手后才能判断。
相关推荐

吴恩达Agent课精华:从单代理到完全自动化的实践路径
吴恩达联合LangChain推出的AI Agents in LangGraph课程精华解读:涵盖Agentic Workflow五大设计模式、从零手写ReAct智能体、LangGraph节点与状态管理、Agentic Search、持久化与人类介入,以及多智能体等前沿架构。

AI编程工具自动执行该不该全开?权限管控实战指南
AI编程工具的自动执行功能要不要全开?本文从权限分层、任务拆分、命令审核等角度,给出实战可用的安全配置建议,帮助开发者在效率与控制之间找到平衡。

10个AI Agent全自动开发游戏:我一行代码都没写
一位创作者用约10个AI Agent并行全自动开发游戏,自己一行代码都没写,只负责描述需求。本文解析Agent灰盒迭代、过程文档化与Unity项目恢复能力等亮点。