谷歌前沿模型跳票基准测试?社区质疑声起
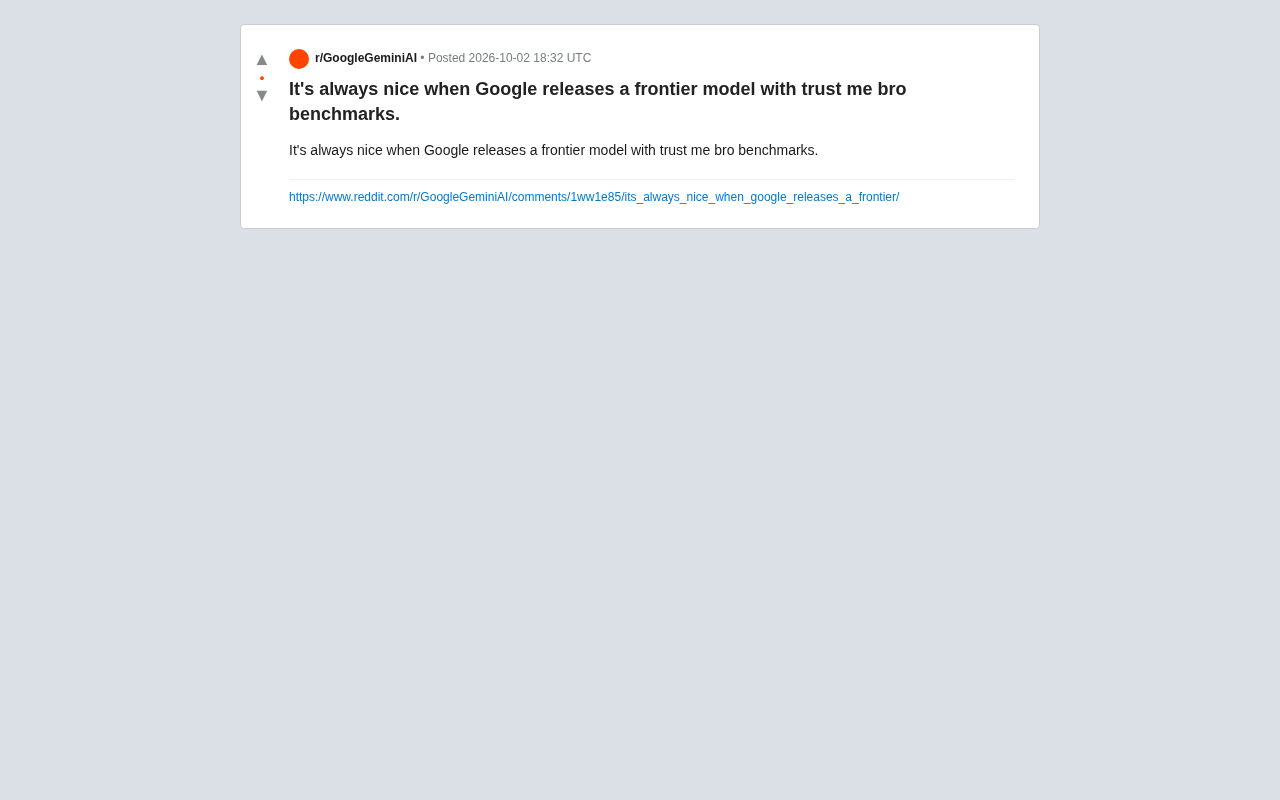
Reddit社区调侃AI厂商发布模型时惯用不透明的"相信我"式基准测试,折射出业界对评测可信度的普遍质疑。
一条调侃谷歌"Trust me bro"式基准测试的Reddit帖子,在AI社区引发广泛共鸣。文章指出,大模型厂商在发布新模型时普遍缺乏对测试方法、评测集版本和对比条件的透明披露,使外界无法独立复现官方跑分。这一问题因基准数字直接影响媒体引用、开发者选型和投资判断而显得尤为关键。对比口径不一、数据污染风险、选择性披露是导致官方榜单失真的三大主要因素。作者呼吁行业向LMSYS Chatbot Arena等第三方独立评测靠拢,并建议用户交叉参考多个来源,以理性审慎的态度面对任何前沿模型的发布宣传。
一条Reddit吐槽引发的讨论
在AI社区里,每当大厂发布新一代前沿模型,随之而来的往往是一轮关于基准测试可信度的争论。近日,一条来自Reddit的调侃帖子引发了不少共鸣:“谷歌发布前沿模型时,总爱用‘相信我兄弟’式的基准测试,这感觉真不错。”
这句略带讽刺的话,直指当前大模型发布过程中一个被反复诟病的现象——厂商在官方发布材料中展示的跑分数据,常常缺乏可复现的透明细节,社区只能被动接受这些“官方口径”的结果。
“Trust me bro”基准测试到底指什么
“Trust me bro”是英文网络俚语,字面意为“相信我,兄弟”,通常用来调侃那些没有证据支撑、仅凭一句话让人相信的说法。放在AI模型发布的语境下,它指的是厂商在宣传新模型时抛出一系列亮眼的基准成绩,却没有公开完整的测试方法、评测数据集版本、提示词设置,甚至不提供第三方可独立验证的途径。
这种做法并非谷歌独有。几乎所有头部AI实验室在新模型发布时都会选择对自己最有利的评测维度和对比对象,这是营销的常规操作。但正因为前沿模型的能力评估直接影响行业判断与用户预期,社区对数据透明度的要求也越来越高。
为什么基准测试的可信度如此重要
基准测试是外界衡量模型能力最直接的标尺。当一个模型宣称在某项推理、代码或多模态任务上达到新高度时,这些数字会迅速被媒体引用、被开发者作为选型依据、被投资者当作技术领先的佐证。
如果这些数字无法被独立复现,几个现实问题随之而来:
- 对比口径不一致:厂商可能用自家模型的最优配置,去对比竞品的默认配置,导致结果失真。
- 数据污染风险:评测集若已被纳入训练数据,跑分虚高却难以察觉。
- 选择性披露:只展示表现好的任务,回避短板领域。
这些因素叠加,使得单凭官方发布的榜单数字难以判断一个模型的真实水平。
数据污染(Data Contamination)是当前大模型评测中最难被外界察觉的问题之一。由于主流评测集(如MMLU、HumanEval、GSM8K等)长期公开在互联网上,模型在预训练或微调阶段极有可能接触过这些题目甚至标准答案,导致测试成绩虚高。这一问题的隐蔽性在于:厂商未必是故意为之,大规模网络爬取数据天然包含评测集内容,且事后很难完整审计哪些数据进入了训练集。部分研究者尝试通过构建"未来数据集"(即模型训练截止日之后才公开的题目)或动态生成新题来缓解污染问题,但这类方法尚未成为行业标准。正因如此,对任何声称在公开基准上大幅超越前代的成绩,保持额外的审慎是合理的。
社区的期待:更透明的评测生态
这条吐槽背后,反映的是AI社区对第三方独立评测和可复现性的呼声。近年来,像LMSYS Chatbot Arena这类基于真实用户盲测的排行榜,以及各类开源评测框架之所以受到欢迎,正是因为它们提供了比厂商自述更中立的参照。
对厂商而言,公开评测方法、给出可复现的脚本、说明对比条件,不仅能平息质疑,长期来看也更有利于建立技术公信力。对用户和开发者而言,保持对任何单一来源跑分的审慎态度,交叉参考多个独立评测结果,才是更稳妥的选型方式。
LMSYS Chatbot Arena是由加州大学伯克利分校团队维护的开放式模型评测平台,核心机制是让真实用户在不知道模型身份的情况下,与两个匿名模型同时对话,并在交互后投票选出更满意的一方。这种"盲测+真实用户"的设计规避了厂商自测的利益冲突,也避免了预设评测题目被针对性优化的问题。平台使用Elo积分体系汇总投票结果,形成持续更新的排行榜。由于用户的提问涵盖日常使用中的真实需求,而非学术评测集中的标准题型,Chatbot Arena的结果被许多开发者认为比单一基准分数更能反映模型的实际可用性。不过它也有局限:投票质量依赖用户群体的构成,特定专业领域的深度能力难以通过大众投票准确区分。
结语
这则来自Reddit的简短调侃,没有提供具体的模型名称或数据细节,更多是社区情绪的一次集中表达。它提醒我们:在AI能力竞赛日益激烈的当下,比亮眼的跑分更珍贵的,是那些能被验证、可被复现的透明数据。面对任何前沿模型的发布,保持一分理性与质疑,始终是值得的。
注:本文基于一条Reddit社区讨论撰写,原始素材信息有限,相关观点仅代表社区的普遍情绪,不针对任何具体产品的实际性能结论。
相关推荐
语音识别远未解决:Mistral音频研究负责人深度解析
Mistral AI音频研究负责人Pavan Kumar Reddy深度解析语音识别为何远未解决:从Voxtral模型架构、连续隐变量生成、流式与批量权衡、说话人分离难题到DPO修复幻觉,以及语音技术在真实企业场景的落地短板。
AI权重可被复制,为何反而扼杀了创造力?
AI模型权重可被随意复制,这种开放权重的无约束特性反而削弱了创造力。本文解析复制为何是反模式、约束如何催生新颖,以及"约束工程师"这一正在浮现的新角色。
NVIDIA Cosmos解析:物理AI如何打通语言、视频与动作
NVIDIA研究负责人Ming-Yu Liu深度解析Cosmos物理AI世界模型:如何用单一架构打通语言、视频、音频与动作,涵盖自回归塔与扩散塔协作、多模态时间对齐、策略验证仿真及Super/Nano/Edge三种开源模型。