关键帧记忆法:破解长时序行为克隆的记忆难题
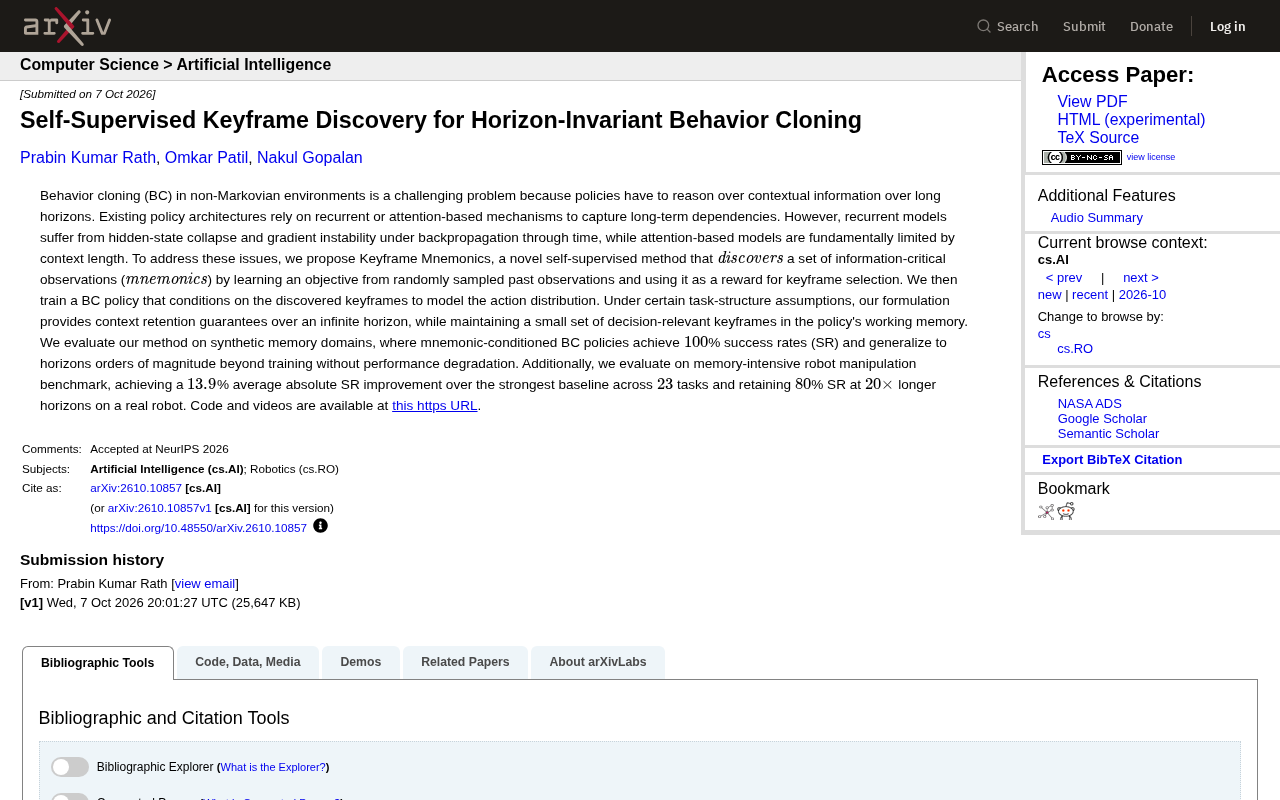
关键帧记忆法通过自监督筛选少量信息关键帧,实现长时序机器人行为克隆的时序不变泛化。
论文提出 Keyframe Mnemonics(关键帧记忆法),针对机器人长时序行为克隆中循环模型状态坍缩和注意力模型上下文窗口受限的双重瓶颈,采用自监督方式主动发现一小组「记忆点」关键帧,再基于这些关键帧训练行为克隆策略。在理论层面,该方法在特定任务结构假设下能提供无限时间跨度的上下文保持保证。实验结果显示:合成记忆任务成功率达 100%,并可泛化到训练时序数个数量级之外;在 23 个机器人操作基准任务上较最强基线平均绝对成功率提升 13.9%;真实机器人在 20 倍训练时序长度下仍保持 80% 成功率,展现出强大的「训练短、测试长」泛化能力。
长时序行为克隆为何如此棘手
在非马尔可夫环境中训练策略一直是机器人学习领域的硬骨头。所谓非马尔可夫,指的是当前的最优决策不仅取决于眼前的观测,还要依赖此前漫长时间线上的上下文信息。机器人要完成一项任务,可能需要记住很久以前看到的某个关键线索,并在恰当时刻调用它。
现有方案主要依赖两类架构来捕捉长程依赖,但它们都有明显短板。基于循环(recurrent)的模型容易出现隐藏状态坍缩(hidden-state collapse)和梯度不稳定的问题,这在通过时间反向传播(BPTT)训练时尤为突出;而基于注意力(attention)的模型则受制于上下文长度的根本限制,窗口一旦超出,早期信息就被遗忘。
换句话说,当任务时间跨度拉长到训练时未曾见过的程度,这些模型往往会迅速失效。这正是这篇 arXiv 论文想要解决的核心痛点。
行为克隆(Behavior Cloning,BC) 是模仿学习中最基础的范式:直接从专家演示数据中学习一个从观测到动作的映射,本质上是一种监督学习。它的优点是简单高效,不需要设计奖励函数;但其固有弱点是复合误差(compounding errors)——策略一旦偏离演示轨迹,就会进入训练时未见过的状态,误差不断累积。当任务时间跨度变长,这一问题与长程依赖的挑战叠加,使得传统 BC 方法几乎无法直接处理分钟级甚至更长的任务序列。通过时间反向传播(Backpropagation Through Time,BPTT) 是训练循环神经网络的标准算法,需要沿时间轴展开计算图来计算梯度,序列越长,梯度消失或爆炸的风险越高,这也是循环模型在超长时序任务上表现不稳定的根本原因。
关键帧记忆法的核心思路
研究团队提出了一种名为 Keyframe Mnemonics(关键帧记忆法) 的自监督方法。它的核心理念是:与其让模型记住所有历史观测,不如主动发现一小组信息关键的观测,论文称之为「记忆点(mnemonics)」。
具体做法分两步。第一步,通过从随机采样的历史观测中学习一个目标函数,并将其作为奖励信号,用于筛选哪些帧值得被记住——这就是关键帧选择的过程。整个过程是自监督的,不需要人工标注哪些帧重要。第二步,训练一个行为克隆(BC)策略,让它基于这组被发现的关键帧来建模动作分布。
这种设计的巧妙之处在于,它把「记住一切」转化为「记住最关键的少数」。策略的工作记忆中始终只维持一小组与决策相关的关键帧,既避免了循环模型的状态坍缩,也绕开了注意力模型的上下文长度瓶颈。
理论层面的保证
论文还给出了理论支撑:在满足特定任务结构假设的前提下,该方法能够提供无限时间跨度上的上下文保持保证(context retention guarantees)。这意味着无论任务持续多久,只要关键信息被正确捕捉为记忆点,策略就能持续调用它,而不会随时间衰减。这是「horizon-invariant(时序不变)」这一命名的由来。
「时序不变(horizon-invariant)」这一性质在机器人学习领域具有特殊价值。现有大多数策略在训练时只见过固定长度的演示片段,其泛化能力通常与训练时序长度强绑定——时序一旦超出训练分布,性能便快速退化。这类问题在 sim-to-real 迁移和长时操作任务中尤为突出:实验室演示往往是经过剪辑的短序列,而机器人在真实部署时面对的是连续的、时间不确定的交互场景。能够证明「无论时序多长,关键信息都不会因时间延伸而丢失」,意味着训练与部署之间的时序分布偏移问题在理论上得到了解耦,这对于提升方法的实际可靠性具有重要意义。
实验结果:泛化能力是最大亮点
研究在两类场景下验证了方法有效性。
在合成的记忆类任务域中,基于记忆点的 BC 策略达到了 100% 的成功率,并且能够泛化到比训练时长出数个数量级的时间跨度,性能几乎没有衰减。这一点非常关键——它直接证明了方法的时序不变特性不只是理论推演,而是能在实验中复现。
在更贴近现实的记忆密集型机器人操作基准测试上,方法在 23 个任务上相较最强基线取得了 13.9% 的平均绝对成功率提升。更有说服力的是真实机器人实验:在时间跨度拉长到训练时 20 倍 的条件下,策略仍保持了 80% 的成功率。
对比来看,传统方法在时间跨度大幅延长时往往崩溃,而关键帧记忆法能保持相对稳定的表现,这种「训练短、测试长」的泛化能力在实际部署中价值巨大——机器人在现实世界执行的任务往往比训练演示要长得多。
这项研究的意义与局限
关键帧记忆法提供了一个值得关注的新思路:长时序记忆问题未必要靠更大的上下文窗口或更复杂的循环结构来硬扛,主动筛选信息关键帧或许是更优雅的解法。它把「记忆」从一个被动的架构属性,变成了一个可学习、可优化的显式目标。
不过也要客观看待其边界。论文的理论保证建立在「特定任务结构假设」之上,这意味着在不满足这些假设的复杂任务中,效果可能打折扣。此外,记忆点发现的质量高度依赖自监督目标函数的设计,这部分如何在更开放的真实环境中保持鲁棒,仍有待更多验证。
团队已在项目页面(keyframe-mnemonics.github.io)公开了代码和视频,感兴趣的研究者可以进一步查阅实现细节。对于从事模仿学习、机器人操作和长时序决策的研究者而言,这是一项值得跟进的工作。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。