GUI-JEPA:无解码器GUI智能体,速度提升4倍
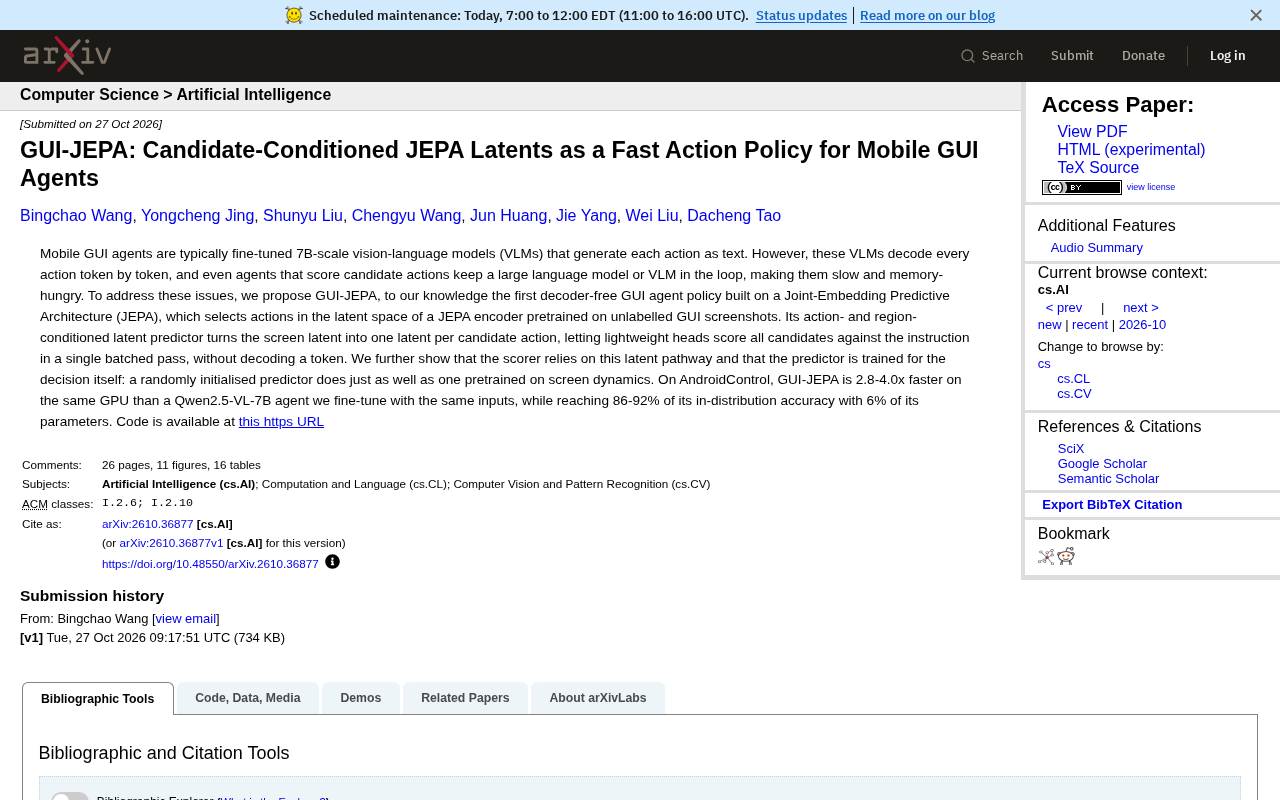
GUI-JEPA用JEPA潜空间候选评分替代文本解码,速度提升数倍且参数大减。
GUI-JEPA 提出一种无需文本解码的移动 GUI 智能体策略:先用 JEPA 编码器把屏幕截图映射为潜表示,再由动作条件化的潜预测器为每个候选动作生成潜向量,最后由轻量评分头在单次前向中与指令匹配打分,全程不生成任何 token。在 AndroidControl 上,它比同输入微调的 Qwen2.5-VL-7B 快 2.8–4.0 倍,仅用 6% 参数量达到后者 86%–92% 的分布内精度。论文还发现潜预测器无需预训练,随机初始化与预训练表现相当,说明决策主要依赖 JEPA 编码器的屏幕表示。该方法目前仅在单一基准验证,候选生成与跨平台泛化仍待探索。
移动GUI智能体通常依赖70亿参数规模的视觉语言模型(VLM),通过逐token生成文本来决定点击或滑动。这种范式虽然灵活,却带来两个突出问题:推理速度受限于自回归解码,且大模型常驻内存导致部署成本高。近期一篇题为《GUI-JEPA: Candidate-Conditioned JEPA Latents as a Fast Action Policy for Mobile GUI Agents》的工作提出了另一种思路——完全绕开文本解码,直接在潜空间中完成动作选择。
从“生成动作”到“评估候选”
GUI-JEPA的核心洞察在于:GUI操作的动作空间本质上是离散且可枚举的。与其让模型逐字生成“点击坐标(320, 480)”,不如预先列出一组候选动作,让模型快速判断哪个候选与当前指令最匹配。
研究团队构建了一个基于联合嵌入预测架构(JEPA)的策略网络。该架构首先在无标签的GUI截图上预训练一个JEPA编码器,将屏幕图像映射为潜表示。随后,一个以动作和区域为条件的潜预测器(latent predictor)将屏幕潜表示转换为每个候选动作对应的潜向量。最终,轻量级评分头在单次批量前向传播中,将所有候选动作的潜向量与指令进行匹配打分,全程不生成任何文本token。
这种设计的直接好处是消除了解码开销。传统VLM智能体即使采用候选评分策略,仍需将大模型保留在推理环路中;而GUI-JEPA的评分过程仅涉及潜空间运算,参数量大幅缩减。
联合嵌入预测架构(JEPA) 由 Yann LeCun 等人提出,属于非生成式的自监督学习框架。与重建像素或逐 token 生成的自回归模型不同,JEPA 在潜空间中做预测:编码器把输入(如图像)映射为表示,预测器根据上下文预测目标部分的潜表示,训练目标是让预测表示与目标表示在嵌入空间中对齐,而非还原原始像素。这种设计避免了对无关细节的建模,表示更紧凑、语义性更强,推理时也无需解码。在 GUI 场景中,JEPA 编码器因此能高效提取屏幕布局与控件信息,为后续的潜空间动作评分提供基础。
候选动作评分(candidate scoring / reranking) 是一种判别式决策范式:系统预先枚举有限个候选动作(如网格化的点击坐标、若干滑动方向),再由模型为每个候选打分并选取最高分者。与自回归生成相比,它把“开放式序列生成”转化为“闭集分类/排序”问题,单次前向即可并行评估全部候选,省去逐 token 解码的串行开销。其效果高度依赖候选集的覆盖度:候选过粗会损失精度,过细则增加计算量。GUI-JEPA 正是把这一范式从文本评分迁移到潜空间评分,从而同时获得候选评分的效率与潜表示的紧凑性。
性能表现:速度与精度的权衡
在AndroidControl基准上,GUI-JEPA与研究团队用相同输入微调的Qwen2.5-VL-7B智能体进行了对比。结果显示,在相同GPU上,GUI-JEPA的推理速度是后者的2.8至4.0倍,同时仅使用6%的参数量,便达到了Qwen2.5-VL-7B在分布内精度86%至92%的水平。
这一结果意味着,对于大量常见的GUI操作任务,一个轻量级潜空间策略可以在几乎不牺牲可用精度的前提下,将响应速度提升数倍,并显著降低内存占用。对于需要在端侧或资源受限环境中部署GUI智能体的场景,这种取舍具有实际吸引力。
AndroidControl 是面向 Android 设备 GUI 智能体的公开基准,包含大量真实应用截图与人类操作轨迹,任务以自然语言指令给出,要求智能体输出下一步动作(如点击、输入、滑动)。其评测通常区分“分布内”(任务类型与应用见于训练分布)与“分布外”设置,并同时考察动作类型预测与点击位置精度。由于动作空间为移动端 GUI,且提供指令—截图—动作三元组,它常被用于比较不同 VLM 智能体的逐步决策能力。GUI-JEPA 选择该基准,便于与同等输入微调的 7B 级 VLM 基线在相同条件下直接对比速度与精度。
关键发现:预测器无需预训练
论文中一个反直觉的发现值得关注:用于决策的潜预测器并不需要从屏幕动态预测任务中预训练。实验表明,随机初始化的预测器与经过屏幕动态预训练的预测器表现相当。这说明评分头真正依赖的是JEPA编码器提供的潜表示路径,而非预测器学到的动态知识。
换句话说,JEPA预训练的价值主要体现在编码器对GUI屏幕的理解上,而动作条件化的潜预测器更像是为决策任务现场学习的轻量适配层。这一发现为后续简化训练流程提供了依据——至少在这个架构中,预测器可以跳过昂贵的预训练阶段。
潜预测器(latent predictor)与评分头(scoring head) 在本架构中承担不同职责。潜预测器以屏幕潜表示以及候选动作、区域条件为输入,输出该候选对应的条件化潜向量,相当于把“动作意图”注入表示空间;评分头则是轻量的匹配模块,将这些潜向量与指令表示做相似度打分并排序。二者参数量远小于 VLM,且不涉及文本生成。实验显示预测器随机初始化即可,说明决策所需信息主要来自 JEPA 编码器已学到的屏幕表示,预测器更像任务特定的轻量适配层,可在下游训练中快速习得,无需昂贵的动态预训练。
局限与待探索空间
GUI-JEPA目前仅在AndroidControl上验证,动作空间和任务类型相对有限。候选动作的生成策略、潜空间评分对复杂多步任务的适应性、以及跨平台(如桌面GUI)的泛化能力,都是尚未充分回答的问题。此外,86%至92%的精度保留率意味着在精度敏感场景中,大模型仍有存在价值。
不过,这项工作的方向值得重视:它证明了GUI智能体的动作选择可以脱离自回归解码,在潜空间中高效完成。代码已在GitHub开源,为后续研究提供了可复现的基线。
相关推荐
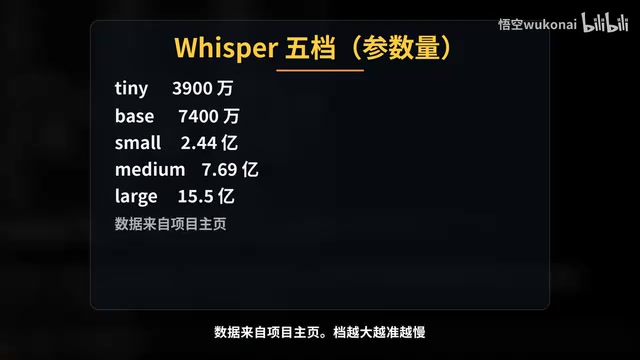
Claude Code实战:零代码搭建切片工厂,长视频自动变竖屏短视频
B站UP主悟空用Claude Code零代码搭建切片工厂,将35分钟长视频自动切成10条竖屏短视频。从Plan Mode、Whisper转写、claude.md规则、Hook质检到Subagent审核和Plugin分发,完整实战流程与实测数据。
WorkBuddy保姆级教程:AI Agent如何帮你自动转文件
WorkBuddy保姆级教程实战:从豆包只能给方案到AI Agent直接动手,三分钟批量转换PDF并归档。含安装、积分机制、与Codex对比及上手建议。
零基础入门Java+DeepSeek实战:程序员转型AI大模型开发指南
本文基于B站直播教学,详解Java程序员如何零基础转型AI大模型开发,涵盖技能路径、实战构建第一个Java AI应用、简历包装与求职策略,助你抓住大模型时代机遇。