轨迹即老师:能量导航蒸馏实现少步离散流匹配
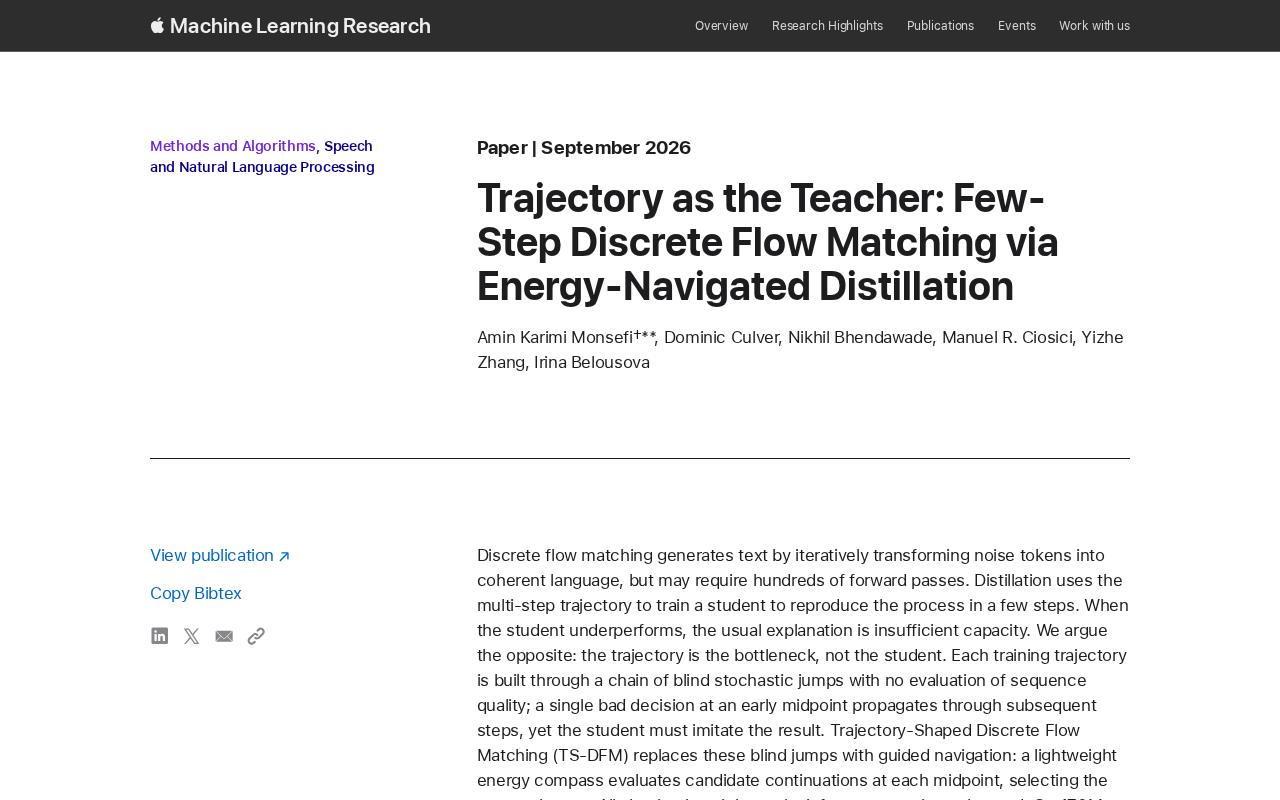
研究指出离散流匹配蒸馏的瓶颈在于训练轨迹质量而非学生模型容量,并提出能量导航蒸馏加以改进。
离散流匹配是一种通过多步迭代将噪声token转化为文本的生成范式,但其数百次前向传播的推理成本使其实用性受限,蒸馏技术因此被寄望于压缩推理步数。论文《Trajectory as the Teacher》提出,蒸馏效果不佳的根本原因并非学生模型容量不足,而是训练轨迹本身由「盲目随机跳跃」构成——每步采样不对序列质量做任何评估,导致早期错误沿轨迹连锁传播,学生模型被迫学习有缺陷的示范。为此,研究提出能量导航蒸馏(Energy-Navigated Distillation),引入能量函数对轨迹构建过程进行质量引导,从源头提升示范轨迹的可靠性,从而让学生模型只需少数几步即可生成高质量文本。这一工作将研究焦点从「如何强化学生」转向「如何改善教师轨迹」,对蒸馏研究的默认假设提出了实质性挑战。
离散流匹配的效率困境
离散流匹配(Discrete Flow Matching)是一种新兴的文本生成范式,它通过迭代地将噪声token逐步转化为连贯的语言,最终得到高质量的文本输出。这一过程在理论上优雅,但在实践中面临一个明显的瓶颈:为了生成一段流畅的文本,模型可能需要执行数百次前向传播。这种高昂的推理成本让离散流匹配难以在实际部署中与主流自回归模型竞争。
为了解决效率问题,研究者通常引入**蒸馏(Distillation)**技术。其核心思路是让一个「学生模型」学习并复现「教师」的多步生成轨迹,从而将原本需要数百步才能完成的生成过程压缩到寥寥几步。这一方向被寄予厚望,但实际效果往往不尽如人意。
离散流匹配在技术上属于**扩散模型(Diffusion Models)**在离散域的延伸。图像生成领域的扩散模型通过在连续像素空间中逐步去噪来生成图像,而离散流匹配则将这一思路迁移到文本的离散token空间:从一个充满随机或mask token的序列出发,经过若干步骤逐渐「还原」出有意义的文字。与自回归模型(如GPT系列)从左到右逐词生成的方式不同,离散流匹配可以并行修改整个序列,理论上具备更高的并行度。但代价是需要多次完整的模型前向传播,而自回归模型每生成一个token只需一次前向传播,二者的效率对比在序列较短时尤为悬殊。这一背景解释了为何研究者需要借助蒸馏技术来压缩推理步数,才能使离散流匹配在实际部署中具备竞争力。
问题的根源:不是学生,而是轨迹
当蒸馏后的学生模型表现不佳时,业界的惯常解释是「学生模型容量不足」——也就是模型太小、参数不够,学不会复杂的生成过程。然而,这篇题为《Trajectory as the Teacher》的研究提出了一个截然相反的观点:真正的瓶颈是轨迹本身,而非学生模型。
研究者指出,每一条用于训练的生成轨迹,实际上是由一连串「盲目的随机跳跃」构成的。在传统的离散流匹配过程中,每一步的采样都不会对当前序列的质量进行任何评估。这意味着模型只是机械地按照概率分布进行token替换,而不知道自己生成的中间结果究竟好不好。
早期错误的连锁传播
这种「盲跳」机制带来一个严重后果:如果在生成轨迹的早期中间点做出了一个糟糕的决策,这个错误会沿着后续的每一步不断传播和放大。学生模型被要求忠实地复现这条轨迹,也就等于被迫学习并继承了这些早期的错误决策。
换句话说,当教师提供的示范本身就是有缺陷的,再优秀的学生也无法学出高质量的结果。问题不在于学生的学习能力,而在于教材质量。这一视角的转变,为改进少步离散流匹配指明了新方向。
这一现象在控制论和机器学习中被称为复合误差(Compounding Errors),在自回归模型的序列解码中同样存在,但离散流匹配的蒸馏场景让它更加棘手。在自回归生成中,每步的输入是模型自身的上一步输出,一旦训练与推理的分布出现偏差,错误就会在后续步骤中滚雪球式地累积——这也是序列到序列模型需要「教师强制(Teacher Forcing)」训练技巧的原因。而在离散流匹配蒸馏中,学生模型直接以有缺陷的轨迹中间帧作为训练目标,相当于把错误的「路标」硬编码进了学习目标本身,比自回归情境下的复合误差更难通过常规正则化手段缓解。
能量导航蒸馏的思路
基于上述洞察,研究提出了**能量导航蒸馏(Energy-Navigated Distillation)**方法。其核心理念是:在构建训练轨迹时,引入对序列质量的评估机制,用某种「能量」信号来引导每一步的跳跃方向,而不是完全依赖盲目的随机采样。
通过能量函数对轨迹进行导航,可以在生成早期就避免那些会导致质量崩坏的决策路径,从而为学生模型提供更高质量、更可靠的示范轨迹。当教师轨迹本身更优时,学生只需少数几步就能重现出连贯、高质量的文本。
这一方法把研究的焦点从「如何训练更强的学生」转向了「如何构建更好的教师轨迹」,是对少步生成蒸馏范式的一次重要反思。
「能量函数(Energy Function)」这一概念借鉴自统计物理与基于能量的模型(Energy-Based Models, EBM)。在机器学习语境中,能量函数是一个标量评分函数,对质量更高的样本赋予更低的能量值(更受青睐),对质量差的样本赋予更高能量。通过在每步采样时沿能量梯度的下降方向调整token选择概率,模型可以系统性地偏向质量更好的中间序列,而非纯粹按照概率分布随机跳跃。这与强化学习中的奖励塑造(Reward Shaping)思想相近:不等到最终结果才给出反馈,而是在每个中间状态就提供质量信号,引导探索朝更优方向收敛。能量导航蒸馏的关键工程挑战在于如何设计一个计算高效、且能真实反映文本质量的能量函数,使其在构建轨迹时的额外开销不会抵消压缩推理步数所带来的效率收益。
对文本生成范式的启示
这项工作的价值不仅在于提出了一个具体方法,更在于它挑战了蒸馏研究中一个被广泛默认的假设。长期以来,当蒸馏效果不佳时,人们习惯性地归因于模型容量,而忽视了训练信号(轨迹)本身的质量。
对于致力于降低生成模型推理成本的研究者和工程师而言,这一视角提供了实际启发:与其一味地扩大学生模型,不如先审视示范数据的质量。在扩散模型、离散流匹配等迭代式生成范式中,中间步骤的质量控制可能是决定最终效率与效果的关键。
随着少步生成技术的成熟,如何让文本生成模型在保持质量的前提下大幅压缩推理步数,将成为推动这类模型走向实用化的核心课题。这篇研究为该方向提供了一个富有启发性的切入角度。
相关推荐
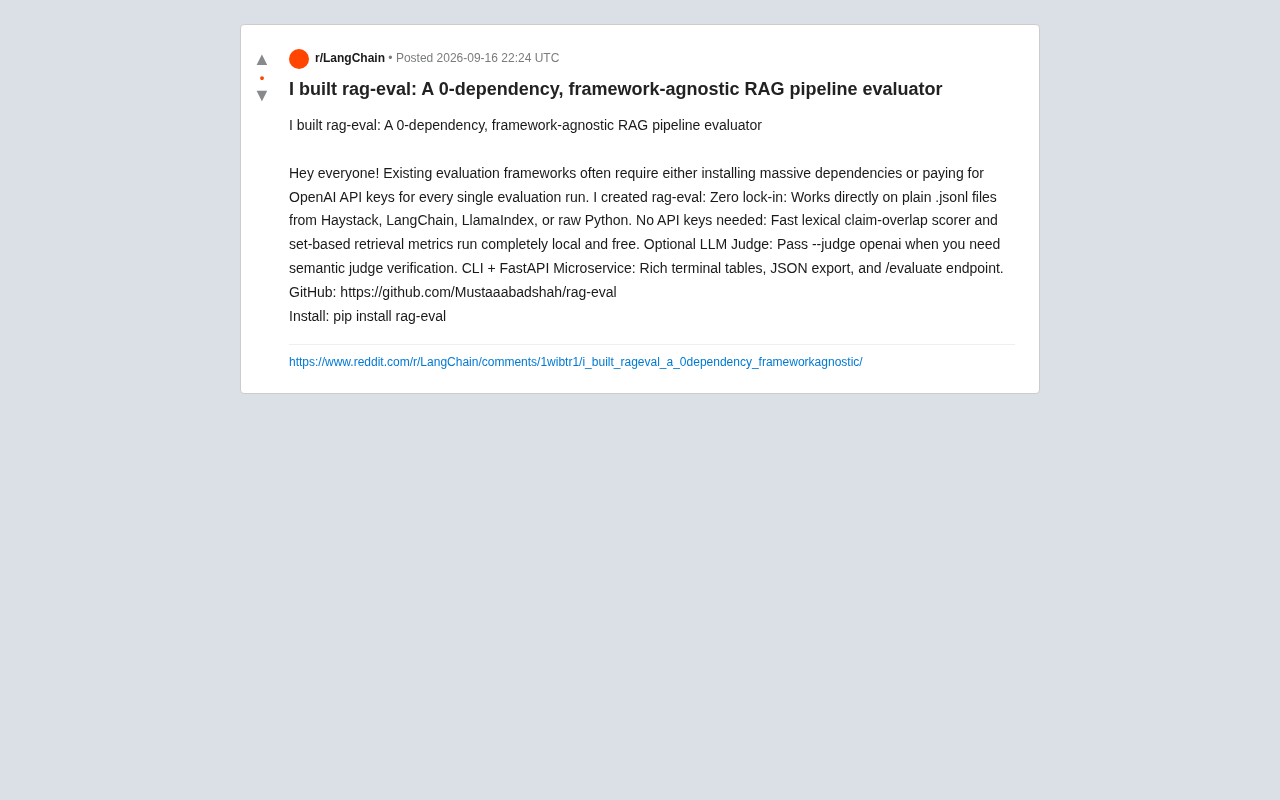
rag-eval:零依赖、无需API密钥的RAG评测工具
rag-eval 是一款零依赖、框架无关的开源RAG管线评测工具,支持本地免费的词法与检索指标,无需API密钥,并可选启用LLM Judge做语义验证,兼容Haystack、LangChain、LlamaIndex。
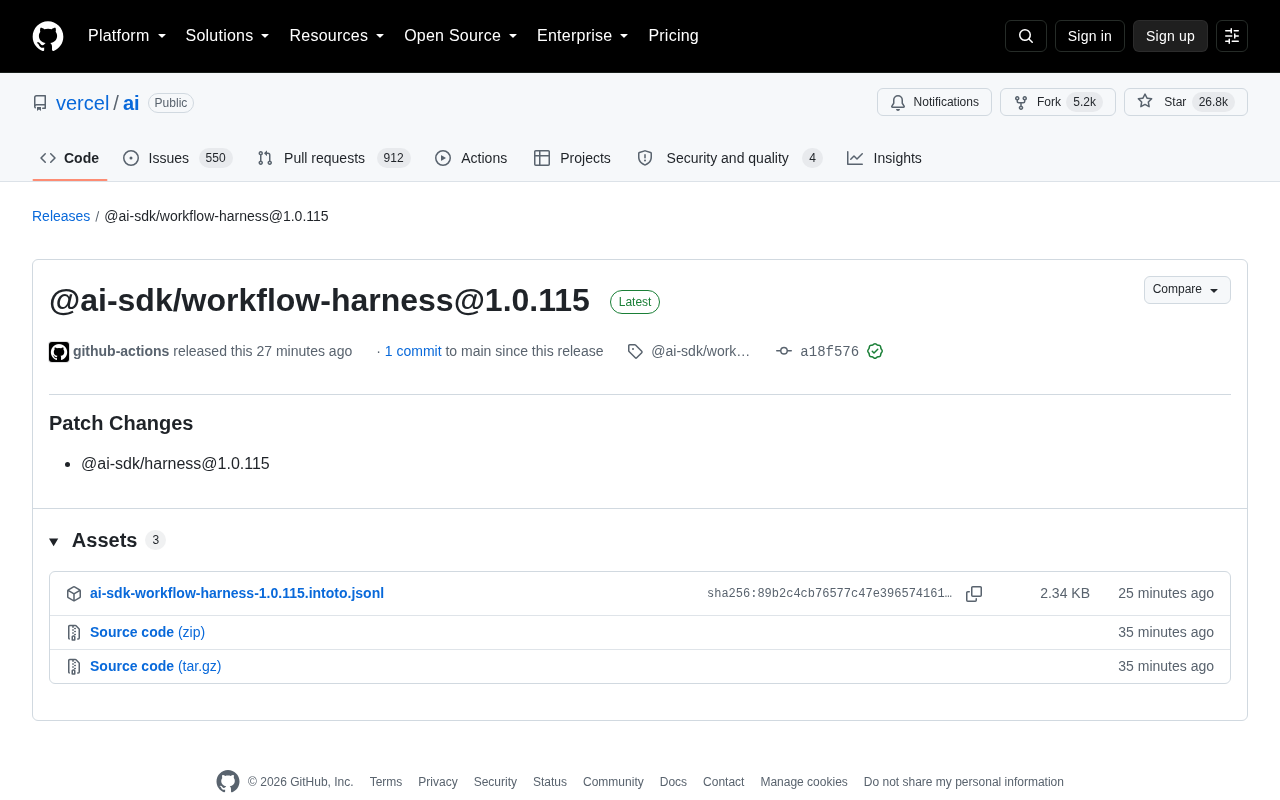
Vercel AI SDK 发布 workflow-harness 1.0.115 补丁更新
Vercel AI SDK 开源仓库发布 @ai-sdk/workflow-harness 1.0.115 补丁版本,同步升级 @ai-sdk/harness 依赖。本文解析该更新内容、发布机制与对开发者的意义。
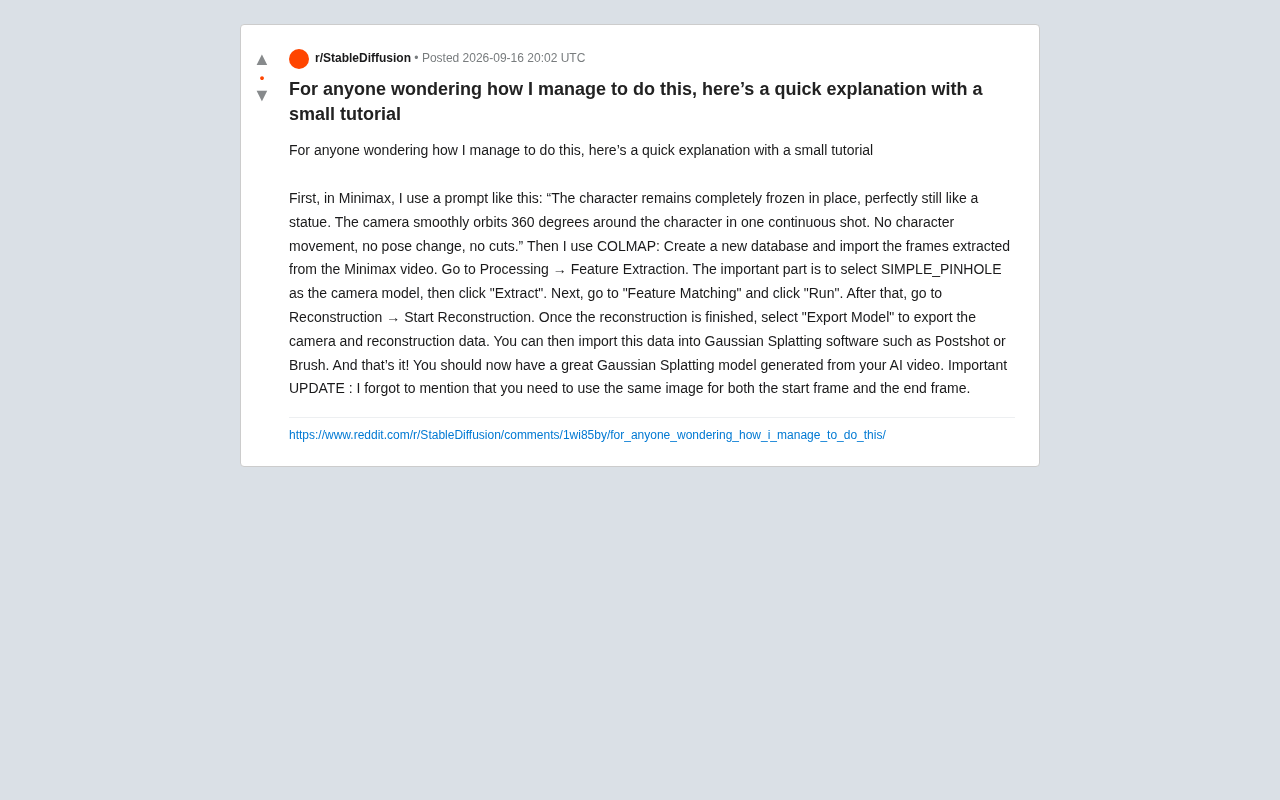
用AI视频生成3D高斯泼溅模型:Minimax+COLMAP实战教程
一份实用教程:如何用AI视频生成工具Minimax拍摄360度环绕镜头,配合开源工具COLMAP进行相机位姿估计,最终生成高斯泼溅3D模型。含完整提示词、COLMAP参数设置与关键操作细节。