Harness Engineering 实战:从零搭建AI编程的驾驭层
Harness Engineering通过信息层、约束层、自动化层三层结构,让AI编程Agent在真实项目中稳定可控地持续输出。
本文介绍了一门讲解"Harness Engineering(驾驭工程)"的课程,核心主题是如何在AI编程Agent外部搭建一套完整的工作环境,解决Agent在真实项目中连续改动时容易出现的跑偏问题。文章将AI工程实践划分为提示工程、上下文工程、驾驭工程三个演进阶段,重点指出真实项目的痛点不在于单次回答质量,而在于长周期多轮修改中的累积漂移。Harness的核心结构分三层:信息层让Agent看懂项目结构,约束层通过显式声明防止越界改动,自动化层负责验证与修正形成闭环。课程以Java项目为载体展示完整实战流程,最终给出落地清单与踩坑复盘,强调把重复出现的错误沉淀回环境本身,比靠模型能力或提示技巧更根本地解决问题。
Harness Engineering 实战:从零搭建AI编程的驾驭层
让 AI 帮忙写代码这件事,大多数人卡在同一道坎上:单次问答看着挺聪明,一旦让它连续改一个真实项目,就开始跑偏——改了你没让它改的文件、删掉你不想删的逻辑、信誓旦旦说"已完成"但根本跑不起来。B 站这门 Harness Engineering 教程讲的正是怎么解决这道坎:不是把提示词写得更花哨,而是在 Agent 外面搭一整套环境,让它看得懂项目、守得住边界、干完能自检。
什么是 Harness Engineering
Harness 这个词在软件工程里本来就有传统含义——测试脚手架,指包裹在被测代码外面、负责喂输入和验输出的那一层结构。放到 AI 编程语境里,它指的是围绕编码 Agent 搭建的完整工作环境:项目结构怎么呈现给它、约束规则在哪里声明、它改完之后由谁验证、验证失败之后怎么回到修正环节。
视频里把它对应为"驾驭工程",这个译法抓住了重点。harness 既不是某个具体工具,也不是一份更长的提示词。提示词决定 Agent 这一次说什么,harness 决定 Agent 在整个项目周期里能看到什么、被允许做什么、以及做错了靠什么被发现。前者是一次性的,后者是可持续运行的。
从历史渊源看,测试 harness(测试脚手架)的概念最早出现在单元测试和集成测试领域,用来描述一套驱动被测代码运行的辅助基础设施——它负责构造输入、触发执行、捕获输出并与预期值比对,本身不是业务代码的一部分,却决定了测试能否自动化运行。经典的 JUnit、pytest 框架都可以视为这种思想的具体实现。把这个概念迁移到 AI Agent 场景,隐喻非常精准:Agent 就是被"驾驭"的执行单元,harness 就是包裹在它外面、决定它能接触什么信息、按什么规则行动、输出经过什么验证的那套结构。这一类比也暗示了 Harness Engineering 的核心假设——Agent 本身不需要是完美的,只要外部结构足够健壮,系统整体依然可以稳定运行,就像写得不完美的代码也能被完善的测试套件兜住一样。
AI 工程范式的三次跃迁
课程把 AI 工程实践分成了三个阶段,这个划分比单纯罗列工具要好用得多:
提示工程(Prompt Engineering) 关注单次交互的措辞,琢磨怎么问才能让模型答得准。
上下文工程(Context Engineering) 关注喂给模型的信息本身——哪些文件该塞进窗口、哪些历史该截断、检索回来的内容怎么排序。
驾驭工程(Harness Engineering) 关注的是把这些拼起来之后,整个闭环能不能稳定运转。
前两个阶段在回答"模型这一次答得好不好",第三个阶段在回答"模型连续做一百次修改,整体产出是否仍然可控"。真实项目里让人头疼的从来不是单点质量,而是累积漂移。
上下文工程(Context Engineering)这一概念近年被 Andrej Karpathy 等人明确提出并广泛引用,核心观点是:对现代大语言模型而言,决定输出质量的关键已经不是提示词的措辞技巧,而是送入上下文窗口的信息质量与组织方式——包括哪些文档被检索进来、对话历史如何裁剪、工具调用结果如何格式化呈现等。RAG(检索增强生成)本质上就是一种上下文工程实践。在 Agent 场景下,上下文工程的复杂度进一步上升,因为 Agent 在多轮执行中会不断产生新的中间状态,如何管理这些状态使其不超出窗口、不引入噪声,本身就是一道工程题。Harness Engineering 在这个基础上再向前一步,关注的是整个执行循环的架构,而非单次上下文的组装。
Agent 为什么总是跑偏
课程专门用一节讲 Agent 的常见失败模式,这部分的工程价值最高,因为每一种失败都对应着 harness 里的一块结构:
- 方向偏移:Agent 自作主张扩大改动范围,顺手重构了它不该碰的模块。
- 上下文缺失:Agent 没看到某个约定或历史决策,于是重复造轮子或推翻已有设计。
- 幻觉式声称完成:代码写完了但没有编译、没有测试,报告里却是"全部完成"。
- 无法自证:产出缺少可验证的判据,人只能一行行读代码来判断对错。
这些问题的共同点是——它们都不是模型能力不足造成的,而是环境没有给它提供判断依据。
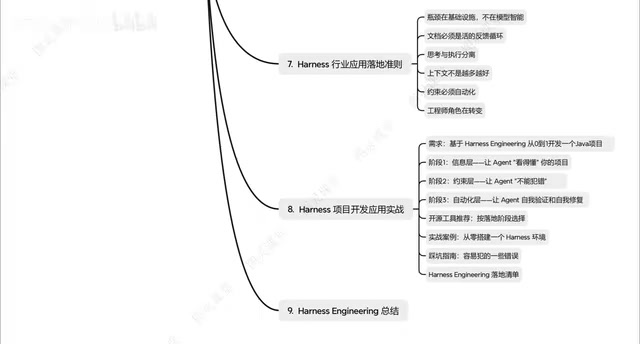
Harness 的核心组件:三个层次
课程给出的结构大体分三层,逻辑上是递进的:
信息层,解决"让 Agent 看懂项目"。项目怎么组织、模块之间什么关系、关键约定写在哪里,这些要让 Agent 在不问人的情况下自己摸清。
约束层,解决"让 Agent 不能犯错"。把不该动的边界、必须遵守的规范显式声明出来,而不是指望模型自觉。这一层是防止改动范围失控的主要手段。
自动化层,解决"改完谁来验收"。开发完成后由 Agent 自己跑验证,发现问题回到修正环节。这一层决定了整套流程是能自转,还是每走一步都要人来搓一遍。
三层合起来,才构成一个能连续工作的循环。只做信息层,Agent 会看懂项目然后乱改;只做约束层,Agent 会守规矩但干不出活。
自动化层在实践中通常依托 CI/CD 基础设施或本地脚本实现。Agent 完成代码修改后,触发一条预定义的验证管道:先运行编译器检查语法正确性,再执行单元测试套件,最后可选地运行静态分析或代码规范检查。任何一个环节失败,其错误输出会被结构化地反馈给 Agent,作为下一轮修正的输入。这与持续集成(CI)的理念高度吻合——区别在于传统 CI 的反馈对象是人类开发者,而这里的反馈对象是 Agent 本身。这种设计使"人在回路"(human-in-the-loop)成为可选项而非必选项:人只需要在 Agent 多次修正仍无法通过验证时介入,而不是每次改动后都要手动审查。这也是整套 Harness 实现"可持续运行"的关键机制。
从别人的最佳实践里提炼准则
课程提到了 OpenAI 等团队在工程化方向上的一些公开实践,也提到另一家头部 AI 团队的做法。它们的路径不完全一样,但抽象出来有几条共同经验值得记住:
- 把约束写成项目里的显式文件,而不是聊天记录里的口头约定——聊天会丢,文件不会。
- 让 Agent 拿到可执行的验证手段,测试和类型检查比"你觉得对不对"可靠得多。
- 每个环节的输出要有明确的完成判据,避免"看起来做完了"。
- 把重复出现的错误沉淀回环境本身,而不是每次靠人工纠正。
理解了这些准则,才能谈落地。课程的说法是:掌握准则之后,再把它整合进自己的项目开发流程里。
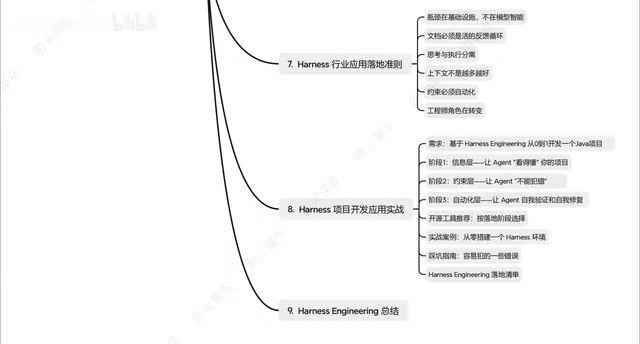
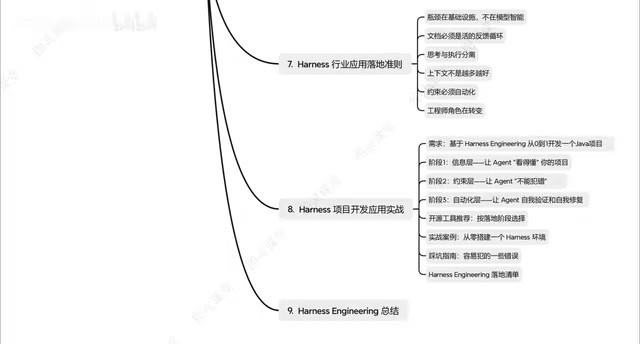
实战部分:从零搭一个 Java 项目
课程的实战环节选择用 Java 语言,从零到一搭建一套 Harness 开发环境,目标是跑通"只描述需求、基本不手写代码"的完整流程。这个选型挺务实——Java 项目结构和构建工具链相对规范,验证手段(编译、测试框架)成熟,正好能把自动化层的作用放大出来。
实战按照前面讲的层次推进:先让 Agent 建立对项目的理解,再落下约束规则,最后接上自动验证和修正。过程中课程还会横向对比主流 AI 编程工具,说明在不同阶段该选哪一个——这个视角比单纯推荐某个工具更有参考价值,因为工具的好坏高度依赖你处在流程的哪一环。
落地清单与踩坑总结
课程最后收在两部分内容上:一是项目做完后的复盘,总结容易犯的错和常见的坑;二是整理出一份 Harness Engineering 落地清单,把整套流程拆成可逐项检查的条目。
对准备动手的人来说,清单比分步教程更实用。教程只能复现一条路径,清单可以套用到自己的项目上。而复盘的价值在于——踩过的坑往往不是模型的问题,是环境设计漏了一环。
说到底,Harness Engineering 讨论的是一个工程问题,不是提示技巧问题。模型会持续变强,但"让一个能自主行动的 Agent 稳定产出可用代码"这件事,靠的始终是环境设计:它能看到什么、被限制在什么范围、以及做错了由谁来发现。把这三件事想清楚,比追任何一个新工具都管用。
落地清单这一形式在软件工程领域有其方法论依据。飞行员使用检查清单的研究表明,即便是经验丰富的专家,在高复杂度、多步骤的任务中,系统性的逐项核查仍能显著降低遗漏率。将 Harness 的搭建过程拆解为可独立验证的条目,还有助于团队协作:不同成员负责不同层次的搭建时,清单提供了共同的验收标准,减少"我以为你做了"的沟通成本。对于 AI Agent 项目而言,这一点尤为重要——环境设计的遗漏往往不会立即暴露,而是在 Agent 积累了若干轮错误行为后才变得明显,此时回溯根因的代价已经很高。提前用清单做结构性检查,是在源头控制这类累积风险的有效手段。
相关推荐
走进Anthropic分子生物学实验室:Claude如何成为科研协作者
Anthropic公开其分子生物学实验室,展示Claude如何作为科研协作者辅助蛋白质研究。本文解读AI在充满不确定性的生物学中扮演的角色,以及AI for Science趋势下的理性期待。
AI数据中心为何如此耗电?从GPU发热到核电站的能源困局
AI数据中心为何如此耗电?本文解析服务器机房运作、GPU散热难题、集成光子学节能方案,以及到2028年美国数据中心用电或相当于八个纽约市的能源困局与破局思路。
规范驱动开发:用Spec管住AI编程助手的失控
DeepLearning.AI与JetBrains合作的规范驱动开发(SDD)课程详解:如何用宪法与功能开发循环掌控AI编程助手,消除上下文衰减、降低认知债,覆盖绿地与棕地项目,并用技能、SpecKit、ACP等标准自动化工作流。