Harness架构详解:智能体开发的新范式
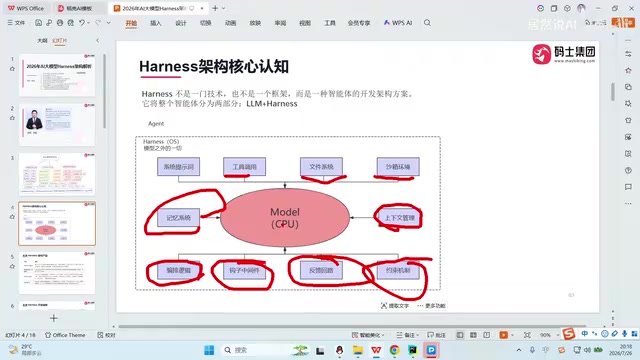
Harness架构是让AI智能体稳定可控运行的工程化设计思想,整合了提示词工程与上下文工程的全部能力。
Harness架构是近期AI智能体开发领域的热门概念,其本质是一种架构设计思想而非具体技术或框架。它将智能体拆分为"大模型(CPU)+ Harness(操作系统)"两层:模型负责推理,Harness负责调度、执行、纠错与恢复。该架构因Claude Code等主流产品的采用而走红,最初源于Claude Code源码泄露后被社区改写为Python版本并广泛流传。从技术演进看,Harness是提示词工程→上下文工程→Harness架构这条递进路线的最新阶段,整合了前两者的全部能力。它真正的价值在于工业级复杂任务场景,如涉及多数据源、多维度分析、多格式输出的企业采购分析,而简单问题无需引入这套架构。厘清Harness与工具平台(Dify)、通用智能体(Claude Code)、开发框架(LangChain)等概念的区别,是入门的必要前提。
什么是Harness架构
Harness架构最近在AI智能体开发圈子里被频繁提及,但它常常被误解。一个关键认知需要先厘清:Harness既不是一门具体技术,也不是某个框架,而是一种智能体开发的架构方案或设计思想。它的核心目标是把智能体的行为"控制住",让其在复杂任务中保持稳定、可纠正、可恢复。
这套架构对智能体做了一个经典的拆分:Harness + 大模型(LLM)。如果把智能体比作一台电脑,那么大模型就是负责思考的CPU,其他所有部分都可以理解为外设;而Harness则相当于操作系统,负责调度、执行、纠正和恢复。这种类比虽然朴素,却精准地抓住了两者的分工关系——模型负责推理,Harness负责工程化的运行保障。
展开来看,一个完整的Harness架构通常包含系统提示词、工具调用、文件系统与沙箱环境(两者紧密关联)、上下文管理及配套的记忆系统、智能体的编排逻辑、钩子与中间件、反馈回路以及约束机制。听起来组件繁多,但本质并不复杂:做一个agent时,尽量把这些能力都配齐,并据此划分目录层级和功能模块,而不是把所有逻辑塞进两三个类里,这样就算符合了Harness架构的思路。
Harness架构为什么火了
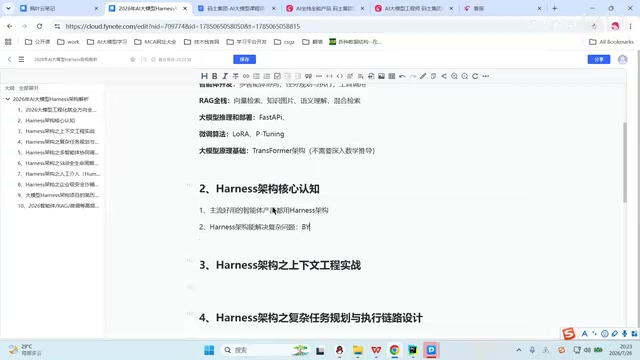
Harness架构走红的第一个原因很直接:主流且好用的智能体产品几乎都采用了这种架构。无论是Claude Code这类编程工具,还是Codex、以及一批新出的通用型智能体,底层设计思想都指向Harness。
据UP主介绍,这套架构最早的传播源头颇具戏剧性——它源自Claude Code源码泄露事件。泄露之后,社区将其改写成Python版本并在GitHub上广泛流传,开发者们由此发现:要做好一个Web Coding(代码编写)工具,如果用上Harness架构,智能体会明显更"聪明",能够解决相当复杂的编程方案。产品层面的成功验证,是Harness架构获得广泛认同的现实基础。
第二个原因在于它能解决复杂问题。简单问题——比如"明天天气怎么样""帮我打开一个文件"——一句话就能搞定,根本不需要Harness架构。真正的价值体现在工业级复杂场景中。
复杂问题为何需要Harness
视频中用了一个贴切的例子:假设为比亚迪(BYD)的采购部门做一个智能体,需求是对比两款零配件并生成采购分析。这样一个看似普通的任务,实际会牵扯出多个维度的复杂性。
具体来说,这类任务必然涉及多数据源、多分析维度、多输出格式。智能体需要从不同来源拉取数据,按多个维度做对比分析,最终以不同格式输出结果。这种多环节、多步骤的调度需求,恰恰是单纯依赖提示词或简单调用无法胜任的,必须由Harness架构来统一编排和调度。
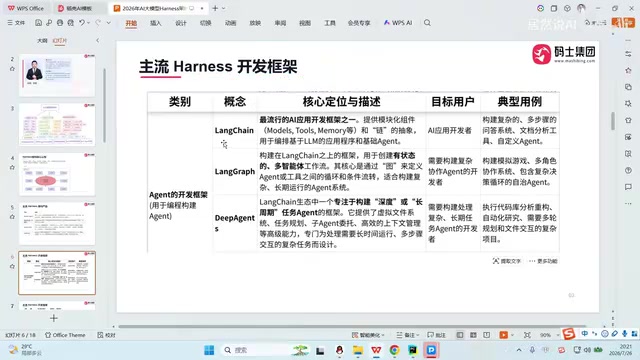
在开发框架选择上,视频作者明确聚焦Python生态,理由是Python目前是企业级Agent开发的主流选择,Java等语言在这一领域要么显得陈旧,要么功能受限。具体提到的框架包括LangChain、LangGraph,以及被称为高度符合Harness架构思想的Deep Agents。
从提示词工程到Harness的演进
理解Harness架构,需要放到智能体开发的演进脉络中看。作者梳理出一条清晰的技术递进线索:
- 提示词工程阶段:让大模型听懂你要干什么,通过精细拆解的提示词与模型对话。但很快遇到瓶颈——提示词过长会超出模型上下文长度,难以为继。
- 上下文工程阶段:核心是在合适的时机给模型提供正确的上下文。就像与人讨论问题不能一口气讲一小时,而要多轮对话、逐步给信息。RAG(检索增强生成)就是典型的上下文工程实践,涉及上下文摘要、上下文裁剪等技术。
- Harness架构阶段:解决的是如何持久、持续、可观测、可纠错、可恢复地运行模型。
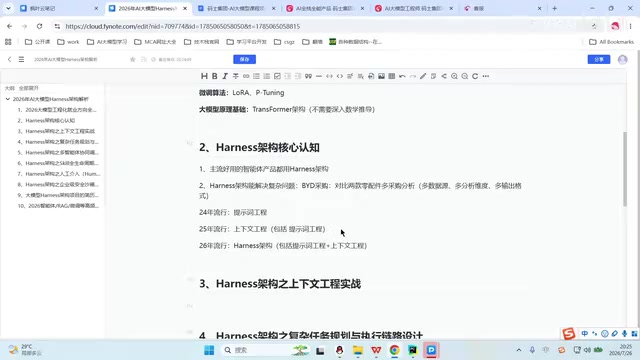
这三者是层层递进的包含关系:上下文工程包含提示词工程,Harness架构又整合了前两者的能力。正因如此,作者给出一个直接建议:现在只需学Harness架构即可,因为它已经把前面这些能力全部整合进来,不必再单独从提示词工程、上下文工程学起。
RAG(Retrieval-Augmented Generation,检索增强生成)是上下文工程阶段的代表性技术。其核心思路是:不把所有知识塞进提示词或模型权重,而是在推理时动态检索外部知识库,将相关片段拼接到上下文中一并送给模型。这样既绕开了上下文长度限制,又避免了模型"幻觉"(对未知问题凭空捏造答案)的问题。常见实现方式是将文档切片后向量化存入向量数据库,查询时通过语义相似度召回最相关的片段。上下文摘要(对历史对话压缩提炼)和上下文裁剪(丢弃低相关性内容)则进一步控制送入模型的token量,使多轮长对话成为可能。Harness架构在此基础上更进一步,将这些检索与管理能力封装为可调度的模块,使智能体能在任务执行中按需触发检索,而非由开发者手动拼装。
厘清相关概念
大模型领域的术语容易混淆,作者顺带做了概念澄清,对写简历、做技术选型都有参考价值:
- 工具/平台类:如Dify,是可拖拽、可视化、便于做原型的低代码工具,N8N、Coze等也属此类,可理解为AI大模型工具平台。
- 通用型智能体:如Claude Code等Web Coding工具,本质是应用软件,可直接理解为一个智能体。
- 框架:如LangChain、LangGraph,Java阵营的Spring AI,以及高度契合Harness架构的Deep Agents,后者更像一套代码规范。
把这些专有名词区分清楚,是避免概念混乱的第一步。对于刚接触大模型的开发者而言,先建立起"技术方案 / 工具平台 / 通用智能体 / 开发框架"的清晰分层,再去实操Harness架构,能少走不少弯路。
LangChain与LangGraph是目前Python生态中最主流的两个智能体开发框架,两者关系密切但定位不同。LangChain提供链式调用、工具集成、记忆管理等基础抽象,适合快速搭建单轮或简单多步的智能体流程;LangGraph则在LangChain之上引入有向图(DAG/循环图)结构,允许开发者将智能体的执行流程建模为节点与边,支持条件分支、循环重试和多智能体协作,更适合复杂任务编排。Deep Agents被作者描述为"高度符合Harness架构思想"且"更像一套代码规范",其设计理念与Harness的模块化分层高度吻合,对于希望按Harness架构组织项目目录与功能模块的开发者而言,参考价值较高。选型时的实用原则是:原型验证用低代码平台(Dify/Coze),工程化落地用框架(LangGraph/Deep Agents),两者不必非此即彼。
相关推荐
AI早报:千问全模态Qwen3-Omni发布,华为昇腾960与Grok新模型齐现身
9月18日AI早报:千问推出原生全模态模型Qwen3-Omni Flash,音视频成本降超93%;华为披露百万级处理器计算架构并传昇腾960将发布;Grok新版现身谷歌云,OpenAI推ChatGPT for Word,N8N爆满分漏洞。
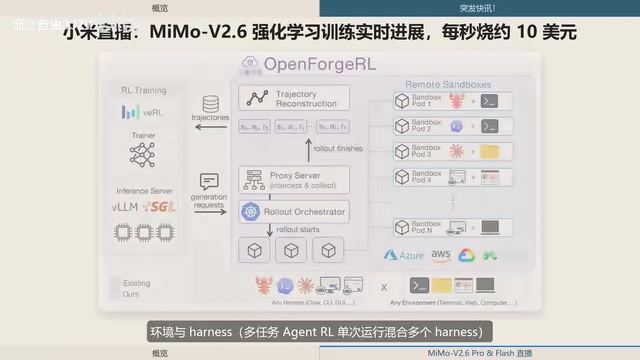
小米MiMo-V2.6直播训练:一天半烧850万,每秒约10美元
小米MiMo大模型团队直播MiMo-V2.6 Pro/Flash的强化学习训练过程,一天半已花费约855万人民币,每秒烧约10美元。本文解析其三方向算力扩展路径、开源计划与DeepSWE基准跑分对比。
字节Trae Work上手指南:11个应用场景解析
字节通用AI agent产品Trae Work上手指南,详解Work、Code、Design三大板块及PPT生成、数据分析、深度研究、代码开发等11个应用场景,帮零代码用户快速判断如何用它解决实际问题。