花哨提示词不影响小模型,唯格式行决定成败

测试表明本地小模型的提示词措辞风格几乎不影响准确率,真正决定成败的是格式行指令。
一项针对8个本地模型、超过5000次调用的系统测试,检验了朴素、正常、华丽三种提示风格的差异。结果显示:在40个非数学任务中,8B以上模型对风格差异的反应不超过4个百分点;4B以下模型则是"正常"风格略优,朴素和华丽都掉约8分。数学任务波动高达30分,但根源并非措辞难懂,而是格式行——华丽措辞让模型更严格地遵守"只给数字",从而停止写出推理步骤,正确率从79%骤降至11%。统一格式行后,问题文本的风格差异最多只造成5分波动。此外,华丽词汇还可能引入语义歧义,例如将"客户名"理解成公司名。作者建议:不必追求华丽表达,也不要刻意给小模型降智,应把精力放在格式行与任务结构上。
给LLM写提示词时,很多人会习惯性地加上一堆修饰语,试图让指令显得更"专业"。但对参数量较小的本地模型来说,这些华丽辞藻真的有用吗?一项针对8个本地模型、超过5000次调用的系统测试给出了否定的答案:华丽的表达方式几乎不影响模型表现,真正决定输出质量的是那行告诉模型如何格式化答案的指令。
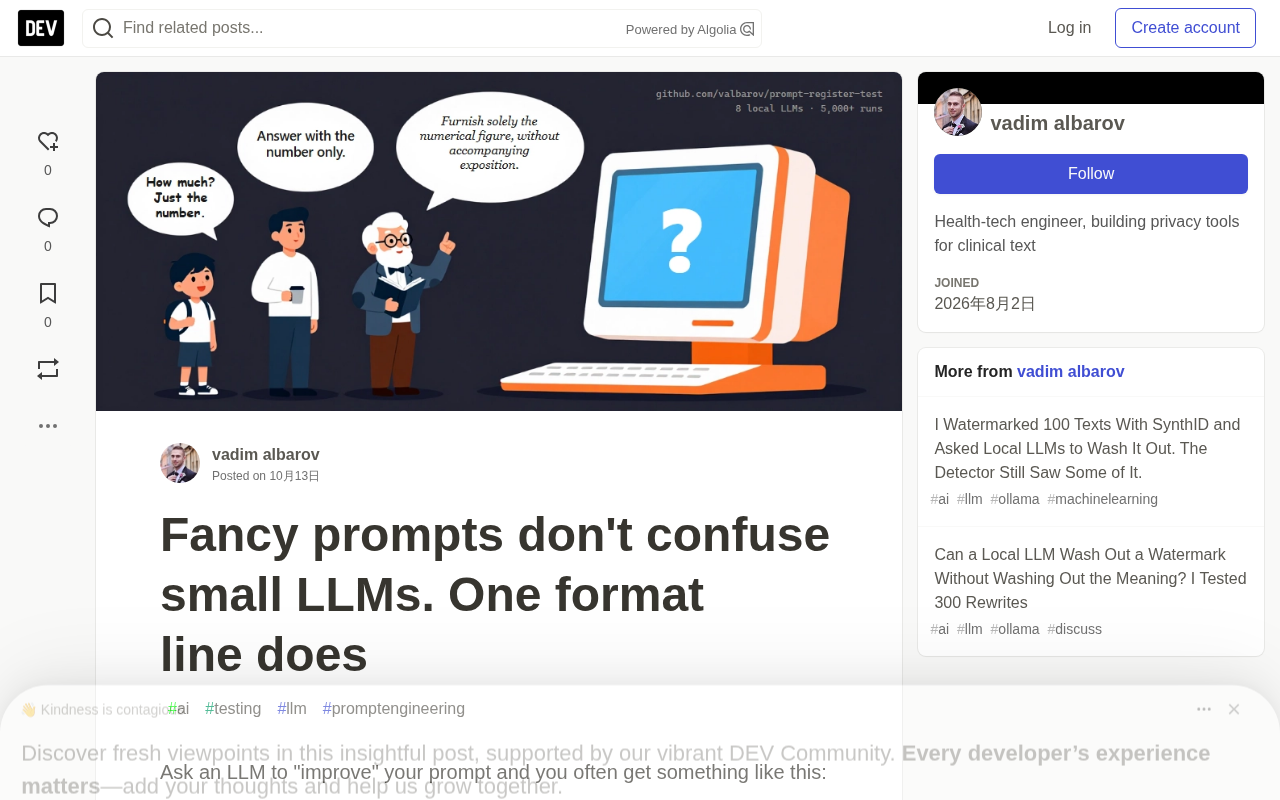
测试设计:从简单到华丽的三种提示风格
测试者设计了50个可自动校验的任务,分为五类:数学多步计算题、从订单备注中提取JSON、分类支持工单、条件过滤并排序、以及有严格格式要求的写作任务。每类10题,每题都有标准答案。
每个任务被改写成三个版本,事实、数字、条件完全一致,只有措辞不同。以"只给出数字"这个指令为例:
| 风格 | 示例 | 阅读年级 | 平均句长 | 9字母以上词汇占比 |
|---|---|---|---|---|
| 朴素 | Give only the number. | 4.1 | 9.8词 | 1% |
| 正常 | Answer with the number only. | 8.3 | 12.3词 | 4% |
| 华丽 | Furnish solely the numerical figure, without accompanying exposition. | 17.9 | 22.6词 | 26% |
测试覆盖8个本地模型:Qwen3的0.6B、1.7B、4B、8B、14B,以及Gemma3的1B、4B、12B,全部通过Ollama部署且关闭思考模式。每个提示词运行3次固定随机种子,主实验共3600次调用,数学补充实验再加1440次。
结论一:非数学任务中,措辞风格几乎无影响
在40个非数学任务中,模型的正确率表现如何?从数据来看,8B及以上的模型对三种风格的反应差异均不超过4个百分点。即使是用23词长句写成的华丽英文,也没有对它们造成困扰。
但在4B及以下的模型上出现了一个值得关注的模式:正常风格的得分最高,而朴素和华丽两种风格都掉了约8分。不过所有置信区间都跨越零,因此这个差异无法被严格证明为显著,只能算是一个趋势信号。
这提示了一个反直觉的现象:对小模型而言,用非常简单的语言(短句、低阅读年级)并不比正常语言更安全。测试者分析,原因可能在于朴素版本的提示词把事实分散到了更多短句中,小模型需要额外做信息整合的工作。
结论二:数学任务波动30分,问题出在推理被抑制
数学任务的结果看似惊人:朴素风格28%、正常风格34%、华丽风格仅18%。Qwen3 4B-instruct在正常风格下得分93%,切换到华丽风格后骤降至43%。
但深入分析回复内容后,原因浮出水面。当模型写出推理步骤时,正确率为79%;当它只给一个裸数字时,正确率仅11%。由于测试关闭了思考模式,写出步骤本身就是模型的"思考过程"。
而格式行直接决定了模型写步骤的频率:正常格式行"Answer with the number only"导致37%的回复展示了推理过程,朴素版本为27%,华丽版本仅8%。华丽措辞并没有让模型"看不懂",恰恰相反,模型更严格地遵守了它,从而停止推理直接猜测答案。
为分离两个变量的影响,测试者将所有版本的最后一行统一:
- 使用各自的格式行:朴素28%、正常34%、华丽18%
- 统一为"Answer with the number only":37%、35%、40%
- 统一为"Work it out step by step, then write the final number":84%、83%、79%
统一最后一行后,问题文本的风格差异最多造成5分的波动;而改变格式行则带来45分的差距。
一个更极端的例子来自Qwen3 1.7B:"Give only the number"让它展示推理的比例为17%,而"Answer with the number only"则达到80%。几乎相同的含义,截然不同的行为。
什么是"思考模式"(thinking mode)? 以 Qwen3 为代表的新一代模型支持在正式作答前生成一段"思考链"——模型先输出内部的推理过程(通常包裹在特定标签中),再给出最终答案。这一机制通过额外的强化学习训练实现,开启后能显著提升数学、逻辑等复杂任务的表现。本文测试统一关闭了思考模式,目的是观察模型在"正常对话"状态下的行为。关键区别在于:思考模式是模型内部的、被专门训练过的推理通道;而本文所说的"写出推理步骤",是模型在普通回复中自发地把计算过程写出来,属于一种"外显推理"。两者机制不同,但效果有相通之处——都会增加模型实际执行的计算量。正因如此,关闭思考模式后,模型是否愿意在正文里写出步骤,就成了决定数学正确率的关键变量。
结论三:华丽词汇可能悄悄改变问题含义
一个客户信息提取任务中,订单备注开头是:"Hi, this is Laura Becker from Becker Design. We'd like 12 desk lamps..."
- 朴素提示("the name of the customer"):88%回答Laura Becker
- 正常提示("customer name"):96%
- 华丽提示("the appellation of the commissioning customer"):仅25%,大多数模型回答Becker Design
这未必是"错误答案"。"委托客户"确实可以理解为公司实体。华丽措辞让问题变得模糊,模型选择了另一种合理理解。测试者用Claude检查三种版本的语义一致性时,这个歧义也未被标记出来。
这正是LLM改写提示词时的核心风险:每个华丽词汇都是一次语义漂移的小概率事件。
熟悉度理论的验证与修正
一个自然假设是:指令微调数据以普通直白的英语为主,所以"正常"风格对模型最熟悉,过于简单或过于华丽都偏离了训练分布。小模型处理不熟悉输入的能力更差,这能解释为何4B以下模型在正常风格上表现最好。
测试者用困惑度验证了这个假设。华丽风格的困惑度约为正常风格的两倍(Qwen3 0.6B:37.2 vs 16.7),确实"看起来更陌生"。但朴素风格和正常风格的困惑度几乎相同(15.6 vs 16.7),小模型却在朴素风格上表现更差,说明"熟悉度"不是全部原因。
更关键的是,将困惑度与逐题正确率关联后发现,非数学任务中两者关系微弱(r在-0.15到0.08之间),无法与零区分。
修正后的解释是:华丽英文虽然陌生但模型仍能理解,不熟悉的词汇本身几乎不损害准确率;朴素风格的问题在于结构,将任务拆成更多短句后,小模型需要额外做信息拼接。真正重要的不是用哪些词,而是任务如何组织,以及模型如何严格遵守格式行。
困惑度(perplexity)是什么? 它是衡量语言模型对一段文本"意外程度"的指标:模型对下一个词的预测越不确定,困惑度就越高。可以粗略理解为"这段文字看起来有多陌生"。训练分布内的常见表达困惑度低,生僻或别扭的措辞困惑度高。困惑度因此常被用来检验"模型是否见过类似表达"。但本文的发现提醒我们,困惑度低并不等于任务表现好——它只反映词汇和语法的熟悉程度,并不衡量句子的信息结构是否便于模型整合。朴素提示与正常提示的困惑度几乎相同,小模型却表现更差,说明真正的瓶颈在任务的组织方式,而非表面上的"陌生感"。
对提示词工程的启示
这项测试给出了几条务实建议:
不要费心把提示词改写成华丽英文。 不仅没有帮助,还可能改变原本的语义。
也不要刻意给小模型"降智"。 正常直白的英语表现不比任何风格差,在4B以下甚至略优。
把精力放在格式行上。 对没有思考模式的模型说"只给数字",等于让它猜。如果需要正确的数值答案,就让它展示推理过程,然后读最后一行。
LLM改写过的提示词要仔细审查。 特别留意可能有两种理解的词汇,每个这样的词都是一次潜在的语义偏移。
局限性与注意事项
50个任务、每个提示词3次试验的规模有限。风格版本由一人(借助LLM辅助)撰写,换一个作者的"华丽"可能难度不同。华丽版本比正常版本更长,长度和风格存在部分混淆。测试仅限英语和14B以下的本地模型,前沿模型未纳入本轮测试。困惑度检查只覆盖了三个较小的Qwen模型,且使用全精度权重,而实际运行使用Ollama的4位量化版本。关于"结构"的解释是测试者的最佳推断,并非实验直接隔离出来的变量。
4位量化(quantization)意味着什么? 原始模型权重通常以16位浮点数存储,每个参数占2字节;4位量化把每个参数压缩到约0.5字节,可将显存占用和运行成本降低数倍,代价是引入少量数值误差。本文的困惑度检查用的是全精度权重,而实际推理通过 Ollama 以4位量化运行。量化可能轻微改变模型行为,尤其是对提示格式的敏感度——因此困惑度结论能否直接外推到量化模型上,仍需谨慎对待。这也是作者将此列为局限之一的原因。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。