混合架构中的竞争学习:揭开循环与注意力的博弈

揭示混合架构中循环层与注意力层的竞争学习现象,并提出分阶段训练策略加以缓解。
本文研究线性循环与softmax注意力构成的混合架构中一个被忽视的训练动态问题:两类混合器会竞争学习相同的检索函数。层归因分析表明,循环层学习检索的速度快于注意力层,并在训练早期“抢跑”成功,从而抑制注意力层学习检索的信号,导致混合架构整体性能受损。作者提出分阶段训练策略——在训练中期冻结循环层权重,仅更新注意力层及其他部分,为注意力层创造学习空间。在高达10亿参数的模型上,该方法在语言建模损失、常识推理和检索相关任务上均取得显著提升,且不增加参数量或推理成本,具有较高实用价值。
引言:混合架构的崛起与隐忧
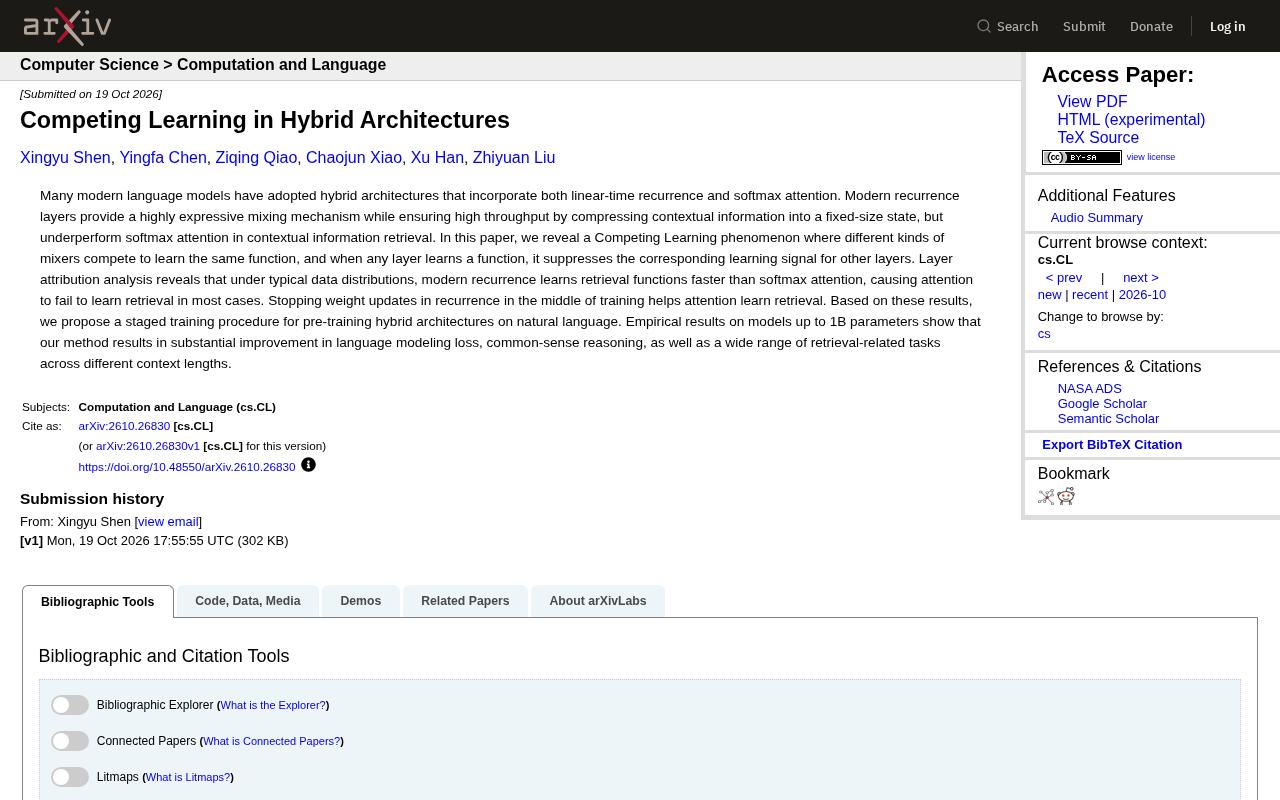
近年来,大型语言模型的设计逐渐从单一的Transformer架构转向混合架构——结合线性时间循环(linear-time recurrence)与softmax注意力。循环层通过将上下文压缩为固定大小的状态,提供了高度表达力的混合机制,并保证了高吞吐量;而softmax注意力则在上下文检索(contextual retrieval)任务上表现更优。然而,这种混合设计背后隐藏着一个关键矛盾:不同种类的混合器(mixer)会竞争学习相同的函数,一旦某一层学会了某个函数,就会抑制其他层对应的学习信号。这篇论文揭示了这一“竞争学习”(Competing Learning)现象,并提出了一种分阶段训练策略来缓解该问题。
线性时间循环(linear-time recurrence)与softmax注意力的区别:线性时间循环层(如Mamba、RWKV中的循环机制)在推理时以O(1)的每token状态更新复杂度运行,将历史上下文压缩进一个固定维度的隐状态,因此具有恒定的内存占用和高吞吐量;但它对长距离精确检索的能力受限于状态容量。softmax注意力则保留全部历史token的键值对,通过查询-键相似度加权聚合,能精确回溯任意位置的信息,但计算与内存随上下文长度呈二次增长。混合架构将二者交替堆叠,试图兼得循环层的高效与注意力层的精确检索能力。理解这一权衡是把握本文“竞争学习”问题的前提:两类层在功能上存在重叠区间,谁先学会检索,谁就可能抑制对方的学习信号。
竞争学习:循环层如何“抢跑”注意力
论文通过层归因分析(layer attribution analysis)发现,在典型数据分布下,现代循环层学习检索函数的速度快于softmax注意力。这意味着,在训练早期,循环层迅速掌握了检索能力,并因此抑制了注意力层学习相同功能的信号。结果,注意力层在大多数情况下无法有效学习检索,导致混合架构的整体性能受损。
这种竞争现象并非偶然,而是源于两类混合器在优化动态上的差异。循环层由于参数更新路径更直接,能够更快地捕捉到数据中的检索模式;而注意力层则需要更复杂的交互才能学会相同的函数。一旦循环层“抢跑”成功,注意力层便失去了学习动力,形成了一种“赢者通吃”的局面。
层归因分析(layer attribution analysis):这是一种用于量化网络中每一层对最终输出贡献的技术。常见做法包括基于梯度的归因(如积分梯度)、激活 patching 或消融实验——即逐层屏蔽或替换某层输出,观察模型在特定任务(如上下文检索)上的性能变化。本文借助该方法定位到:在训练过程中,循环层对检索任务的归因分数迅速上升并占据主导,而注意力层的归因分数长期低迷。归因分析的价值在于它把“哪一层在学什么”从黑箱中部分剥离出来,使“竞争学习”从推测变为可观测的现象,也为后续分阶段训练提供了干预依据。
分阶段训练:让注意力也有机会学习
基于上述发现,论文提出了一种简单而有效的解决方案:在训练过程中,中期停止循环层的权重更新。这样,循环层不再继续“霸占”学习信号,注意力层得以在后续训练中逐渐学会检索函数。具体来说,训练分为两个阶段:第一阶段正常训练所有层,让循环层快速掌握检索;第二阶段冻结循环层的权重,仅更新注意力层及其他部分,从而为注意力层创造学习空间。
这种分阶段训练策略在自然语言预训练任务上进行了验证。实验使用了高达10亿参数的模型,结果表明,该方法在语言建模损失、常识推理以及多种检索相关任务上均带来了显著提升,且在不同上下文长度下均有效。
权重冻结(weight freezing)与训练调度:冻结权重是指在训练某阶段将部分参数的 requires_grad 设为 False,使其不接收梯度更新。本文的策略并非永久冻结,而是在训练中期临时冻结循环层,让注意力层在剩余训练中获得独占的学习信号。这与常见的“先训主干再微调头”或“逐层解冻”不同:后者通常出于稳定性或迁移学习考虑,而此处冻结的目的是重新分配学习机会,解决层间对同一函数的竞争。该操作不改变模型结构,也不影响推理时的前向计算,因此部署成本为零;唯一需要调节的是冻结的起始时机与持续步数,论文通过消融实验说明了中期介入比全程冻结或晚期冻结更有效。
实验验证:显著提升多项任务表现
论文的实证结果覆盖了多个维度。在语言建模损失上,分阶段训练相比标准混合架构训练取得了更低的损失值;在常识推理任务(如HellaSwag、PIQA等)上,模型表现也更为优异;在检索相关任务(如问答、事实核查)中,改进尤为明显。这些提升在不同上下文长度下均保持一致,说明该方法具有较好的泛化能力。
说个细节,分阶段训练并未增加模型参数量或推理成本,仅在训练阶段引入了一个简单的权重更新暂停操作,因此具有较高的实用价值。
启示与展望:混合架构设计的新思路
这项研究揭示了混合架构中不同混合器之间的竞争关系,为理解模型训练动态提供了新视角。传统的训练方法默认所有层会协同学习,但竞争学习现象表明,层与层之间可能存在“零和博弈”。分阶段训练作为一种轻量级干预,能够有效缓解这一问题,提升混合架构的最终性能。
未来,这一思路或许可以扩展到更复杂的混合架构设计,例如动态调整不同层的更新节奏,或引入更精细的归因分析来指导训练策略。对于AI从业者而言,这意味着在采用混合架构时,需要关注层间竞争带来的潜在风险,并考虑通过训练调度来释放每个组件的潜力。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。