HybridAgent:混合推理智能体让AI思考效率提升2.6倍

Together Computer提出HybridAgent,让LLM智能体在隐空间推理与文本交互间动态切换,性能提升10.4%同时成本降低近4倍。
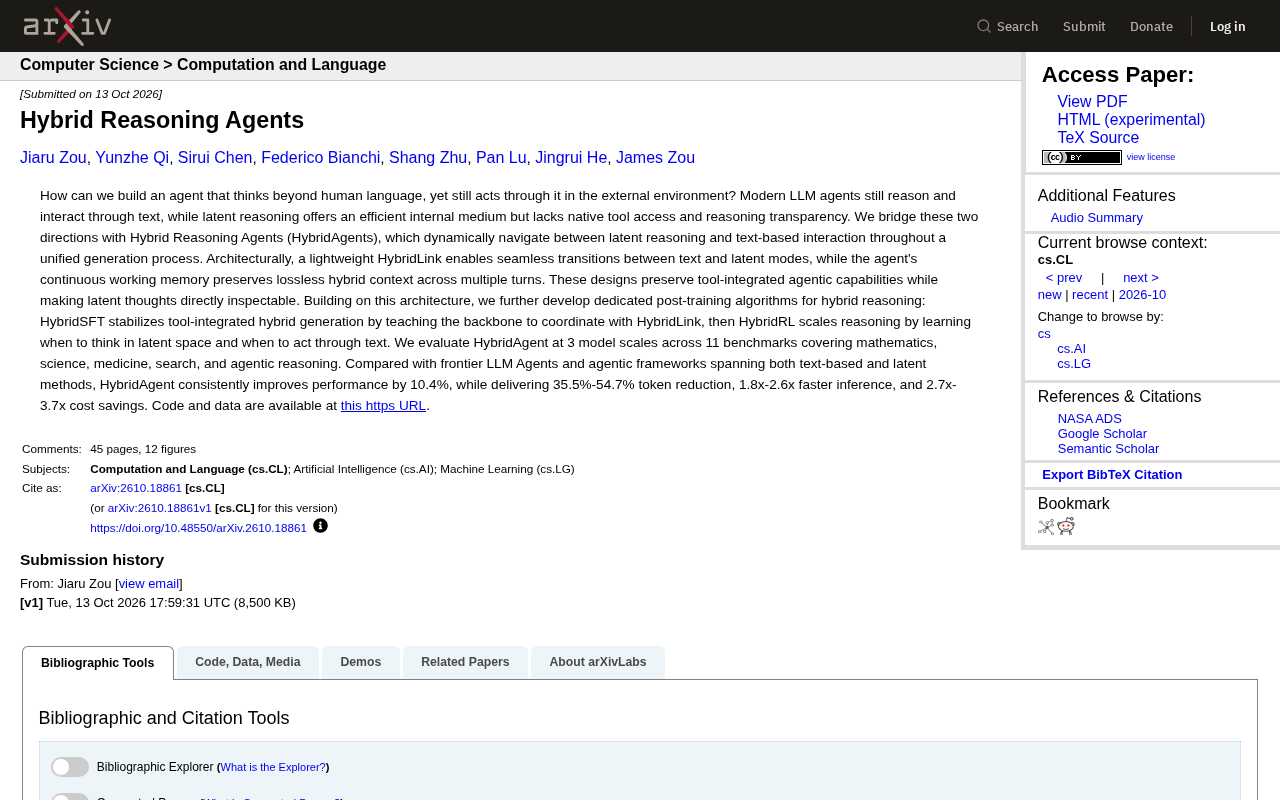
HybridAgent针对LLM智能体文本推理昂贵缓慢、隐空间推理封闭不可交互的根本矛盾,提出在统一生成过程中动态切换两种模式的混合架构。其核心组件HybridLink实现文本token与隐空间向量的无缝转换,连续工作记忆保证多轮交互中混合上下文的无损传递。训练上采用HybridSFT和HybridRL两阶段策略,前者协调基础模式切换,后者通过强化学习让模型自适应决定何时思考、何时行动。在3个模型规模、11个基准测试中,HybridAgent性能一致提升10.4%,token消耗减少35.5%-54.7%,推理速度提升1.8-2.6倍,成本降低2.7-3.7倍,证明效率与性能可以兼得。
大型语言模型智能体正在改变我们与AI协作的方式,但一个根本矛盾始终存在:模型需要用文字"思考",而文字推理既昂贵又缓慢。能否让AI在隐空间中高效思考,同时保留调用工具和与外界交互的能力?Together Computer提出的Hybrid Reasoning Agents(HybridAgent)给出了一个令人信服的答案。
文本推理的瓶颈与隐空间推理的困境
当前主流的LLM智能体几乎都依赖文本进行推理和交互。Chain-of-Thought让模型一步步写出思考过程,这种方式的好处是透明、可调试,也天然兼容工具调用。但代价同样明显:每个token都要经过完整的生成流程,推理链条越长,延迟和成本就越高。
另一条路径是隐空间推理——让模型在连续向量空间中完成思考,不生成中间文本。这种方法在效率上有天然优势,但问题也很突出:隐空间中的推理过程无法直接观察,模型也难以在中途调用外部工具或与环境交互。
HybridAgent的核心洞察在于:这两种方式并非非此即彼。如果能让模型在统一的生成过程中动态切换——需要深入思考时进入隐空间模式,需要调用工具或输出结果时回到文本模式——就能同时获得效率和能力。
Chain-of-Thought(思维链) 是2022年由Google Research提出的提示技术,核心思想是让模型在给出最终答案前显式写出中间推理步骤。这一方法在数学应用题、逻辑推理等任务上显著提升了准确率,原因是分步生成相当于把复杂问题分解为多个更简单的子问题,每一步的输出都作为下一步的上下文输入。此后发展出的Zero-shot CoT、Self-Consistency、Tree-of-Thought等变体进一步扩展了这一范式。CoT的透明性使其天然适合需要可审计性的场景,也使得工具调用可以在推理链的任意节点插入——模型只需在文本中生成调用指令即可。然而其代价在于:每一步推理都需经过完整的自回归解码流程,每个token都要过一遍完整的前向传播,推理链条越长,累积延迟和计算成本越不可忽视。
隐空间推理(latent space reasoning)指模型不生成离散文本token,而是在连续的隐向量空间中完成多步推理,仅在最后将结果解码为文本。代表性工作包括Coconut(Chain of Continuous Thought)等。其效率优势源于两点:一是跳过了逐token的自回归生成,二是在连续空间中单步可携带的信息量远大于单个token。但核心限制在于:连续向量无法直接映射回人类可读的文本,导致推理过程不可解释;同时,由于模型未生成文本形式的工具调用指令,外部工具无法在推理中途被触发。本质上,隐空间推理以牺牲透明性和交互性换取了计算效率,这正是混合方案试图解决的矛盾。
HybridLink如何打通两种推理模式
实现混合推理的关键技术挑战是:文本token和隐空间向量是两种完全不同的表示形式,模型如何在它们之间无缝切换?
HybridAgent的解决方案是一个轻量级的HybridLink模块。它充当文本模式和隐空间模式之间的"翻译器",让模型可以在生成过程中平滑地从一个模式过渡到另一个模式。更重要的是,智能体维护着一份连续的工作记忆(continuous working memory),能够在多轮交互中保持无损的混合上下文——无论是文本token还是隐空间向量,都不会在切换过程中丢失。
这个设计带来的直接好处是:隐空间中的"思考"变得可以直接检视。研究人员和开发者能够观察模型在隐空间中做了什么,这在此前的纯隐空间推理方法中是做不到的。同时,工具集成能力被完整保留——模型仍然可以在需要时调用搜索、计算器等外部工具。
连续工作记忆(continuous working memory)是HybridAgent在多轮交互中维持上下文一致性的核心机制。与传统智能体仅将历史文本token作为上下文不同,它同时存储文本token的嵌入表示和隐空间推理产生的连续向量,形成统一的混合表示序列。当模型在文本模式与隐空间模式之间切换时,工作记忆中的两种表示被拼接为完整的上下文供后续生成使用。这种设计的关键挑战在于:文本嵌入和隐空间向量可能处于不同的表示子空间,HybridLink需要将它们映射到兼容的空间中,否则模式切换会导致上下文语义断裂。工作记忆的无损性保证了模型在长程多轮交互中不会因为模式切换而丢失此前的推理状态。
从HybridSFT到HybridRL的训练策略
架构之外,HybridAgent还需要专门的训练方法来教会模型"何时思考、何时行动"。研究团队为此设计了两阶段的后训练流程。
HybridSFT(混合监督微调)解决的是基础协调问题:让骨干模型学会与HybridLink配合,稳定地生成混合推理轨迹。这个阶段确保模型不会在模式切换时"迷路"。
HybridRL(混合强化学习)则更进一步:通过强化学习,模型学会判断什么时候应该在隐空间中深入思考,什么时候应该通过文本与外部环境交互。这种自适应决策能力是HybridAgent区别于简单模式切换的关键——它不是按照固定规则切换,而是根据任务需求动态调整。
混合强化学习(HybridRL)在此处的核心任务是学习一个模式切换策略:在轨迹的每个决策点,模型需要判断当前应进入隐空间继续思考,还是输出文本以调用工具或给出答案。这一决策本质上是一个序列决策问题,适合用策略梯度方法优化。奖励信号通常来自任务完成质量(如答案正确性)与效率指标(如token消耗)的组合,使得模型在准确率和成本之间寻找平衡。与固定规则切换不同,HybridRL学到的策略是数据驱动的——模型通过试错发现某些任务模式(如多步数学推导)更适合隐空间思考,而需要外部信息检索的场景则必须切换到文本模式。这种自适应能力是混合架构从"能切换"到"切得对"的关键跃迁。
效率与性能的双重提升
研究团队在3个模型规模、11个基准测试上评估了HybridAgent,覆盖数学、科学、医学、搜索和智能体推理等场景。
结果值得关注:
- 相比前沿LLM Agent和智能体框架(包括纯文本和纯隐空间方法),HybridAgent性能一致提升10.4%
- Token消耗减少35.5%至54.7%
- 推理速度提升1.8倍至2.6倍
- 成本降低2.7倍至3.7倍
这组数据的意义在于,效率和性能不再是取舍关系。HybridAgent通过让模型在合适的场景使用合适的推理模式,同时实现了两者的提升。对于需要大量调用智能体的应用场景——比如自动化研究、复杂问题求解、多轮工具调用——这种改进直接转化为可观的成本节约和用户体验提升。
对智能体架构设计的启示
HybridAgent的工作指向一个更广泛的趋势:智能体的推理架构正在从"单一模式"走向"混合模式"。纯文本推理虽然通用但低效,纯隐空间推理虽然高效但封闭,而混合方案打开了新的设计空间。
这个方向还有不少值得探索的问题。比如,隐空间推理的可解释性虽然通过直接检视有所改善,但如何让人类真正理解隐空间中的推理逻辑仍是开放问题。再比如,HybridRL学到的"何时思考"策略是否能泛化到训练分布之外的场景,也需要进一步验证。
代码和数据已在GitHub开源,对于正在构建智能体系统的开发者和研究者来说,这是一个值得深入研究的架构范式。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。