Java程序员转型AI开发:Spring AI与RAG实战指南

Java程序员的AI机遇:不换语言也能做AI开发
在AI大模型浪潮席卷整个技术行业的当下,Python几乎垄断了AI开发的话语权。然而,对于数量庞大的Java开发者群体而言,是否必须"转语言"才能拥抱AI?答案是否定的。
B站UP主"波哥"近期推出了一套面向Java开发者的AI大模型应用开发系列课程,涵盖Spring AI、Langchain4j、RAG等核心技术栈。这套课程的核心价值在于——它为Java程序员提供了一条无需切换技术栈即可进入AI应用开发领域的路径。本文将梳理这套课程的核心知识框架,帮助Java开发者快速建立AI应用开发的全景认知。
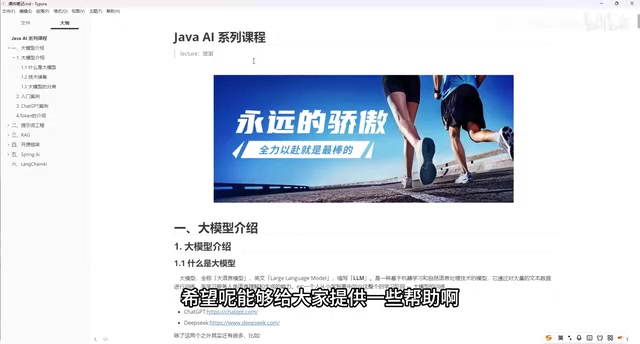
四大核心模块:从基础到框架的完整学习路径
模块一:大模型基础知识与API交互
课程的第一部分从最基础的概念入手,帮助Java开发者理解大模型的工作原理。核心知识点包括:
- 大模型基础概念:什么是大语言模型(LLM),它的能力边界在哪里
- API交互实战:通过纯Java项目(非框架),直接调用ChatGPT等大模型的API接口,完成基本的对话交互
- Token机制:理解Token是什么、如何计算、为什么它直接关系到API调用成本
大语言模型(Large Language Model)是基于Transformer架构构建的深度神经网络,通过在海量文本数据上进行预训练,学习语言的统计规律和语义关系。GPT系列、LLaMA、通义千问广告等都属于此类模型。它们的核心能力来自于"自回归生成"机制——根据已有的上下文,逐个预测下一个最可能出现的Token。理解这一点对Java开发者至关重要,因为它解释了为什么大模型的输出具有概率性而非确定性,也解释了为什么提示词的措辞会显著影响输出质量。
关于Token机制,需要特别说明的是:Token是大模型处理文本的最小单位,但它既不等于字符也不等于单词。以GPT系列使用的BPE(Byte Pair Encoding)分词算法为例,英文中一个常见单词通常对应1个Token,而不常见的长单词可能被拆分为多个Token;中文则通常1-2个汉字对应1个Token。Token的重要性在于:API调用按Token数量计费(包括输入和输出),且每个模型都有上下文窗口限制(如GPT-4 Turbo为128K Token)。Java开发者在设计应用时,需要精确控制Token消耗以优化成本,这涉及到提示词精简、上下文裁剪等工程实践。
这个模块的设计思路非常务实——先不引入任何框架,用最原始的Java代码去理解大模型交互的本质。这对于后续理解框架"帮你做了什么"至关重要。
模块二:提示词工程(Prompt Engineering)
提示词工程是AI应用开发中最容易被低估、却又最能产生立竿见影效果的技能。

正如课程中强调的:"提示词用得好,能够显著提高对大模型的应用效果。" 这不是一句空话。在实际企业开发中,同样的大模型,不同的提示词策略可能带来天壤之别的输出质量。
对于Java开发者而言,提示词工程的学习门槛并不高,但需要系统性地掌握以下核心技巧:
- 角色设定(System Prompt)的最佳实践
- 少样本学习(Few-shot Learning)的应用
- 结构化输出的引导方法
- 链式思考(Chain of Thought)的使用场景
这些技巧各有其理论基础和实践价值。角色设定(System Prompt)通过在对话开始时定义模型的身份和行为约束,能有效收窄模型的输出空间,提高回答的专业性和一致性。少样本学习(Few-shot Learning)源自GPT-3论文中的发现——在提示词中提供几个输入-输出示例,模型就能"学会"特定的任务模式,无需任何参数更新。链式思考(Chain of Thought, CoT)由Google在2022年提出,通过引导模型"一步步思考",显著提升了复杂推理任务的准确率。结构化输出则是通过在提示词中明确要求JSON、XML等格式,配合模型的JSON Mode功能,确保输出可被程序直接解析——这对Java应用的工程化集成尤为关键。
这些技巧与编程语言无关,但在Java应用中如何优雅地管理和组织提示词模板,则是Java开发者需要特别关注的工程化问题。
模块三:RAG检索增强生成全链路实现
RAG(检索增强生成)是目前企业中成本最低、落地最快的AI应用方案之一。相比微调(Fine-tuning)大模型,RAG不需要昂贵的GPU资源和海量训练数据,只需要将企业私有知识库与大模型结合即可。
从技术路线对比来看,微调需要准备大量高质量的领域标注数据,使用GPU集群对模型参数进行再训练,成本高昂且周期较长,但能让模型"内化"领域知识,推理时无需额外检索。RAG则采用"外挂知识库"的思路,在推理时动态检索相关信息并注入上下文,优势在于知识可实时更新、无需重新训练、成本可控。对于大多数企业场景——如内部文档问答、客服知识库、合规检索等——RAG是性价比最优的方案。两者也可以结合使用:用微调提升模型的领域理解能力,用RAG补充实时性和细粒度的知识。

课程中RAG模块的技术链路非常完整,覆盖了以下关键环节:
- 文本加载(Document Loading):从PDF、Word、网页等数据源中提取文本内容
- 文本切割(Text Splitting):将长文档按照语义或固定长度切分为合适的片段
- 向量计算(Embedding):将文本片段通过Embedding模型转换为向量表示
- 向量存储:将向量存入向量数据库,课程涉及ChromaDB和Milvus两种主流方案
- 检索与生成:用户提问时,先从向量数据库中检索相关文档片段,再将其作为上下文传递给大模型生成回答
其中,Embedding(向量嵌入)环节是整个RAG流程的技术核心之一。它将文本映射到高维向量空间,使得语义相近的文本在向量空间中距离更近。常用的Embedding模型包括OpenAI的text-embedding-3-small/large、BGE系列等,它们将文本转换为768维或1536维的浮点数向量。向量检索的核心是相似度计算,常用的度量方式包括余弦相似度、欧氏距离和内积。在大规模场景下,精确的暴力搜索效率太低,因此向量数据库采用近似最近邻(ANN)算法,如HNSW(分层可导航小世界图)和IVF(倒排文件索引),在检索精度和速度之间取得平衡。Java开发者理解这些原理,有助于在实际项目中做出合理的向量维度选择、索引类型配置和检索参数调优。
这套RAG流程用纯Java代码实现一遍,能让开发者深刻理解每一个环节的作用。特别是向量数据库的选型——ChromaDB是一个开源的轻量级向量数据库,使用Python编写,支持内存存储和持久化存储,API简洁直观,几行代码即可完成向量的存储和检索,内置了多种Embedding模型的集成,非常适合快速原型开发和小规模应用(百万级以下向量)。Milvus则是由Zilliz开源的分布式向量数据库,采用存算分离架构,支持万亿级向量的高性能检索,提供多种索引类型(HNSW、IVF_FLAT、IVF_PQ等),具备完善的数据分区、副本管理和水平扩展能力。Milvus还提供了Java SDK,与Java生态的集成更为原生。在生产环境中,Milvus的稳定性、可扩展性和运维工具链都更加成熟。
模块四:Spring AI与Langchain4j框架实战
在前三个模块用"裸代码"打好基础之后,第四模块引入两大主流Java AI开发框架:

Spring AI 是Spring生态官方推出的AI开发框架,对于Spring Boot开发者来说几乎零学习成本。它提供了:
- 统一的模型抽象层,支持OpenAI、阿里云百炼等多种模型提供商
- 与Spring Boot自动配置的无缝集成
- 内置的RAG支持和向量数据库连接器
Langchain4j 则是LangChain在Java生态的对应实现,功能更加丰富:
- 完善的AI Agent开发支持
- 丰富的工具调用(Function Calling)能力
- 更灵活的链式调用编排
这里需要特别解释Function Calling和AI Agent这两个关键概念。Function Calling(函数调用/工具调用)是大模型与外部系统交互的关键机制。开发者预先定义一组函数的名称、参数和描述,大模型在对话过程中根据用户意图判断是否需要调用某个函数,并生成结构化的调用参数。应用程序执行实际的函数调用后,将结果返回给模型进行最终回答。AI Agent(智能体)则是在Function Calling基础上的更高层抽象——它具备自主规划、决策和执行的能力,能够将复杂任务分解为多个步骤,自主选择工具、执行操作并根据中间结果调整策略。典型的Agent架构包括ReAct(推理+行动)模式和Plan-and-Execute(规划+执行)模式。Langchain4j在这方面提供了较为完善的抽象,支持开发者用Java构建具备多工具协作能力的智能体应用。
两个框架各有侧重:Spring AI更适合已有Spring技术栈的团队快速集成AI能力;Langchain4j则在Agent开发和复杂AI工作流编排方面更具优势。在实际项目中,根据需求选择合适的框架,甚至两者结合使用,都是可行的方案。
Java做AI开发的现实价值与定位
很多人可能会质疑:AI开发为什么不直接用Python?Java做AI到底有什么优势?
从实际企业场景来看,Java在AI应用层开发中有几个不可替代的优势:
- 企业级工程能力:Java的类型系统、依赖管理、微服务架构在大型AI应用中依然是刚需
- 存量系统集成:大量企业的核心业务系统基于Java构建,AI能力需要与这些系统深度集成
- 团队技能复用:让现有Java团队直接开发AI应用,比招聘Python团队或全员转型的成本低得多
需要明确的是,Java在AI领域的定位是应用层开发,而非模型训练。模型训练仍然是Python的主场——PyTorch、TensorFlow等主流深度学习框架均以Python为第一语言,GPU计算生态(CUDA)也与Python绑定最为紧密。但在将大模型能力集成到企业应用中这个环节——包括API调用编排、业务逻辑处理、权限控制、数据流转、服务治理等——Java完全可以胜任,甚至更具优势。这种"Python训练模型、Java构建应用"的分工模式,正在成为越来越多企业的技术架构选择。
学习路径总结与优先级建议
这套课程的设计逻辑值得肯定:先用原生Java代码理解底层原理,再用框架提升开发效率。这种"先手动挡、后自动挡"的学习路径,能让开发者在使用框架时知其所以然。
对于想要入门Java AI开发的程序员,建议按以下优先级推进:
- 必学:大模型API交互 + 提示词工程(投入产出比最高)
- 重点掌握:RAG检索增强生成全链路实现(企业落地最常见的场景)
- 按需深入:Spring AI或Langchain4j框架(根据团队技术栈选择)
- 进阶方向:AI Agent开发(未来最具想象空间的方向)
AI不会取代Java程序员,但掌握AI能力的Java程序员,一定会取代不掌握的。
相关推荐
一个WordPress插件打通27个AI客户端
一款WordPress插件支持Claude、ChatGPT、Cursor、VS Code、Windsurf、Gemini等27个AI客户端,免费提供236项能力,Pro版额外解锁1200多项,并兼容现有页面构建器和区块。
Tricentis vs Cursor:隐私优先团队该选谁?
Tricentis 与 Cursor 该如何选?基于约六个月实测的对比分析:Tricentis 擅长企业级软件测试与质量工程,Cursor 专注 AI 辅助编码。隐私敏感团队需重点核查数据保留政策、访问控制与部署合规性,本文给出选型决策清单。
情绪如何塑造学习?神经科学家揭开意义构建的真相
神经科学家Mary Helen Immordino-Yang在Huberman Lab节目中揭示情绪如何驱动学习与意义构建,批评西方教育体系将情绪引向成绩而非观念,呼吁以人的发展取代学习结果作为教育目标。