Jev模型开源平替:CPU/GPU本地一键部署实测
社区开源平替Jev判别式概率模型,支持本地CPU/GPU离线运行与API集成。
Jev是一款判别式概率模型,不同于生成式大模型,它专注于对文本做真/假判断和选项概率打分,输出结构化数值而非自然语言。由于开发商TypeSafe未开源模型权重,社区推出了OpenJev等平替项目,并配套提供懒人一键部署包。该部署包可自动检测CPU/GPU环境并切换推理模式,支持完全离线运行,同时提供图形Web UI与本地API两种接入方式。使用时需注意路径避免中文、提问优先用英文,首次加载需耐心等待。对于需要轻量级文本分类、真假甄别或置信度打分的场景,这类判别式模型比调用生成式大模型更直接、更高效。
最近一个名为 Jev(视频中读作"Jave")的 AI 模型在社区里刷屏。与我们日常使用的对话式大模型不同,它本质上是一个概率预测模型——不会给你输出流畅的自然语言,而是针对某个问题给出"是/非"判断,或者对给出的多个选项返回一个概率性的排序结果。
问题在于,开发该模型的公司(视频中提到的 TypeSafe)并没有开源模型文件与权重。于是社区里陆续出现了 OpenJev 等一批"开源版 Jev"项目。本文基于 B 站 UP 主分享的一个懒人一键部署包,介绍如何在本地机器上离线运行这类模型,并实测其效果。
Jev 模型到底是什么
简单说,Jev 属于判别式概率模型,而非生成式大模型。它的核心能力是围绕一段文本进行结构化判断:
- 对某个陈述做是非(True/False)判断;
- 对若干候选选项进行分类;
- 针对每个选项给出概率评分。
这类模型的价值不在于"能聊天",而在于可量化、可判断。在需要对文本做快速分类、真假甄别或置信度打分的场景下,它比让大模型生成一大段文字要更直接、更轻量。
由于官方未开源,社区版本(如视频中使用的开源实现)在实现逻辑上与原版高度相似,并且做了一个关键改进:可以直接部署在本机运行,无需联网,通过 CPU 或 GPU 即可推理出结果。这对隐私敏感或离线环境的用户尤其友好。
判别式模型与生成式模型的本质区别值得在此多说几句。以 GPT、Claude 为代表的生成式大模型(Generative Model)的训练目标是"下一个词是什么",它们通过自回归方式逐词输出文本,擅长写作、对话、代码生成等开放式任务。判别式模型(Discriminative Model)则不生成新内容,而是学习"给定输入,输出属于哪个类别/概率是多少",典型代表包括早期的 BERT 及其各类微调变体。判别式模型通常参数规模更小、推理速度更快、显存占用更低,非常适合部署在资源受限的本地环境中。Jev 所处理的"真/假判断"与"选项概率打分"正是判别式建模的标准输出形式,与大模型通过生成文字来"描述概率"有本质不同——前者输出的是机器可直接消费的结构化数值,后者则需要再次解析自然语言才能提取判断结论。
一键部署包的安装流程
这个懒人部署包的最大卖点是"开箱即用",把环境检查、依赖校验和启动都封装成了脚本。整体流程如下:
第一步:解压
下载压缩包后解压到本地路径。务必注意路径中不要包含中文字符,否则可能导致脚本执行报错。解压后目录里包含运行所需的文件与脚本。
第二步:一键部署与环境检查
初次使用建议先运行"一键部署"脚本。它会自动检查当前环境、校验部署包是否完整。这一步能帮你提前发现缺失文件或环境问题,避免启动后报错。
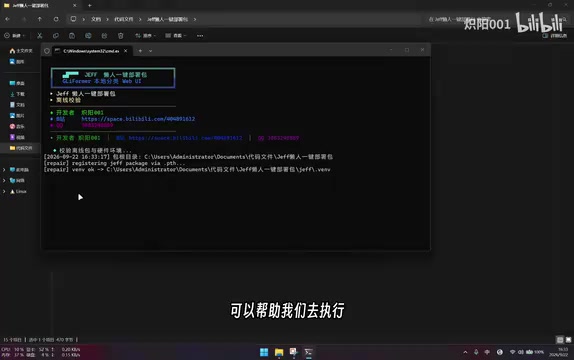
第三步:启动 Web UI
校验通过后直接启动 Web UI。程序会自动检测硬件并选择运行模式:检测到 GPU 就调用 GPU,没有 GPU 则自动回退到 CPU 推理。
需要提醒的是,首次加载时间取决于硬件配置差异较大——配置好的机器可能几十秒完成加载,性能一般的机器可能需要一到三分钟。这属于正常现象,耐心等待即可。
实际使用与效果演示
进入 Web UI 界面后,操作逻辑很清晰:填入一段"待分析文本",最多可以配置 5 个问题,然后点击运行分类。
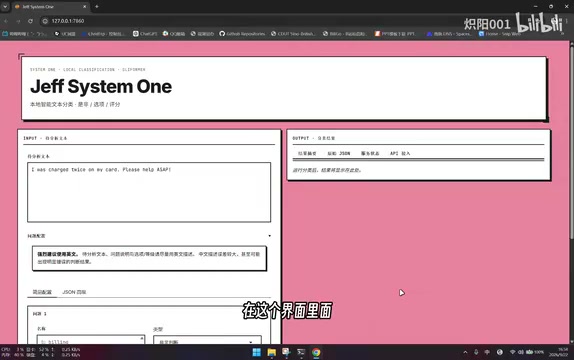
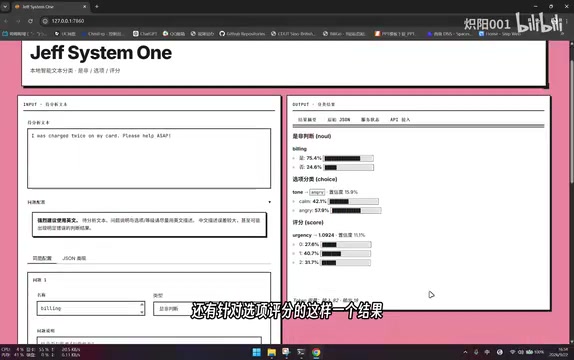
模型在本地跑完后,会返回三类结果:
- 是非判断:对陈述给出真/假结论;
- 选项分类:把候选项归类;
- 选项评分:对每个选项给出概率分值。
这里有一个重要使用建议:待分析文本和问题都强烈建议使用英文。因为该模型主要用英文语料训练,输入中文有可能出现错误或不准确的回复。想快速上手的话,可以先载入内置示例观察运行效果,再替换成自己的内容提问。
API 接入:从本地体验到实际集成
除了图形界面,这个部署包还整合了 API 接入功能,这一点让它的用途从"体验"延伸到了"可集成"。
如果你希望把模型部署在服务器上,或者在本机运行后供其他程序调用,可以通过部署包完成本地 API 接入。接入之后,外部程序就能通过 API 接口调用 Jev 模型的判断与评分能力,把它嵌入到自己的自动化流程或应用中。
对于开发者而言,这种"图形界面 + 本地 API"的双模式设计,既方便非技术用户点点鼠标体验,也给需要工程化集成的人留了口子。
本地 API 的典型集成模式是:在本机或内网服务器上启动 Jev 服务后,外部程序通过 HTTP 请求(通常是 REST 接口)将待分析文本和问题以 JSON 格式发送给模型,模型返回包含概率分值的结构化响应。这种模式与调用 OpenAI API 的开发体验类似,但流量完全留在本地网络,不会经过任何第三方服务器。对于需要处理敏感文本(如合同审查、内部舆情分析)或受网络管控限制的场景,本地 API 部署是兼顾功能性与合规性的务实选择。开发者可以将此接口封装进 Python 脚本、自动化工作流(如 n8n、Airflow)或后端服务,实现批量文本分类、内容审核打分等流水线任务。
小结
Jev 这类概率判别模型代表了大模型热潮之外的另一条路线:不追求生成能力,而专注于结构化判断与打分。在官方未开源的背景下,社区的开源平替 + 懒人部署包,让普通用户几乎零门槛地在本地离线体验这类能力。
如果你想尝试,关键点记住三条:路径不含中文、优先用英文提问、首次加载耐心等待。至于它能否真正替代原版 Jev 的判断精度,仍取决于社区实现的成熟度,值得持续关注。
相关推荐
本地运行Pixel 3D多视图:8GB显存免费生成高精度3D模型
Pixel 3D多视图功能已原生集成ComfyUI,8GB显存即可本地免费生成高精度3D模型。本文详解安装、模型下载、Flux免费视图生成、显存需求及单视图/多视图实测对比。
Qwen Image 2.1 本地实测:开源图像编辑能否叫板闭源?
阿里 Qwen Image 2.1 图像编辑模型开源,B站UP主梨花本地实测七组案例并分享工作流与提示词模板。本文详解模型构成、8GB显存部署门槛、ComfyUI关键设置,以及与GPT等闭源产品的横向对比结论。
8G显存本地跑通MiniMax H3:ComfyUI整合包实测
MiniMax H3 海螺开源视频模型 8G 显存本地部署实测,基于秋叶 ComfyUI 整合包和 4步 Lora 提速,附四类模型下载、关键参数设置与效果分析,一键解压即用,免费无排队。