极简RAG记忆系统BRIDGE:何时够用,何时不够?
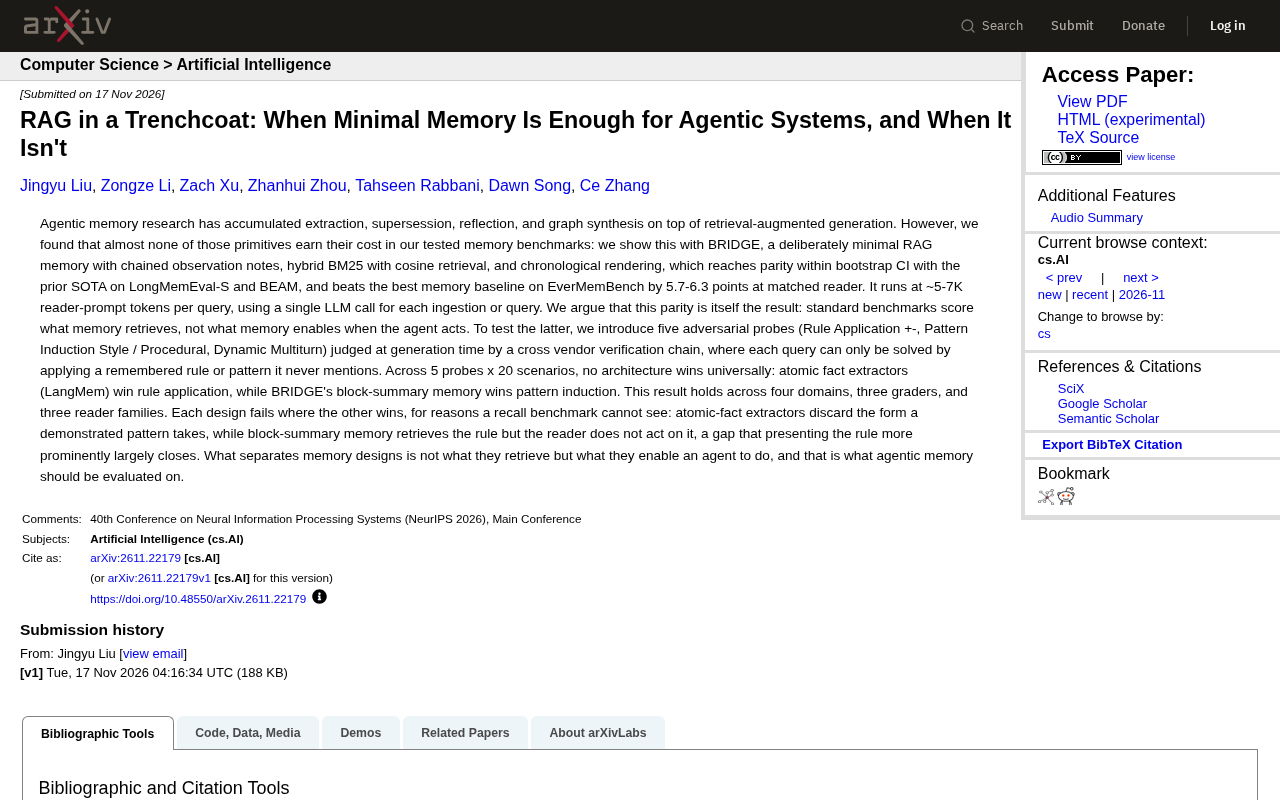
极简RAG记忆系统BRIDGE挑战复杂架构,揭示记忆评估应转向“使能”视角。
一项新研究提出极简RAG记忆系统BRIDGE,在多个标准基准上与复杂SOTA持平甚至更优,且成本更低。研究者指出标准记忆基准只衡量检索内容,无法反映记忆对智能体行动的支持能力。通过五个对抗性探针测试,发现没有普适最优架构:原子事实抽取器擅长规则应用,块摘要记忆擅长模式归纳,失败模式源于设计取舍。研究呼吁智能体记忆评估转向“使能”视角,即记忆是否帮助智能体正确行动。
在AI智能体(Agent)的记忆系统设计中,业界已经堆叠了太多复杂机制:实体抽取、事实超替、反思、图合成……但一项新的研究却发现,这些“高级原语”在标准记忆基准测试中几乎无法证明其成本合理性。研究者提出了一个名为BRIDGE的极简RAG记忆系统,并用一系列对抗性测试揭示了记忆设计的真正关键——不是检索了什么,而是让智能体能够做什么。
BRIDGE:一件“风衣”下的极简主义
BRIDGE的设计刻意保持极简:链式观察笔记、BM25与余弦相似度的混合检索、按时间顺序渲染。它每次查询只消耗约5-7K读者提示词token,每个摄入或查询仅需一次LLM调用。没有复杂的抽取管线,也没有图结构合成。
据研究团队在多项基准上的测试,BRIDGE的表现令人意外:在LongMemEval-S和BEAM上,它与先前的最优方法(SOTA)在bootstrap置信区间内达到持平;在EverMemBench上,在匹配读者模型的情况下,它比最佳记忆基线高出5.7-6.3个百分点。这一结果直接挑战了“记忆系统越复杂越好”的直觉。
标准基准的盲区
研究者指出,这种“持平”本身就是结果:标准基准测试衡量的是记忆检索到了什么,而非记忆在智能体行动时能实现什么。换句话说,现有基准无法区分不同记忆架构在真实任务中的能力差异,因为它们只关注召回率,而忽略了记忆如何被智能体使用。
BM25 是一种经典的稀疏检索算法,基于词频(TF)与逆文档频率(IDF)计算查询与文档的相关性,擅长精确匹配关键词。余弦相似度 则常用于稠密向量检索,通过计算查询向量与文档向量的夹角余弦值来衡量语义相似性。BRIDGE 将两者混合,兼顾了关键词匹配的精确性与语义检索的泛化能力,同时保持了系统的轻量性。
LongMemEval-S、BEAM 和 EverMemBench 是近期提出的智能体记忆评估基准。它们通常构造多轮对话或长文档场景,要求系统根据历史信息回答查询,并以召回率、准确率等指标衡量检索效果。然而,这些基准主要关注“是否检索到正确信息”,而非“检索到的信息是否被智能体有效用于决策或行动”,因此难以区分不同记忆架构在真实任务中的能力差异。
对抗性探针:记忆设计的真正试金石
为了测试记忆在智能体行动中的价值,研究团队引入了五个对抗性探针(Rule Application +-、Pattern Induction Style / Procedural、Dynamic Multiturn),在生成时由跨厂商验证链进行评判。每个查询都只能通过应用一条从未被明确提及的记忆规则或模式来解决。
在5个探针×20个场景的测试中,没有一种架构能通吃所有场景:原子事实抽取器(如LangMem)在规则应用上胜出,而BRIDGE的块摘要记忆在模式归纳上表现更佳。这一结果在四个领域、三个评分器和三个读者模型家族中均成立。
失败模式的根源
两种设计各自在对方擅长的领域失败,原因恰恰是召回基准无法捕捉的:原子事实抽取器丢弃了演示模式所呈现的形式,导致模式归纳失败;而块摘要记忆虽然检索到了规则,但读者模型并未据此行动——这一差距通过更突出地呈现规则可以大幅缩小。
原子事实抽取器(如 LangMem)将记忆分解为独立的事实三元组或短句,便于精确检索和规则应用,但可能丢失事件或演示中的序列模式与形式结构。块摘要记忆 则保留较大粒度的文本块(如对话片段或文档段落),能更好地捕捉模式与上下文,但可能引入噪声,且需要读者模型具备更强的推理能力来提取规则。两者在记忆粒度上形成权衡。
读者模型 指在 RAG 系统中负责阅读检索到的记忆并生成最终回答或行动的 LLM。记忆系统的效果不仅取决于检索质量,还取决于读者模型能否正确理解和利用检索内容。BRIDGE 的实验中,块摘要记忆虽检索到规则,但读者模型未遵循,说明记忆的呈现方式(如突出规则)会显著影响读者模型的行为,这是评估记忆系统时需考虑的关键因素。
多源验证与共识
据该研究以及社区分析(如B站UP主和YouTube频道对相关工作的讨论),有几个共识值得关注:第一,标准记忆基准对架构差异不敏感,无法指导设计决策;第二,极简RAG在多个基准上能达到与复杂系统相当的性能,且成本更低;第三,智能体记忆的评估应转向“使能”视角,即记忆是否帮助智能体正确行动。
对于分歧点,研究也如实呈现:原子事实抽取器在规则应用上优势明显,而块摘要记忆在模式归纳上更强,两者各有适用场景,不存在普适最优架构。
对智能体记忆设计的启示
这项研究传递了一个清晰信号:记忆系统的价值不应仅由检索指标衡量,而应看它能否让智能体在需要时应用记忆中的规则或模式。设计者需要根据任务类型选择记忆粒度——如果任务涉及明确的规则应用,原子事实抽取可能更合适;如果任务需要从示例中归纳模式,块摘要记忆更具优势。
BRIDGE的出现并非要否定复杂记忆系统,而是提醒我们:在增加复杂度之前,先确认它是否真的带来了智能体行为的改善。毕竟,一件“风衣”有时就足够了——只要你知道它在哪里不够用。
相关推荐

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。

黄仁勋若卸任,英伟达AI帝国将何去何从?
英伟达的AI霸权是否过度依赖黄仁勋个人?本文分析硅谷对CEO的个人崇拜现象,探讨英伟达技术护城河与组织风险,以及AI产业为何需要摆脱救世主叙事。

2026科技诉讼风向标:立法者欲收紧AI与平台责任
2026年科技诉讼成为焦点:美国参议院司法小组委员会听证会推动限制在线平台强制仲裁,并加强对深度伪造创作者的追责,科技平台与AI工具面临责任重构。