计算方法追踪梵语语义演变:低资源古语言的NLP挑战

首次系统验证历时词向量范式在低资源古典梵语上的可行性,21项语义演变中19项方向与文献学考证吻合。
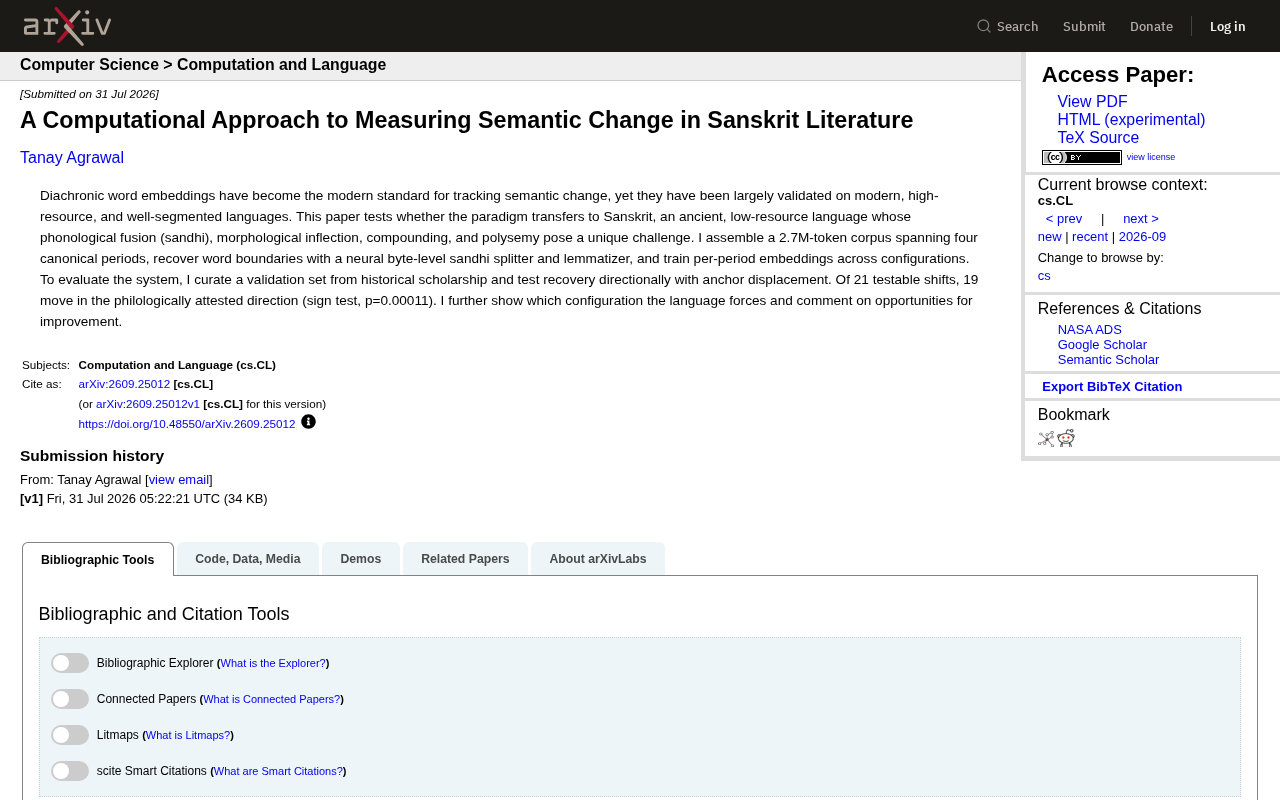
这篇arXiv论文将历时词向量(diachronic word embeddings)这一语义演变分析范式迁移到了极具挑战性的古典梵语上。研究者构建了270万token、横跨四个经典时期的语料库,并借助字节级神经网络完成连声切分与词形还原,解决了梵语书写中词边界模糊的核心难题。在评估层面,研究从历史学术文献中整理出"金标准"验证集,通过锚点位移的方向性测试检验模型输出:21个可测语义变化中有19个方向与文献学考证一致,符号检验p=0.00011。论文的价值不仅在于结论本身,更在于为低资源语言NLP提供了从语料构建、神经预处理到基于领域知识验证的完整方法链路,并示范了用传统文献学约束和检验模型输出的严谨评估态度。
历时词向量(diachronic word embeddings)早已成为追踪语义演变的现代标准工具,但它们的有效性大多是在现代、高资源、分词清晰的语言上验证的。当研究者试图把这套范式迁移到古老且资源匮乏的梵语时,会遇到什么?一篇新发表的arXiv论文给出了系统性的答案。
为什么梵语是块难啃的骨头
梵语给计算语言学带来的挑战与现代语言截然不同。它具有几个棘手的语言学特征:连声(sandhi)导致的音系融合、复杂的形态屈折变化、大量的复合构词,以及一词多义(polysemy)现象。
这些特征叠加在一起,使得最基础的词边界识别都成了难题。在英语这样的语言里,空格天然地分割了单词,词向量模型可以直接消费token序列;而梵语文本中词与词经常在书写时融合成连续的字符流,模型甚至无法判断一个"词"从哪里开始、到哪里结束。这正是历时词向量范式在梵语上难以直接套用的核心原因。
连声(sandhi)是梵语中相邻音素在词边界处发生融合变形的语音规则,例如两个词相邻时,末尾的元音与开头的元音会合并成一个新的元音,甚至改变辅音形态。这一规则在书写时也被忠实记录,导致句子在视觉上呈现为一条几乎没有空格的连续字符流。对于自然语言处理模型而言,连声切分(sandhi splitting)是梵语分析的第一道关卡,若切分出错,后续所有基于词的统计都会被污染。此外,梵语的形态屈折系统极为丰富,同一个词根可以派生出数十种屈折形式,如果不进行词形还原(lemmatization)将所有屈折形式归并到同一词元,稀疏的词频统计会严重影响词向量的质量。这正是为什么预处理在梵语NLP中具有远比处理英语更核心的地位。
从原始语料到可训练数据
作者构建了一个规模达270万token的语料库,覆盖梵语文献的四个经典时期,从而为"历时"分析提供了必要的时间跨度。有了跨时期的语料,才能观察一个词的语义如何随时间漂移。
处理流程中最关键的一步,是解决前面提到的词边界问题。作者采用了一个基于字节级(byte-level)的神经网络连声切分器(sandhi splitter)和词形还原器(lemmatizer),先把融合的字符流还原为独立的词元,再在此基础上按时期分别训练词向量。这一"先切分、后建模"的思路,本质上是为低资源古语言补上现代语言天然具备的预处理条件。
历时词向量(diachronic word embeddings)的基本思路是:针对不同历史时期的语料分别训练独立的词向量空间,再通过对齐(alignment)技术将各时期的向量映射到同一坐标系下,从而使同一个词在不同时期的向量可以直接比较距离。常用的对齐方法包括正交 Procrustes 变换,它在保持各时期内部几何结构的前提下,最小化对齐词对之间的距离。词向量之间的余弦距离变化即被视为语义漂移的量化指标。这一框架在英语、德语等语言上已有大量验证,但其前提假设——语料足够大、词边界清晰、拼写相对稳定——在古典语言中往往难以满足,这正是本研究需要在预处理层面做额外工程工作的根本原因。
如何验证结果的可靠性
语义演变研究的一大难点在于评估——你怎么知道模型捕捉到的漂移是真实的,而不是训练噪声?作者的做法值得借鉴:从历史学术文献(historical scholarship)中人工整理出一个验证集,把语言学家早已考证过的语义变化作为"金标准"。
评估采用了锚点位移(anchor displacement)的方向性测试,即检验模型给出的语义漂移方向是否与文献学考证的方向一致。结果颇具说服力:在21个可测试的语义变化中,有19个的移动方向与文献学证据吻合。作者对此做了符号检验(sign test),得到p=0.00011的显著性水平,意味着这种一致性极不可能是偶然出现的。
符号检验(sign test)是一种非参数统计方法,用于检验某个二值结果(如"方向正确"或"方向错误")出现的频率是否显著偏离随机基线。在本研究的语境下,若模型对语义漂移方向的判断完全随机,则21个测试案例中每个方向正确的概率均为0.5;实际观测到19个正确,符号检验计算在零假设成立时出现"至少19个正确"的概率,得到p=0.00011。这一极低的p值意味着模型的方向性判断与文献学证据高度一致,几乎不可能是随机巧合。相比于仅报告余弦相似度数值的做法,方向性验证更具语言学意义,因为它直接对应了"词义是否朝着已知方向演变"这一可解释的历史问题。
方法迁移的意义与局限
这项工作的价值不只在于"梵语也能做语义演变分析"这个结论本身,更在于它揭示了范式迁移过程中的具体约束条件。作者明确指出了梵语这门语言"强制"选择了哪种配置——换句话说,语言的特性直接决定了哪些建模方案可行、哪些不可行,而不是研究者可以随意调参。
对于从事低资源语言NLP的研究者而言,这提供了一个可参考的完整链路:语料构建 → 神经切分与词形还原 → 分时期训练 → 基于历史文献的方向性验证。作者同时也坦诚地指出了未来的改进空间,说明当前系统远非终点。
对低资源语言NLP的启示
主流NLP研究长期集中在英语等高资源语言上,古典语言和小语种往往被边缘化。这篇论文的意义在于,它证明了成熟的现代方法在经过针对性改造后,确实可以服务于人文学科的经典问题——比如梵语文献的语义流变。
更重要的是,它示范了一种严谨的评估态度:不满足于生成漂亮的可视化结果,而是回到文献学传统中寻找可检验的真值。在大模型时代,这种"用领域知识约束和验证模型输出"的思路,对任何试图把AI应用到专业领域的工作都有普适的参考价值。
相关推荐

基于Yggdrasil网络的朋友间分片加密存储:去中心化备份新思路
一个基于Yggdrasil加密覆盖网络的朋友间分片加密存储概念在Hacker News引发关注。本文解读分片、端到端加密与去中心化网络如何结合,构建介于自建NAS与公有云之间的隐私备份新方案,并分析其现实挑战。

MiniCPM-V-4.7-35B-A3B 现身 HuggingFace:MoE 多模态新动向
HuggingFace 平台现身 MiniCPM-V-4.7-35B-A3B 新模型条目,命名暗示其采用总参数 35B、激活 3B 的 MoE 多模态架构。本文解读命名含义与技术趋势,目前模型卡尚未发布。

Devin AI实战全解析:云端AI软件工程师如何独立交付完整项目
基于一次完整实战演示,深度解析Cognition的AI软件工程师Devin AI如何在云端独立构建Agentic RAG系统,涵盖Devin Cloud、计算机使用、自动化、代码审查、安全扫描与Outpost等核心能力。