家用电脑跑1250亿参数大模型?两万五千星Strata本地部署解析

开源项目Strata让千亿参数MoE模型在家用电脑上本地离线运行。
GitHub开源项目Strata以近两万五千星的热度,展示了在普通游戏电脑上本地运行千亿参数大模型的可能性,实测对象为通义千问1250亿参数版本。其核心是MoE混合专家架构:模型内含两万多个专家模块,每次推理仅调用相关少数专家,并将常用权重放入显存、其余存入内存,从而把峰值显存需求压到消费级显卡水平。硬件门槛为显存12GB以上、内存32GB起步、硬盘预留80GB,首次下载约70GB。接口兼容OpenAI API,现有工具只需更换地址即可接入。实测生成速度每秒几十个词,支持离线使用,隐私数据不出本机。
GitHub上一个叫Strata的开源项目最近引发关注,近两万五千颗星的热度背后,是一个足够吸引人的承诺:不用租服务器,把千亿参数级别的大模型装进你自己的电脑,断网也能用。据B站UP主的实测分享,这个项目让普通游戏电脑跑起了通义千问新旗舰——1250亿参数版本。
千亿参数怎么塞进家用机?
1250亿参数的模型,按传统思路得靠机房级硬件才能推理。Strata的核心思路是MoE(混合专家)架构——模型内部包含两万多个小专家模块,每次推理只调用其中相关的少数专家,而不是把全部参数都跑一遍。
硬件分配策略也很务实:常用的专家权重放在显卡显存里,其余全部存入系统内存,需要时再调取。这种"热数据进显存、冷数据留内存"的分层方案,把峰值显存需求压到了消费级显卡能承受的范围。
装好之后,打开浏览器就能对话、写代码、看图片、接编程助手,所有推理都在本机完成。作者用游戏电脑实测,生成速度达到每秒几十个词,读长文档时甚至更快。
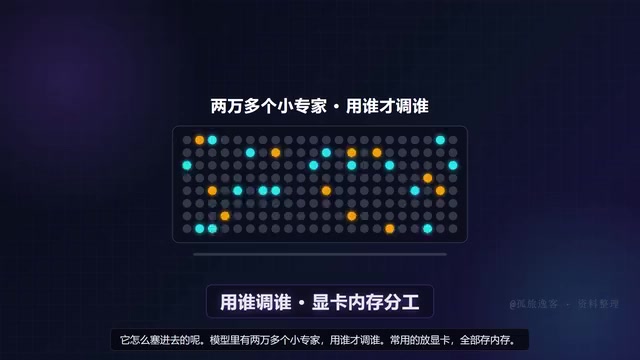
MoE(混合专家)架构是一种在模型内部设置多个并行子网络(即“专家”)的稀疏激活设计。与传统稠密模型每次推理都要调动全部参数不同,MoE在每一层通过一个路由网络(Router)判断当前输入该由哪些专家处理,只激活少数几个专家,其余专家保持静默。这样模型的总参数量可以做得极大,但单次推理的实算量只与激活的专家数量成正比。这也是“千亿参数模型能跑在消费级显卡上”的理论前提。
需要区分的是“总参数量”与“激活参数量”:前者决定模型的知识容量和存储需求,后者决定推理时的算力消耗。Strata这类方案正是利用了两者之间的巨大落差,用内存换显存、用稀疏换速度。不过MoE也有代价,路由本身的判断误差、专家负载不均衡以及大量专家权重的加载延迟,都会影响实际体验,这也是本地部署时需要按模型和任务实际测试的原因。
兼容OpenAI接口,接入现有工具链
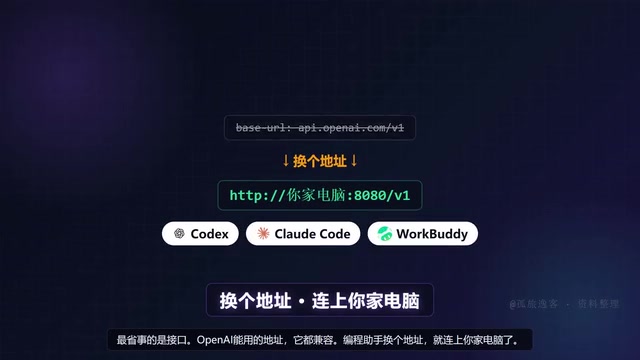
Strata最省事的设计是接口兼容性。任何支持OpenAI API地址的工具——编程助手、聊天客户端、自动化脚本——只需把请求地址换成你本机的Strata服务,就能直接调用本地模型,无需改动其他配置。
这对已经习惯了云端API工作流的开发者来说,迁移成本几乎为零。数据不出本机,不连网也能聊,隐私敏感场景下的价值大家都看得到。
OpenAI API 兼容通常指服务端实现了与 OpenAI Chat Completions(/v1/chat/completions)等端点一致的请求与响应格式,包括 model、messages、temperature、stream 等字段。只要接口行为一致,客户端便无需感知底层是云端服务还是本机推理进程。
这种兼容模式大大降低了迁移成本,但也存在边界:不同工具可能依赖特定的模型名称、工具调用(function calling)、多模态消息格式或流式增量返回,本地实现若未完全覆盖,仍可能出现报错或降级。因此“换个地址就能用”通常指的是基础对话与补全场景,复杂功能仍需以实测为准。
装之前先对一下硬件门槛
翻车最多的地方在硬件。作者明确给出了三条硬性要求:
- 显卡显存:12GB以上
- 系统内存:32GB起步
- 硬盘空间:预留80GB以上(首次下载约70GB)
首次启动会卡顿一到两分钟,属于正常加载过程,不要中途关闭。
显存(VRAM)与系统内存(RAM)的分工是理解本地大模型部署的关键。显存带宽远高于系统内存,适合存放当前推理要频繁访问的权重;系统内存容量大但带宽有限,适合作为“冷存储”,在专家被调用时再经 PCIe 总线搬运到显存。
当所需专家不在显存中时,系统需要临时加载,这会产生额外延迟,表现为回答速度忽快忽慢。硬盘上的模型文件则承担持久化存储角色,首次运行需要将权重解压、映射或复制到内存/显存,因此首次启动明显偏慢。衡量是否跑得动,除了看参数规模,还要看量化精度——同样的模型,4-bit 量化后的体积和显存占用可能只有原始精度的一半以下,这也是 12GB 显存能够承载千亿级 MoE 模型的重要原因。
本地部署的真正意义
Strata代表的是一种趋势:随着MoE架构的成熟和量化技术的进步,千亿参数模型的推理门槛正在从机房下放到个人设备。把每月的API租金变成一次性的硬件投入,对高频使用者来说账很好算。
当然,本地运行的代价是硬件成本、电费和维护精力。是否值得,取决于你的使用频率、数据敏感度和对网络依赖的容忍度。但至少现在,把千亿模型装进家用电脑,已经不再是纸上谈兵。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。