解码LLM基准测试:14767篇论文揭示评估变迁
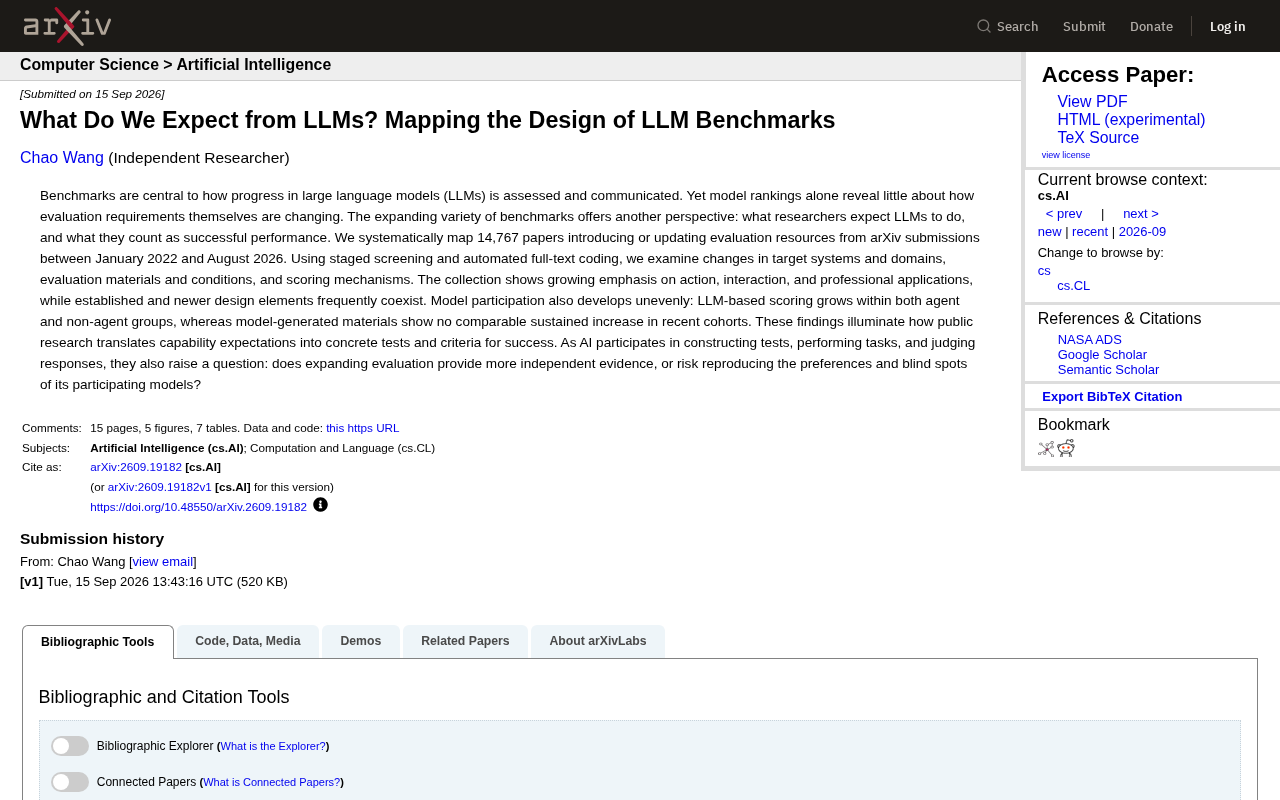
系统梳理近三年LLM基准测试设计演变,揭示评估正从静态问答转向交互行动,且AI自身深度介入评估带来循环公信力风险。
这项覆盖arXiv上14,767篇论文的系统性研究,从目标系统、评估材料与评分机制三个维度,绘制了2022年至2026年间LLM基准测试设计的演变图谱。研究发现,评估重心正从静态多选题问答转向对行动、交互和专业应用的考察,与Agent范式的兴起高度同步;新旧设计范式并非替代关系,而是长期叠加共存。更值得警惕的是,「大模型担任裁判」的评分方式持续扩张,而由模型生成测试材料的增长却明显滞后,这种不对称折射出社区对模型可信度的微妙态度。当AI同时参与出题、答题和打分,评估体系可能悄然复制模型群体的共同偏好与盲区,令「客观评估」陷入自我指涉的循环,这是当前依赖基准排名判断技术进展的根本方法论隐患。
基准测试为何值得单独研究
在大语言模型(LLM)的发展叙事中,基准测试(benchmark)扮演着近乎裁判的角色。模型排行榜的每一次刷新,都会成为业界热议的焦点。然而,一项发表于 arXiv 的最新研究提出了一个被长期忽视的视角:单纯看模型排名,几乎无法揭示评估标准本身正在如何演变。
换句话说,我们不仅要问「哪个模型更强」,更应该追问「研究者到底期望 LLM 做什么,以及他们把什么样的表现算作成功」。这项研究系统性地梳理了从 2022 年 1 月到 2026 年 8 月之间、arXiv 上共 14,767 篇引入或更新评估资源的论文,试图为整个基准测试的设计版图绘制一张地图。
研究方法:从筛选到全文编码
面对近一万五千篇论文的庞大语料,研究团队采用了分阶段筛选(staged screening)与自动化全文编码(automated full-text coding)相结合的方法。这一流程使得大规模、系统化地分析评估资源的设计要素成为可能。
研究关注三条主线:一是目标系统与领域(target systems and domains),即基准测试针对的是什么样的 AI 系统、覆盖哪些应用领域;二是评估材料与条件(evaluation materials and conditions),关注测试所使用的素材及其构造方式;三是评分机制(scoring mechanisms),即如何判定一次回答的优劣。这三个维度共同勾勒出研究者对 LLM 能力预期的具体落地方式。
为什么要拆解这三个维度
基准测试并非中立的度量工具,它本身就编码了设计者对「智能」和「成功」的定义。一个只考察多选题准确率的测试,与一个要求模型在真实环境中完成多轮交互任务的测试,背后反映的是截然不同的能力观。把评估资源拆解为系统、材料、评分三层,正是为了让这些隐含的假设浮出水面。
自动化全文编码(automated full-text coding)是指用程序化或模型辅助的方式,对大量文献中的结构化信息进行提取与分类标注,以取代传统的人工逐篇阅读。在本研究中,面对近一万五千篇论文,人工精读在时间和成本上均不可行,因此研究团队设计了一套编码框架,将每篇论文的关键设计要素(如目标系统类型、评分方式、数据来源等)映射为可量化的变量,再通过自动化流程批量抽取。这一方法的优势在于可重复性和规模化,但也存在局限:自动编码可能遗漏论文中表述模糊或高度上下文依赖的设计决策,因此研究团队通常会在关键类别上保留人工复核步骤,以校验编码质量。
核心发现:从静态问答走向行动与交互
研究揭示的最显著趋势,是评估重心正从传统的静态问答,转向对**行动(action)、交互(interaction)与专业应用(professional applications)**的强调。这一转变与近年来 Agent(智能体)范式的兴起高度吻合——人们不再满足于模型「答对题」,而是期望它能在复杂环境中执行任务、与外部工具及用户持续互动。
值得关注的一点是,新旧设计元素往往是共存而非替代的关系。也就是说,即便交互式、任务型的评估在增长,经典的静态测试范式并未消失,二者在当前的研究生态中同时存在。这提示我们,基准测试的演进是一个叠加累积的过程,而非简单的代际更迭。
Agent(智能体)范式是指将LLM从单纯的问答系统升级为能够自主规划、调用工具、与环境持续交互的执行者。在这一范式下,模型不再只是「回答一个问题」,而是需要分解目标、调用搜索引擎或代码解释器、根据中间结果调整策略,并最终完成跨多步骤的复杂任务。典型应用包括自动化软件开发(如SWE-bench评估)、网页操作(如WebArena)以及科学实验流程自动化。这一转变对基准测试设计提出了根本性挑战:传统的「给定输入、比对标准输出」的静态范式,无法捕捉模型在动态环境中的鲁棒性、错误恢复能力和长程规划能力,因此必须引入模拟环境、交互轨迹记录和多轮评分等新要素。
模型自身正在深度参与评估
研究另一个耐人寻味的观察,是 AI 模型本身在评估流程中扮演的角色越来越重。具体表现为**基于 LLM 的评分(LLM-based scoring)**在 Agent 类与非 Agent 类评估中都呈现增长——也就是俗称的「用大模型来当裁判」(LLM-as-a-judge)正变得普遍。
不过,模型的参与是不均衡的。研究指出,与评分环节的持续增长不同,由模型生成的评估材料(model-generated materials)在近期的论文批次中并没有出现类似的持续增长。这意味着,研究者更愿意让模型去「打分」,却在让模型「出题」这件事上相对谨慎。这种不对称本身,就反映了社区对模型可信度的微妙判断。
LLM-as-a-judge(大模型担任裁判)是指用一个能力较强的语言模型(如GPT-4或Claude)对另一个模型的输出进行质量评分,以替代人工标注或规则匹配。其兴起源于实际需求:开放式生成任务(如长文本写作、多轮对话、代码审查)的输出难以用精确匹配来衡量,人工评估成本又极高。研究表明LLM裁判与人工评分有一定相关性,但也存在明显缺陷:倾向于偏好语气自信、篇幅较长或风格与自身相似的输出,且对越狱式措辞更为宽容。这意味着以LLM打分为核心的排行榜,在一定程度上衡量的是「如何讨好裁判模型」而非真实能力,这正是文章所指出的循环问题的技术根源。
一个值得警惕的循环问题
当 AI 同时参与到构建测试、执行任务、评判回答这三个环节时,一个根本性的问题浮现出来:不断扩张的评估体系,究竟提供了更多独立的能力证据,还是在悄悄复制参与其中的模型的偏好与盲区?
这个追问直击基准测试的公信力核心。如果出题的是模型、答题的是模型、打分的还是模型,那么所谓的「客观评估」就可能陷入自我指涉的循环——测试所奖励的,恰恰是模型群体共同的偏好,而它们共同的盲区则可能永远无法被检测出来。对于依赖基准分数来判断技术进展的研究者、企业与公众而言,这是一个不容回避的方法论挑战。
对从业者的启示
这项研究的价值,不在于给出某个模型的高下结论,而在于提供了一面观察行业集体预期的镜子。对于关注 AI 评测的从业者,有几点可以留意:
- 阅读基准测试结果时,应同时审视其评分机制,尤其警惕纯粹由 LLM 打分带来的偏差;
- 交互式、任务型评估正成为主流方向,静态准确率指标的解释力在下降;
- 评估资源的设计本身就是价值取向的体现,选择用哪个基准,某种程度上就是在选择「你认为什么才叫聪明」。
随着 AI 越来越深地嵌入评估自身,保持对评估独立性的追问,或许比追逐排行榜名次更为重要。
相关推荐
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。