金丝雀发布上线:零停机升级模型推理端点

专用模型推理服务新增金丝雀发布,支持分步流量迁移与自动指标门控,实现零停机模型升级。
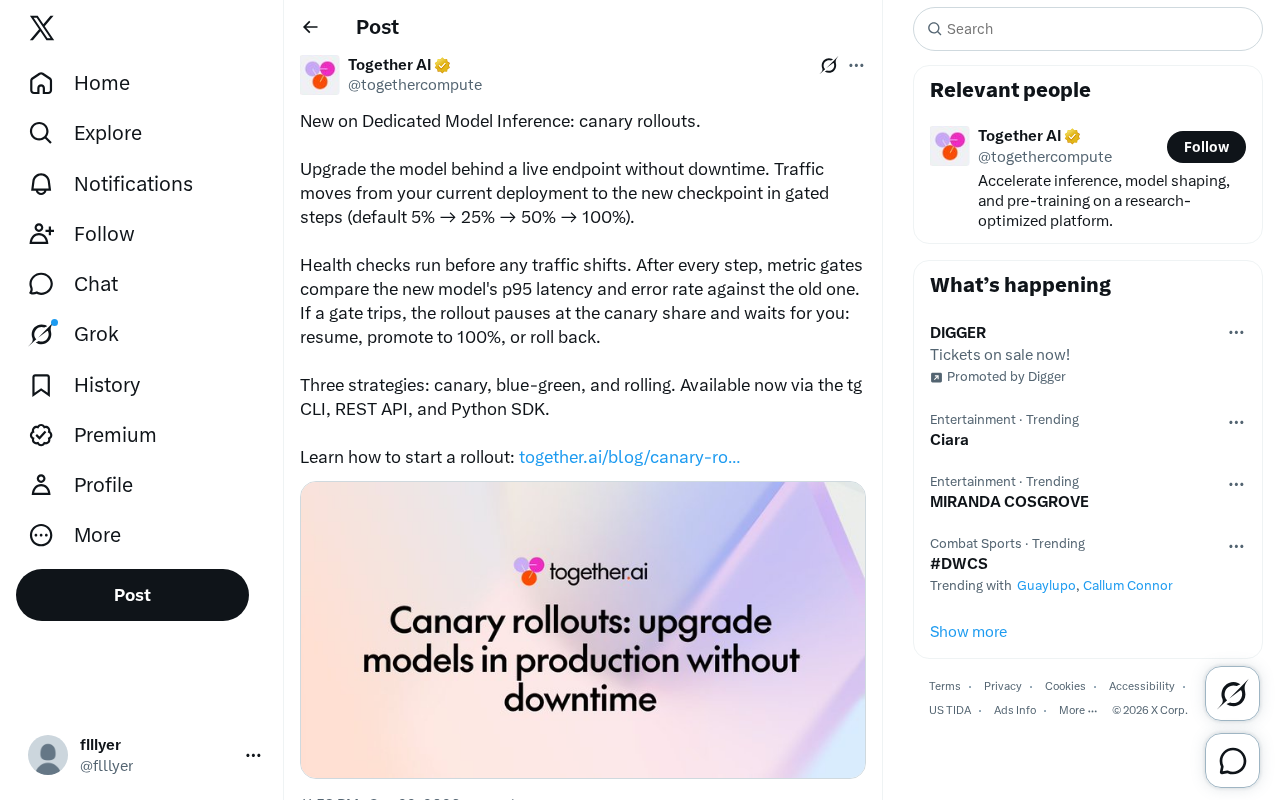
专用模型推理服务推出金丝雀发布能力,允许开发者在不中断线上服务的情况下渐进式替换模型版本。流量默认按5%→25%→50%→100%四步迁移,每步前后分别进行健康检查与指标门控,系统自动对比新旧模型的p95延迟和错误率。若指标门控触发,流程不会自动回滚,而是暂停在当前流量比例,等待工程师选择继续、全量提升或回滚。此外,服务还提供蓝绿部署和滚动发布两种策略,并已支持tg CLI、REST API和Python SDK三种接入方式。该能力将模型发布从高风险的一次性操作转变为可观测、可控制的工程流程,借鉴传统软件的渐进式交付理念,以延迟与错误率作为AI推理服务的核心评估维度。
专用模型推理(Dedicated Model Inference)服务新增了金丝雀发布(Canary Rollouts)能力,让开发者可以在不中断线上服务的前提下,替换实时端点背后的模型版本。这一功能填补了生产环境模型迭代中一个长期存在的痛点——升级模型往往意味着短暂的服务中断或潜在的质量回退风险。
什么是金丝雀发布
金丝雀发布是一种渐进式部署策略,核心思路是先将一小部分流量导向新版本,观察其表现,确认稳定后再逐步扩大范围,最终完成全量切换。这个概念源自矿工用金丝雀检测瓦斯的典故——用少量风险暴露来提前发现问题。
在模型推理场景下,这意味着你不必一次性把所有请求都交给未经生产验证的新模型。按照官方给出的默认配置,流量会分四步逐级迁移:5% → 25% → 50% → 100%。每一步都是一道关卡,只有前一阶段表现达标,才会放行更多流量。
健康检查与指标门控
这套机制真正的价值不在于"分批放流量",而在于每一步之间的自动化把关。
在任何流量迁移开始之前,系统会先运行健康检查(health checks),确保新的模型检查点(checkpoint)已经正常就绪。而在每一个流量迁移步骤之后,指标门控(metric gates)会把新模型的表现与旧模型进行对比,重点比较两个关键指标:p95 延迟和错误率。
选择 p95 延迟而非平均延迟是个值得关注的细节。平均值容易被大量正常请求稀释,掩盖尾部延迟恶化;而 p95 更能反映真实用户体验中"最慢的那批请求"是否可接受。这说明该功能在设计上考虑了生产环境的实际质量诉求,而不只是走个流程。
门控触发后的人工介入
如果某道指标门控被触发——也就是新模型在延迟或错误率上明显劣于旧模型——发布流程不会自动回滚,也不会强行推进,而是暂停在当前的金丝雀流量比例上,等待你来决策。
此时开发者有三个选择:
- Resume(恢复):继续按计划推进后续步骤;
- Promote(提升至 100%):确认新模型无碍,直接完成全量切换;
- Roll back(回滚):放弃升级,把流量退回旧部署。
这种"暂停并等待人工判断"的设计是一种务实的折中。全自动回滚在某些边界情况下可能过于激进,而这套流程把最终决定权交还给了对业务上下文更了解的工程师,同时又通过自动门控避免了问题在无人察觉时全量扩散。
三种部署策略与接入方式
除了金丝雀发布,该服务还同时提供另外两种部署策略:
- Canary(金丝雀):渐进式流量迁移,适合需要审慎验证的关键升级;
- Blue-green(蓝绿部署):新旧两套环境并存,切换时整体倒换流量,回滚快速;
- Rolling(滚动发布):分批替换底层实例,兼顾资源利用与平滑过渡。
三种策略覆盖了从"极度谨慎"到"快速切换"的不同风险偏好,开发者可以根据模型变更的影响面来选择。
在接入方式上,这些能力目前已经可以通过 tg CLI 命令行工具、REST API 以及 Python SDK 三种途径使用,基本覆盖了从脚本自动化到程序化集成的主流场景。
蓝绿部署与滚动发布在传统软件工程中已广泛应用,理解其差异有助于在 AI 推理场景中做出合理选择。蓝绿部署维护两套完整的生产环境("蓝"为当前版本,"绿"为新版本),通过负载均衡器在两者之间切换流量,优点是回滚只需拨回开关,缺点是同时运行两套环境会使资源成本翻倍,对 GPU 密集型的模型推理服务尤为显著。滚动发布则逐批替换底层实例,始终保持服务在线,资源占用相对平稳,但在替换过程中新旧版本会短暂共存,如果模型输出存在不兼容的格式变化,可能对下游系统造成干扰。相比之下,金丝雀发布在三者中对质量退化最为敏感,但也需要最长的迁移窗口期,适合那些对输出质量高度依赖、无法接受静默退化的场景。
对生产化 AI 团队的意义
随着越来越多团队把大模型推理搬进生产环境,模型的持续迭代成为常态:微调出新版本、更换更优的检查点、修复回归问题,都需要频繁地更新线上端点。而在缺乏成熟发布机制的情况下,每次更新都是一场赌博。
金丝雀发布加上自动指标门控,本质上把"发布模型"从一次性、高风险的操作,变成了一个可观测、可控制、可回退的工程流程。它借鉴的是传统软件工程中已经成熟的渐进式交付理念,只是把评估维度换成了更贴合 AI 推理服务的延迟与错误率指标。
对于追求稳定性的生产化 AI 团队而言,这类基础设施能力的完善,往往比模型本身多几个百分点的效果提升更能影响长期的可靠性。
值得注意的是,模型推理的发布挑战与传统软件部署存在一些独特差异:代码服务的正确性往往可以通过单元测试或集成测试预先验证,而模型的输出质量是概率性的,只有在真实流量分布下才能充分暴露问题;此外,GPU 实例的冷启动时间较长,健康检查的等待成本远高于普通 Web 服务。这些特性使得"先小流量验证、异常时人工介入"的金丝雀模式比全自动化回滚更适合当前阶段的 AI 推理场景——自动化工具负责采集信号和触发暂停,但最终的上下文判断仍依赖工程师,这是目前生产环境 AI 系统治理中一种务实且常见的人机协作模式。
相关推荐
Anthropic上市:AI泡沫还是买入机会?
Anthropic在纳斯达克上市,开盘价较发行价高出约三分之一,市场给出两万亿美元级别的隐含估值。拆解813亿美元募资、1.5万亿美元发行估值与两万亿美元市场估值三个数字的差异,分析Claude业务增长与5.67亿美元季度营业亏损并存的基本面,并给出下一份财报该关注的检查清单。
FBI的AI黑客警告,为何系于微软一句话
FBI公告称AI工具Artex攻击超2250家组织,但引用链显示该数字源自微软报告中"尝试登录"的表述。尝试与成功入侵之间的差距,揭示了这场AI驱动攻击的真实规模与日志证据的局限。
Fable 5.2 助攻:浏览器里的月球火星探索游戏 Getsumen Express 诞生记
开发者利用 Fable 5.2 平台打造浏览器游戏《Getsumen Express》,玩家可探索月球火星、扫描真实地标、射击外星人并乘坐星际列车。游戏基于 Three.js 与 WebGPU 开发,成本约 730 美元,展示了 AI 辅助开发的潜力。